Claude Sonnet 5.5 发布:一半价格追平 Opus 5.5,"思考力度"改成用户自己调
发布日期:2026-09-29
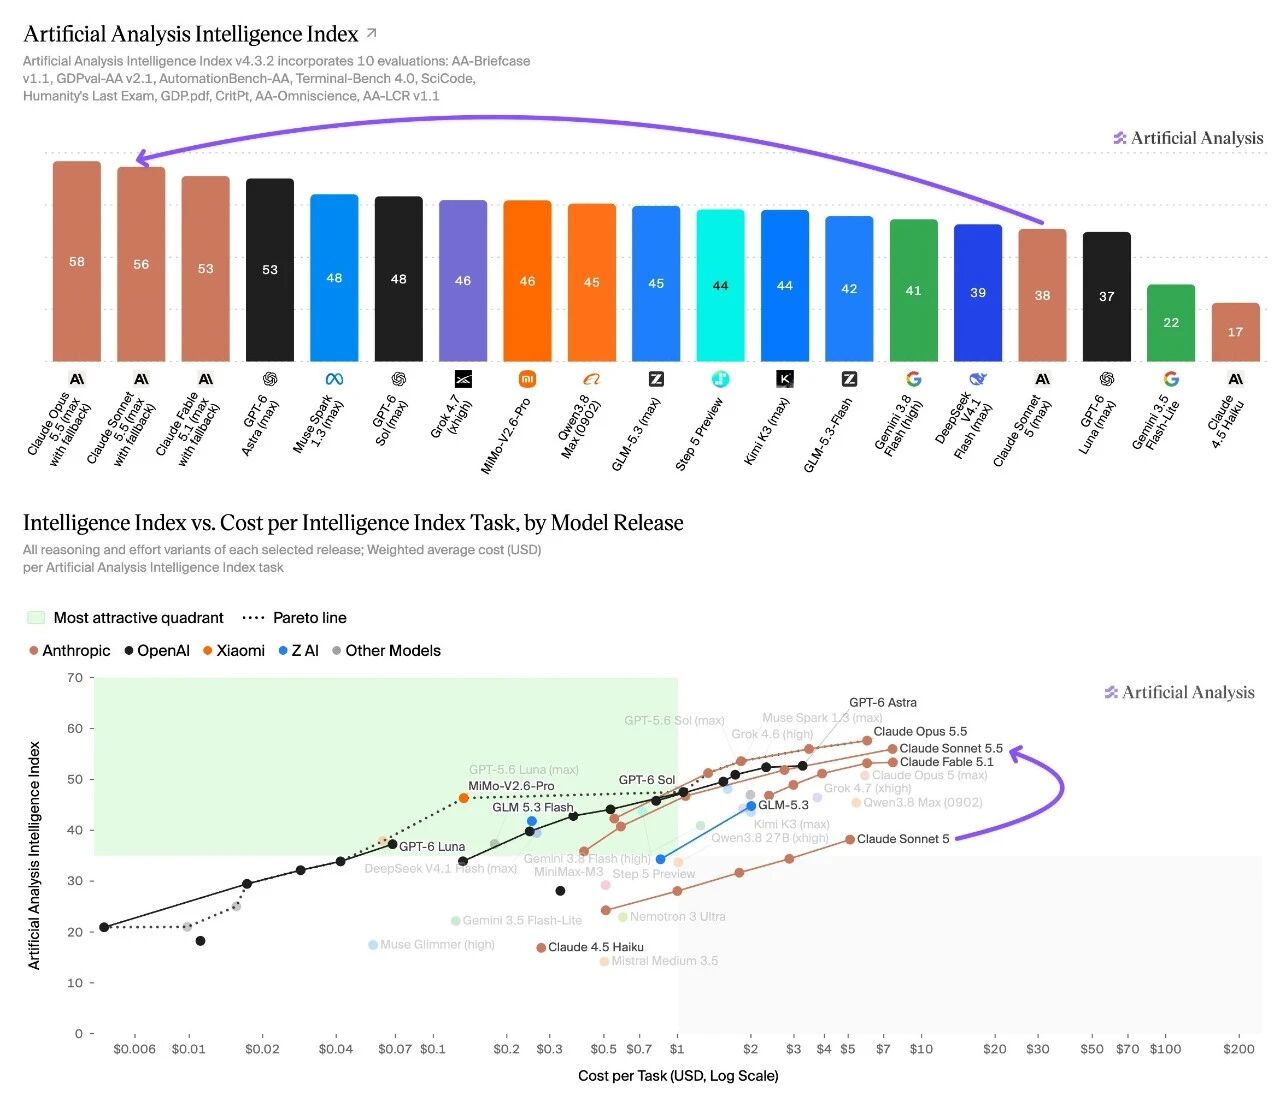
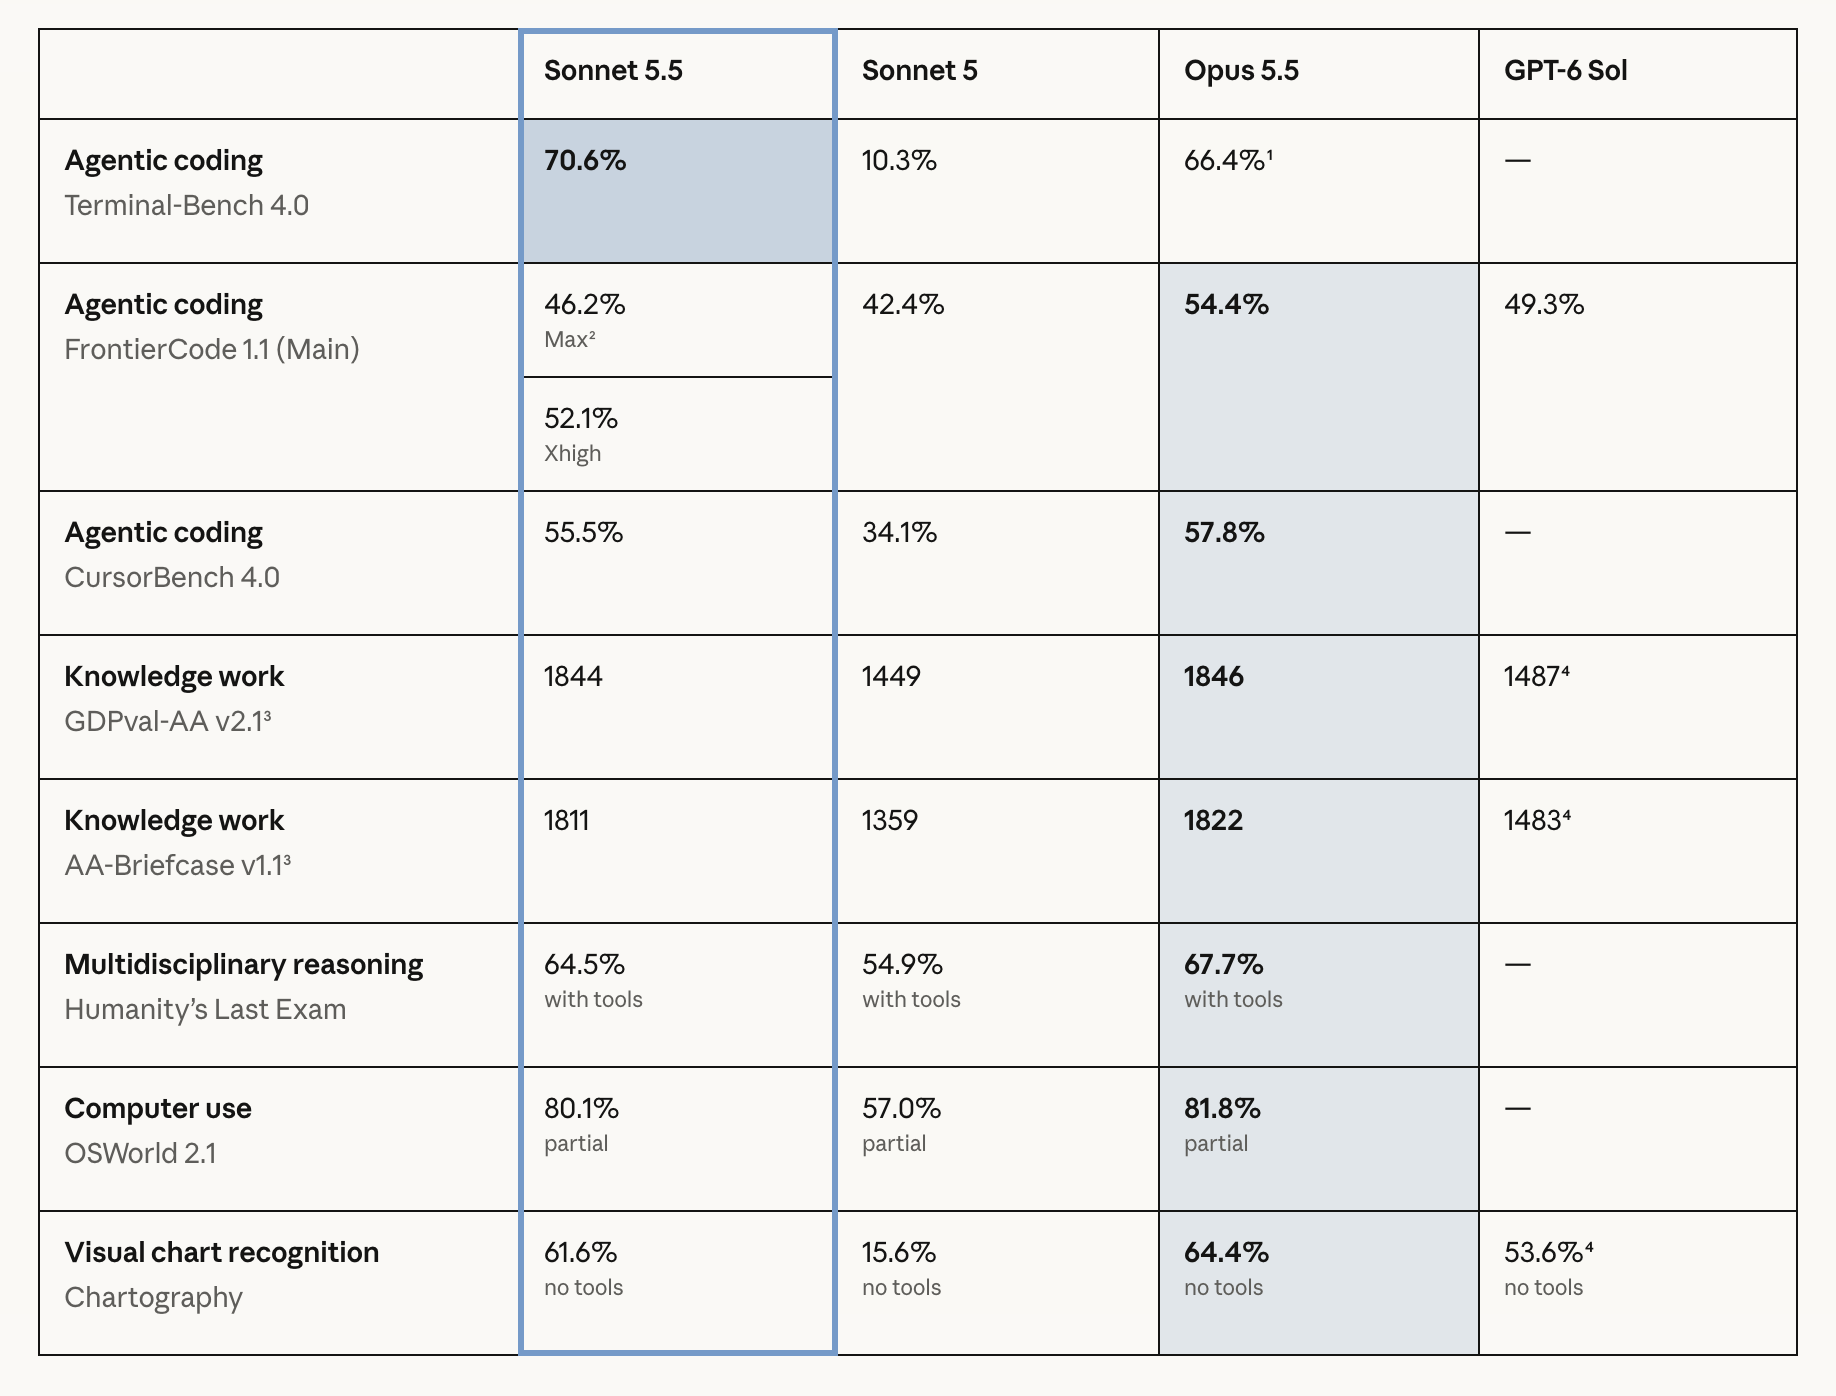
Anthropic 于 2026 年 9 月 28 日发布 Claude Sonnet 5.5,这是继 9 月 22 日 Claude Opus 5.5 之后 Claude 5.5 系列的第二款模型,官方定位它为"相比 Sonnet 5 的一次明确升级":运行速度提升 30% 以上,多数工作的完成成本最高降低 30%,定价维持每百万 token 输入 2 美元、输出 10 美元不变,仅为 Opus 5.5 的一半。它在 Terminal-Bench 4.0 上开到 Max 思考档位时拿到 70.6% 的成绩,反超了 Opus 5.5 在同一测试上 66.4% 的最高分,这也是 Sonnet 系列历史上第一次在公开基准上反超同代 Opus。本文梳理这次发布的核心数据、新引入的"思考力度"分档机制,以及它和 Opus 5.5 的分工逻辑。
发布当天官方给出的核心数字
Anthropic 官方公告的原话是"a clear upgrade over Sonnet 5 that runs 30% faster and costs up to 30% less for most work"。落到具体数字上:
价格没变、速度和效率却明显提升,官方给出的解释是"减少完成任务所需的 Token 数量",而不是简单调低单价——有开发者实测对比同一个渲染任务(如生成一段动画效果的 HTML 代码),Sonnet 5.5 消耗的 Token 数比 Sonnet 5 少了一成左右,这种"更少 Token 走完同样流程"的效率提升,是它把成本压低 30% 的主要来源。
另外几个容易被忽略的规格变化:上下文窗口原生支持到 100 万 token,不再需要额外的 beta 请求头;单次最大输出为 12.8 万 token,通过 Message Batches API 调用时上限可以到 30 万 token;知识截止日期更新到 2026 年 6 月;可缓存的最小提示长度也从原来的 1024 token 降到了 512 token,意味着更短的提示词片段也能享受到缓存带来的成本优势。
"思考力度":把决定权从模型手里交给用户
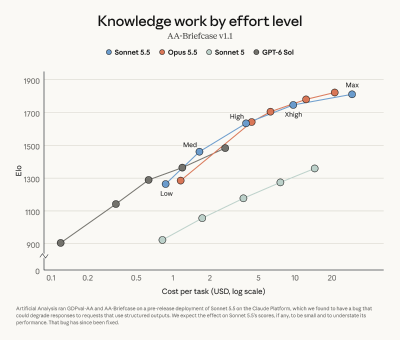
Sonnet 5.5 最值得关注的新机制是把原来隐藏在模型内部的推理深度,变成了一个用户可见、可调节的分档设置。多篇发布解读文章把这个新旋钮称为"思考力度"(thinking effort),分为从 Low 到 Max 的五档:
档位越低:回答更快、消耗的 token 更少,适合日常修 bug、写文档这类边界清楚的任务;
档位越高:模型思考更久、检查更仔细,单次成本也随之上升,适合需要更高准确率的复杂任务。
不同产品线的默认档位并不一样:Claude Code 和 Claude 网页应用默认使用 Medium 档位,而 Claude 开发者平台(API)默认使用 High 档位。值得注意的是,档位也不是越高越好——在 FrontierCode 这类测试里,有报告显示 Xhigh 档位拿到 52.1%,但 Max 档位反而降到 46.2%,原因是模型在更高档位下会更频繁调用 Claude Code 内置的代码审查 Skill,导致改动范围超出预期或触发超时。这说明"思考力度"更像是一个需要按任务类型摸索的调优参数,而不是无脑拉满就能拿到最好结果的开关。
原本用来关闭思考功能的用户需要注意迁移:Sonnet 5.5 默认开启思考(adaptive thinking),原来的 thinking: {"type": "disabled"} 写法会直接返回 400 错误,官方文档明确写道 Sonnet 5.5 会默认思考,所以接口返回的内容里第一个 block 很可能是 thinking 类型,如果代码里习惯直接读取 content[0].text,升级后需要按 block 类型遍历,而不是假设第一块就是正文。另外 tool_choice 的 any/tool 取值也会返回 400,需要改成 auto 并搭配 strict: true;计算机操作(computer use)相关调用则需要迁移到新的工具集 computer_toolset_20260801。这些都是从 Sonnet 5 升级时容易踩到的接口层面变化,而不只是模型效果的差异。
在 Claude Code 里,从 v2.1.284 版本起,sonnet 这个别名已经指向 Sonnet 5.5,默认以 Medium 档位运行,且无法在 Claude Code 内关闭思考功能;不过 Claude Code 的默认模型仍然是 Opus 5.5,需要手动执行 /model sonnet 才能切换过去。
和 Opus 5.5 怎么分工,什么时候该选哪个
Anthropic 给两款模型的定位说得很直接:Opus 5.5 负责需要持续判断的复杂开放任务,Sonnet 5.5 更擅长边界清楚的日常任务,比如修 bug、整理文档、做幻灯片和表格。
这个分工在价格和分数上也有印证:
在较低思考档位下,Sonnet 5.5 与 Opus 5.5 配合成本最低,适合大批量的日常请求;
开到高档位后,Sonnet 5.5 能在部分基准(如 Terminal-Bench 4.0、AutomationBench、HealthBench)上"以相近的成本拿到相近甚至更高的分数",这也是它在 Terminal-Bench 4.0 上反超 Opus 5.5 的具体场景。
换句话说,Sonnet 5.5 不是"弱化版 Opus",而是在特定任务类型和思考档位组合下,能达到接近甚至超过旗舰模型的效果,同时维持旗舰模型一半的单价。
安全性与平台可用性
这是第一个配备网络安全防护的 Sonnet 版本:官方说明,遇到高风险的网络安全相关任务时,请求会被转回 Sonnet 5 处理,而不是由 Sonnet 5.5 直接执行。同时它延续了 Opus 5.5、Sonnet 5 的零数据留存(zero data retention)支持。
发布当天,Sonnet 5.5 已经在包括 AWS、Google Cloud、Microsoft Azure 在内的所有主流云平台同步上线,API 调用的模型标识符为 claude-sonnet-5-5。在 Sonnet 5.5 正式发布前一天,已有开发者在 X 平台上发现这个标识符出现在配置文件里,并在 Claude Code 中进入灰度测试阶段——这类"泄露"消息在发布前反而成了预告,和 Opus 5.5 发布时官方"预告 Sonnet 5.5、Haiku 5.5 未来几周内推出"的说法互相印证。
常见问题
Q:Sonnet 5.5 比 Sonnet 5 贵吗?
不贵。官方定价维持每百万 token 输入 2 美元、输出 10 美元不变,和 Sonnet 5 完全一样。它的"降本"体现在完成同一任务消耗的 Token 更少,而不是单价下调,这也是官方所说"最多降低 30% 成本"的真实来源。
Q:Sonnet 5.5 和 GPT-6 Sol、GPT-6 Astra 相比表现如何?
发布初期流传的对比多来自第三方实测和网友爆料,例如声称"暴打 GPT-6 Sol、直逼 Astra"的说法,这类跨厂商对比缺乏统一测试条件,应作为社区观察而非官方结论看待。相对可靠的是 Anthropic 官方公布的自家跨代对比数据(Sonnet 5.5 对比 Sonnet 5、Opus 5.5),具体到某个第三方模型的横向排名,建议以各自官方发布的 benchmark 报告为准。
Q:"思考力度"档位要怎么选,是不是开到 Max 最好?
不是。FrontierCode 测试里出现过 Max 档位分数反而低于 Xhigh 档位的情况,原因是更高档位会更频繁触发代码审查类 Skill,导致改动范围失控或超时。日常任务建议从默认档位(Claude Code/网页端 Medium,API 默认 High)开始,再按实际效果向上或向下微调,而不是默认拉满。
Q:如果我需要同时测试 Sonnet 5.5 和其他厂商的模型该怎么办?
模型更新节奏加快后,横向对比测试的需求也在增加。如果业务本身需要同屏测试多款主流大模型,统一的模型广场类工具能省去逐个申请 API Key 的步骤——例如七牛云 AI 大模型广场支持多模型统一接入和同屏对比,按需切换即可完成横向测试,不需要为每家单独维护账号和密钥。
结语
Claude Sonnet 5.5 的发布节奏和 Opus 5.5 几乎无缝衔接,一周之内 Anthropic 完成了旗舰和主力两款模型的连续更新。这次发布最大的变化不只是分数和速度,而是把"思考多久"这个决定权从模型内部交还给用户——档位选择本身,可能会成为接下来一段时间里评测和实践里讨论最多的话题。本文内容以 Anthropic 官方发布信息及公开报道 2026 年 9 月的信息为准,具体参数和支持范围请以官方文档实际展示为准。
参考资料
Anthropic 官方发布公告:anthropic.com/claude-sonnet-5-5
Anthropic Newsroom:anthropic.com/news
Claude 开发者博客《Building with Claude Sonnet 5.5》:claude.dev/blog/building-with-claude-sonnet-5-5
七牛云 Token Plan 官方页面(deepseek最低1.2折):https://www.qiniu.com/ai/plan