刚刚!GPT-6.1 Sol Ultrafast 上线:速度、价格、API 接入全指南
发布日期:2026-10-09
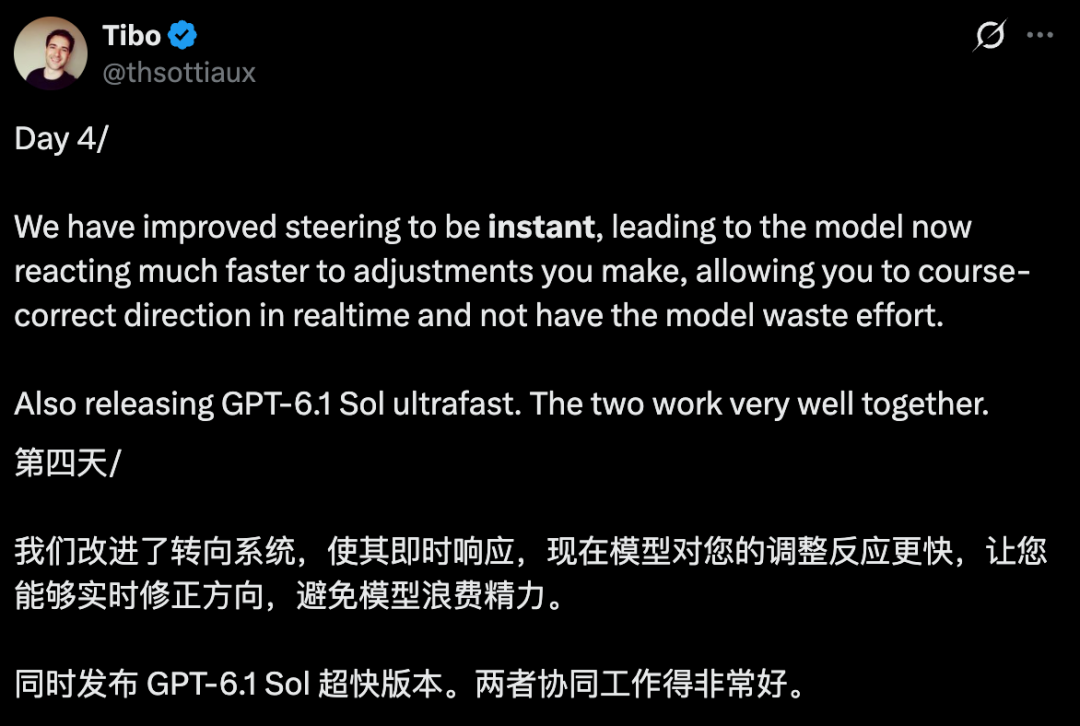
GPT-6.1 Sol Ultrafast 是 OpenAI 在 2026 年 10 月 8 日为 GPT-6.1 Sol Responses API 开放的最快服务层,用 service_tier: "ultrafast" 换取更短的生成间隔,同时按标准价格的 6 倍计费。GPT-6.1 Sol 模型本身已于 2026 年 9 月 29 日上线,定位是以较低成本提供接近 GPT-6 Astra 的复杂编码、计算机操作和专业工作能力。Ultrafast 面向所有 API 用户开放,但受独立速率限制约束。
GPT-6.1 Sol 和 Ultrafast 是两件事
GPT-6.1 Sol 是模型,Ultrafast 是 API 服务层,二者的发布时间和作用不同。
OpenAI API 更新日志显示,GPT-6.1 Sol 于 2026 年 9 月 29 日以 gpt-6.1-sol 模型 ID 发布,面向复杂编码和专业工作,并支持 Responses API 与 Chat Completions API。10 月 8 日新增的 Ultrafast 则只改变 Responses API 的处理层,调用时仍使用同一个模型 ID。
这一区分很重要:把请求从 Standard 切到 Ultrafast,不会把 GPT-6.1 Sol 变成另一个模型,也不会自动改变上下文窗口、知识截止日期或支持的工具集合。
Ultrafast 到底快在哪里
Ultrafast 的官方定义是减少生成输出 Token 之间的等待时间,而不是承诺所有请求的固定首字延迟或固定总耗时。
OpenAI 的 Ultrafast 文档把它描述为 API 中最快的服务层,并建议高频工具调用的 Agent 使用 WebSocket,以减少每次 HTTP 往返带来的网络开销。HTTP 请求仍然支持 Ultrafast,但持久连接更适合连续发送多个响应请求和工具结果。
对用户可感知的差异,主要有三层:
生成间隔:模型开始输出后,连续 Token 之间的等待时间目标更短。
连接方式:WebSocket 可复用连接,适合多轮 Agent 和密集工具调用;HTTP 适合单次或低频请求。
业务结果:端到端耗时仍会受到排队、输入长度、工具执行、网络和客户端渲染影响。
因此,适合用 Ultrafast 衡量的指标应包括首个可见 Token 时间、Token 间隔、端到端完成时间和工具调用间隔,而不是只记录 API 请求从发出到结束的总时长。
价格为什么看起来很高
GPT-6.1 Sol Ultrafast 的短上下文文本 Token 价格是 Standard 的 6 倍,且长上下文会在更高基准上继续计费。
OpenAI 2026 年 10 月定价表以每百万 Token 为单位列出以下价格:
表中的价格是模型 Token 费用,不包括 Web Search、File Search、容器或其他工具可能产生的独立费用。输入超过 272K Token 时,OpenAI 会对整次请求按长上下文价格计算;不能只把超过门槛的那一段按高价估算。
如果一个任务的人工等待成本高、工具链需要连续交互,Ultrafast 的额外费用可能有明确的业务理由。若任务是离线批处理、夜间抽取或可接受排队,Standard、Batch 或 Flex 的成本模型更容易控制,应该用同一批业务样本比较成功任务成本。
如何接入 GPT-6.1 Sol Ultrafast
最小接入变化是在 Responses API 请求中同时设置模型 ID 和服务层。
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    service_tier="ultrafast",
    input="检查这段服务代码的并发问题,并给出最小修改方案。",
)

print(response.output_text)
OpenAI 文档还提供了 WebSocket 模式。多轮请求应复用同一连接,并通过 previous_response_id 传递上一轮响应;这样可以减少连接建立带来的额外延迟。采用 HTTP 时,只需在现有 Responses API 请求中加入 service_tier 字段。
GPT-6.1 Sol 的工具调用应使用 Responses API。Chat Completions 支持该模型,但官方模型页明确说明不支持带工具调用的 Chat Completions 请求。已有 Chat Completions 应用如果依赖工具、MCP、代码执行或计算机操作,应先按 Responses API 迁移指南改造,再评估 Ultrafast。
速率限制怎么理解
Ultrafast 使用独立于 Standard 和 Fast 的速率限制。官方文档列出的默认 Ultrafast TPM 为:Build 100 万、Launch 400 万、Grow 4000 万。这里的 TPM 是每分钟 Token 上限,不是并发请求数,也不是服务保证的响应速度;突发流量仍需要队列、退避和预算控制。
上线后应该怎样评估
Ultrafast 是否值得启用,应由业务任务的端到端指标和单位成功成本共同决定。
建议用同一模型、同一提示词、同一工具权限和同一输入集进行 A/B 测试:
固定 Standard 与 Ultrafast 的
reasoning.effort、最大输出和工具配置。同时记录首个可见 Token 时间、Token 间隔、端到端时延、工具等待时间和失败率。
按短上下文与超过 272K 输入两组分别统计,避免长上下文样本稀释价格差异。
用“完成一个合格任务”的总费用比较,而不是只比较每次请求的 Token 价格。
对 WebSocket 场景额外记录连接复用率、断线重连、重复工具调用和幂等性问题。
GPT-6.1 Sol 的模型发布与 Ultrafast 服务层上线,分别解决能力选型和响应速度问题。官方资料确认,Ultrafast 已向所有 API 用户开放,价格为 Standard 的 6 倍;它仍受独立速率限制和工具费用影响。本文数据截至 2026 年 10 月 9 日,来源见文末参考资料。
参考资料
OpenAI API 更新日志:developers.openai.com/api/docs/changelog
OpenAI:GPT-6.1 Sol 模型文档:developers.openai.com/api/docs/models/gpt-6.1-sol
OpenAI:Ultrafast mode:developers.openai.com/api/docs/guides/ultrafast-mode
OpenAI:API 定价:developers.openai.com/api/docs/pricing?latest-pricing=ultrafast
OpenAI:GPT-6 模型选择指南:developers.openai.com/api/docs/guides/model-selection