DeepSeek V4.1 Flash 各平台定价全拆解:同一模型,成本差距为何超 3 倍
发布日期:2026-10-29 | 数据截至 2026-10-29,来源为各平台官方定价页及 Artificial Analysis v5.0
DeepSeek V4.1 Flash(含 2026 年 10 月 17 日更新的 V4.1-Flash-1017 版本)是目前 OpenRouter 周榜连续三周第一、单周调用量超 32.8 万亿 Token 的主力模型,官方定价为闲时 ¥1/M 输入、¥4/M 输出,但同一模型在国内不同平台的实际费用差距可达 3 倍以上。本文基于各平台官方定价页,整理了官方直连、硅基流动、火山引擎方舟、七牛云大模型广场、七牛云 Token Plan 五个主要接入渠道的价格结构,并说明分时计费、缓存命中折扣与订阅制积分体系的实际换算方式,帮助开发者和企业团队在接入前算清成本。
DeepSeek V4.1 Flash 是什么,定价体系怎么读
DeepSeek V4.1 Flash 是深度求索于 2026 年 9 月 10 日发布、10 月 17 日完成版本迭代的轻量旗舰模型,采用非对称 CED(因果编码器-解码器)MoE 架构,总参数 552B,处理输入时激活约 80 亿参数、生成输出时激活约 160 亿参数,支持 100 万 token 上下文,MIT 协议开源。
理解它的定价,需要区分三个维度:
分时计费:几乎所有平台(包括官方)都将一天切分为高峰和闲时两段,闲时价格通常是高峰的一半。官方定义的高峰时段为工作日北京时间 9:00–12:00 及 14:00–18:00,其余时间(含周末和节假日全天)为闲时。
缓存命中折扣:当请求中的 prompt 与近期历史请求高度重叠时,命中缓存部分按极低价格计费(官方闲时 ¥0.02/M,约为正常输入价格的 2%)。对于有固定系统提示词或重复上下文的批量任务,缓存命中率直接决定实际成本。
输出相对昂贵:各平台输出价格均为输入的 4 倍,这意味着输出 token 多的任务(生成长文、翻译、逐字回复)成本显著高于摘要提取、分类、打标签等输出短的任务。
各平台价格对比表(2026-10-29)
说明:以下价格均以人民币计,单位为元/百万 token(¥/M)。分时平台取闲时价格为基准。国际平台 OpenRouter 取 Artificial Analysis 统计的服务商中位数,仅供汇率换算参考。
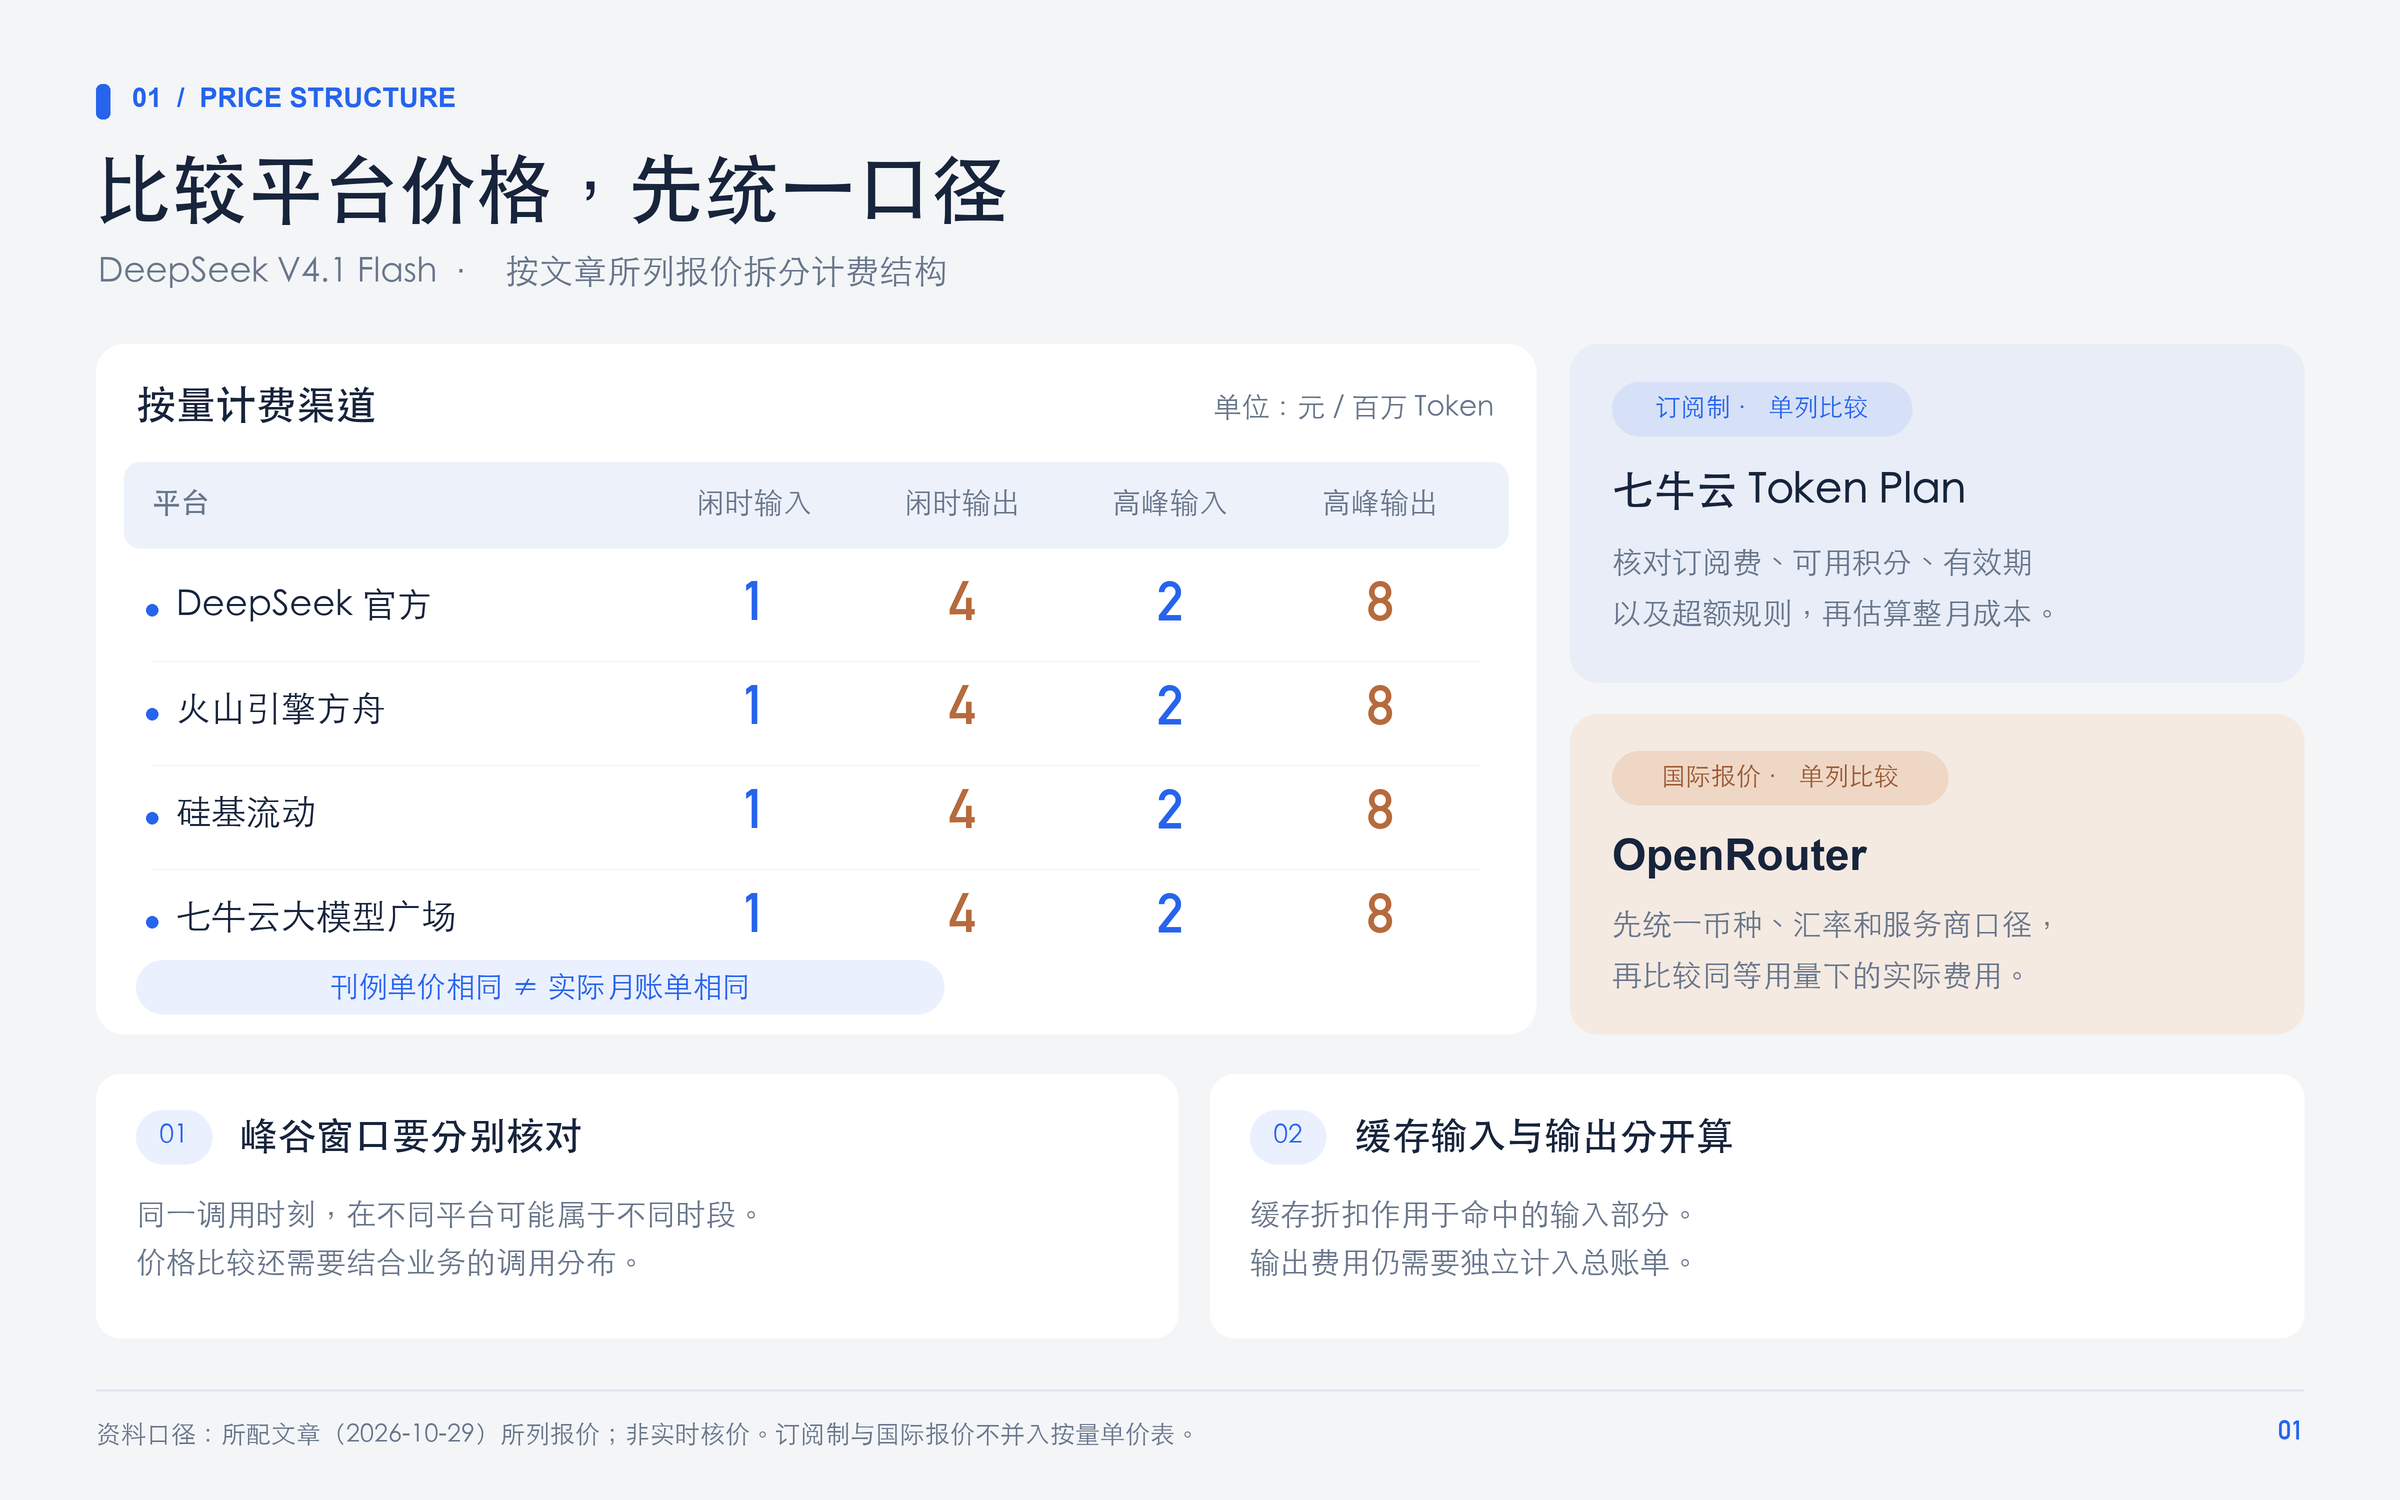
关键结论:国内直连渠道(官方/火山/硅基/七牛云大模型广场)闲时价格高度一致,均为 ¥1/¥4。差距来自两处:一是企业订阅制(Token Plan 类)的折扣叠加,二是国内与 OpenRouter 国际价格之间超过 2 倍的溢价($0.30 vs ¥1,按汇率换算差距约 1.5 倍)。
逐平台详解
DeepSeek 官方
官方 API 是价格基准,所有国内转接平台的刊例价均与此对齐。闲时 ¥1/M 输入、¥4/M 输出,高峰翻倍。2026 年 10 月 19 日起新增 Search 和 Fetch 两个接口,按成功请求次数计费,¥5/千次,与 token 计费独立。
适合场景:价格敏感、有技术能力自建稳定性保障的团队;或用量较小、偶发调用的个人开发者。
注意:官方直连无 SLA 承诺,高峰期偶发限流。2026 年 10 月发布新版本时曾出现排队等待,生产环境建议配置重试和降级策略。
火山引擎方舟
方舟平台与官方定价一致(¥1/¥4 闲时),另有经济版定价约为常规版 80%(闲时 ¥0.80/M 输入、¥3.20/M 输出)。依托字节跳动多可用区云基础设施,SLA 承诺在 99.9% 以上,限流触发后有告警机制。
适合场景:对稳定性有要求、已在字节系生态(抖音、飞书)有集成需求的团队。
硅基流动
硅基流动闲时定义为凌晨 2~8 点(非工作日高峰的逆时段),价格结构与官方一致。支持多模型统一接入,适合有自建调度层、能主动调峰的批处理场景。
适合场景:批量文本处理、爬虫摘要、数据标注等可以安排到凌晨运行的任务。
七牛云大模型广场(按量付费)
七牛云大模型广场提供 DeepSeek V4.1 Flash 的按量付费接入,价格与官方同档(闲时 ¥1/M 输入、¥4/M 输出),支持统一 API Key 管理和用量统计,切换模型只改 Model ID,不需要维护多套账号体系。
适合场景:尚未确定用量、处于测试或小规模上线阶段、需要同时接入多个模型做对比评测的团队。
七牛云 Token Plan(订阅制)
Token Plan 是七牛云面向有稳定用量需求的企业推出的订阅制方案,采用积分统一计量,DeepSeek V4.1 Flash 参与闲时特惠:
订阅折扣:Enterprise S(¥2,999/月)约 7 折,M(¥4,999/月)约 6 折,B(¥9,999/月)约 5 折
闲时叠加(18:00 至次日 08:00):额外 ×0.3 倍率
包年叠加闲时后:等效折扣最低约 1.2 折,即闲时输入等效约 ¥0.12/M、输出约 ¥0.48/M
换言之,同一个 DeepSeek V4.1 Flash 请求,安排在闲时通过 Token Plan 调用,成本可降至官方定价的约 12%。
该方案通过了中国信通院词元服务安全可信专项评测(2026 年 10 月首批),在计费透明和数据安全两个维度有独立第三方核验记录,适合对账单可追溯性和合规凭证有要求的企业客户。
不同使用场景的实际成本估算
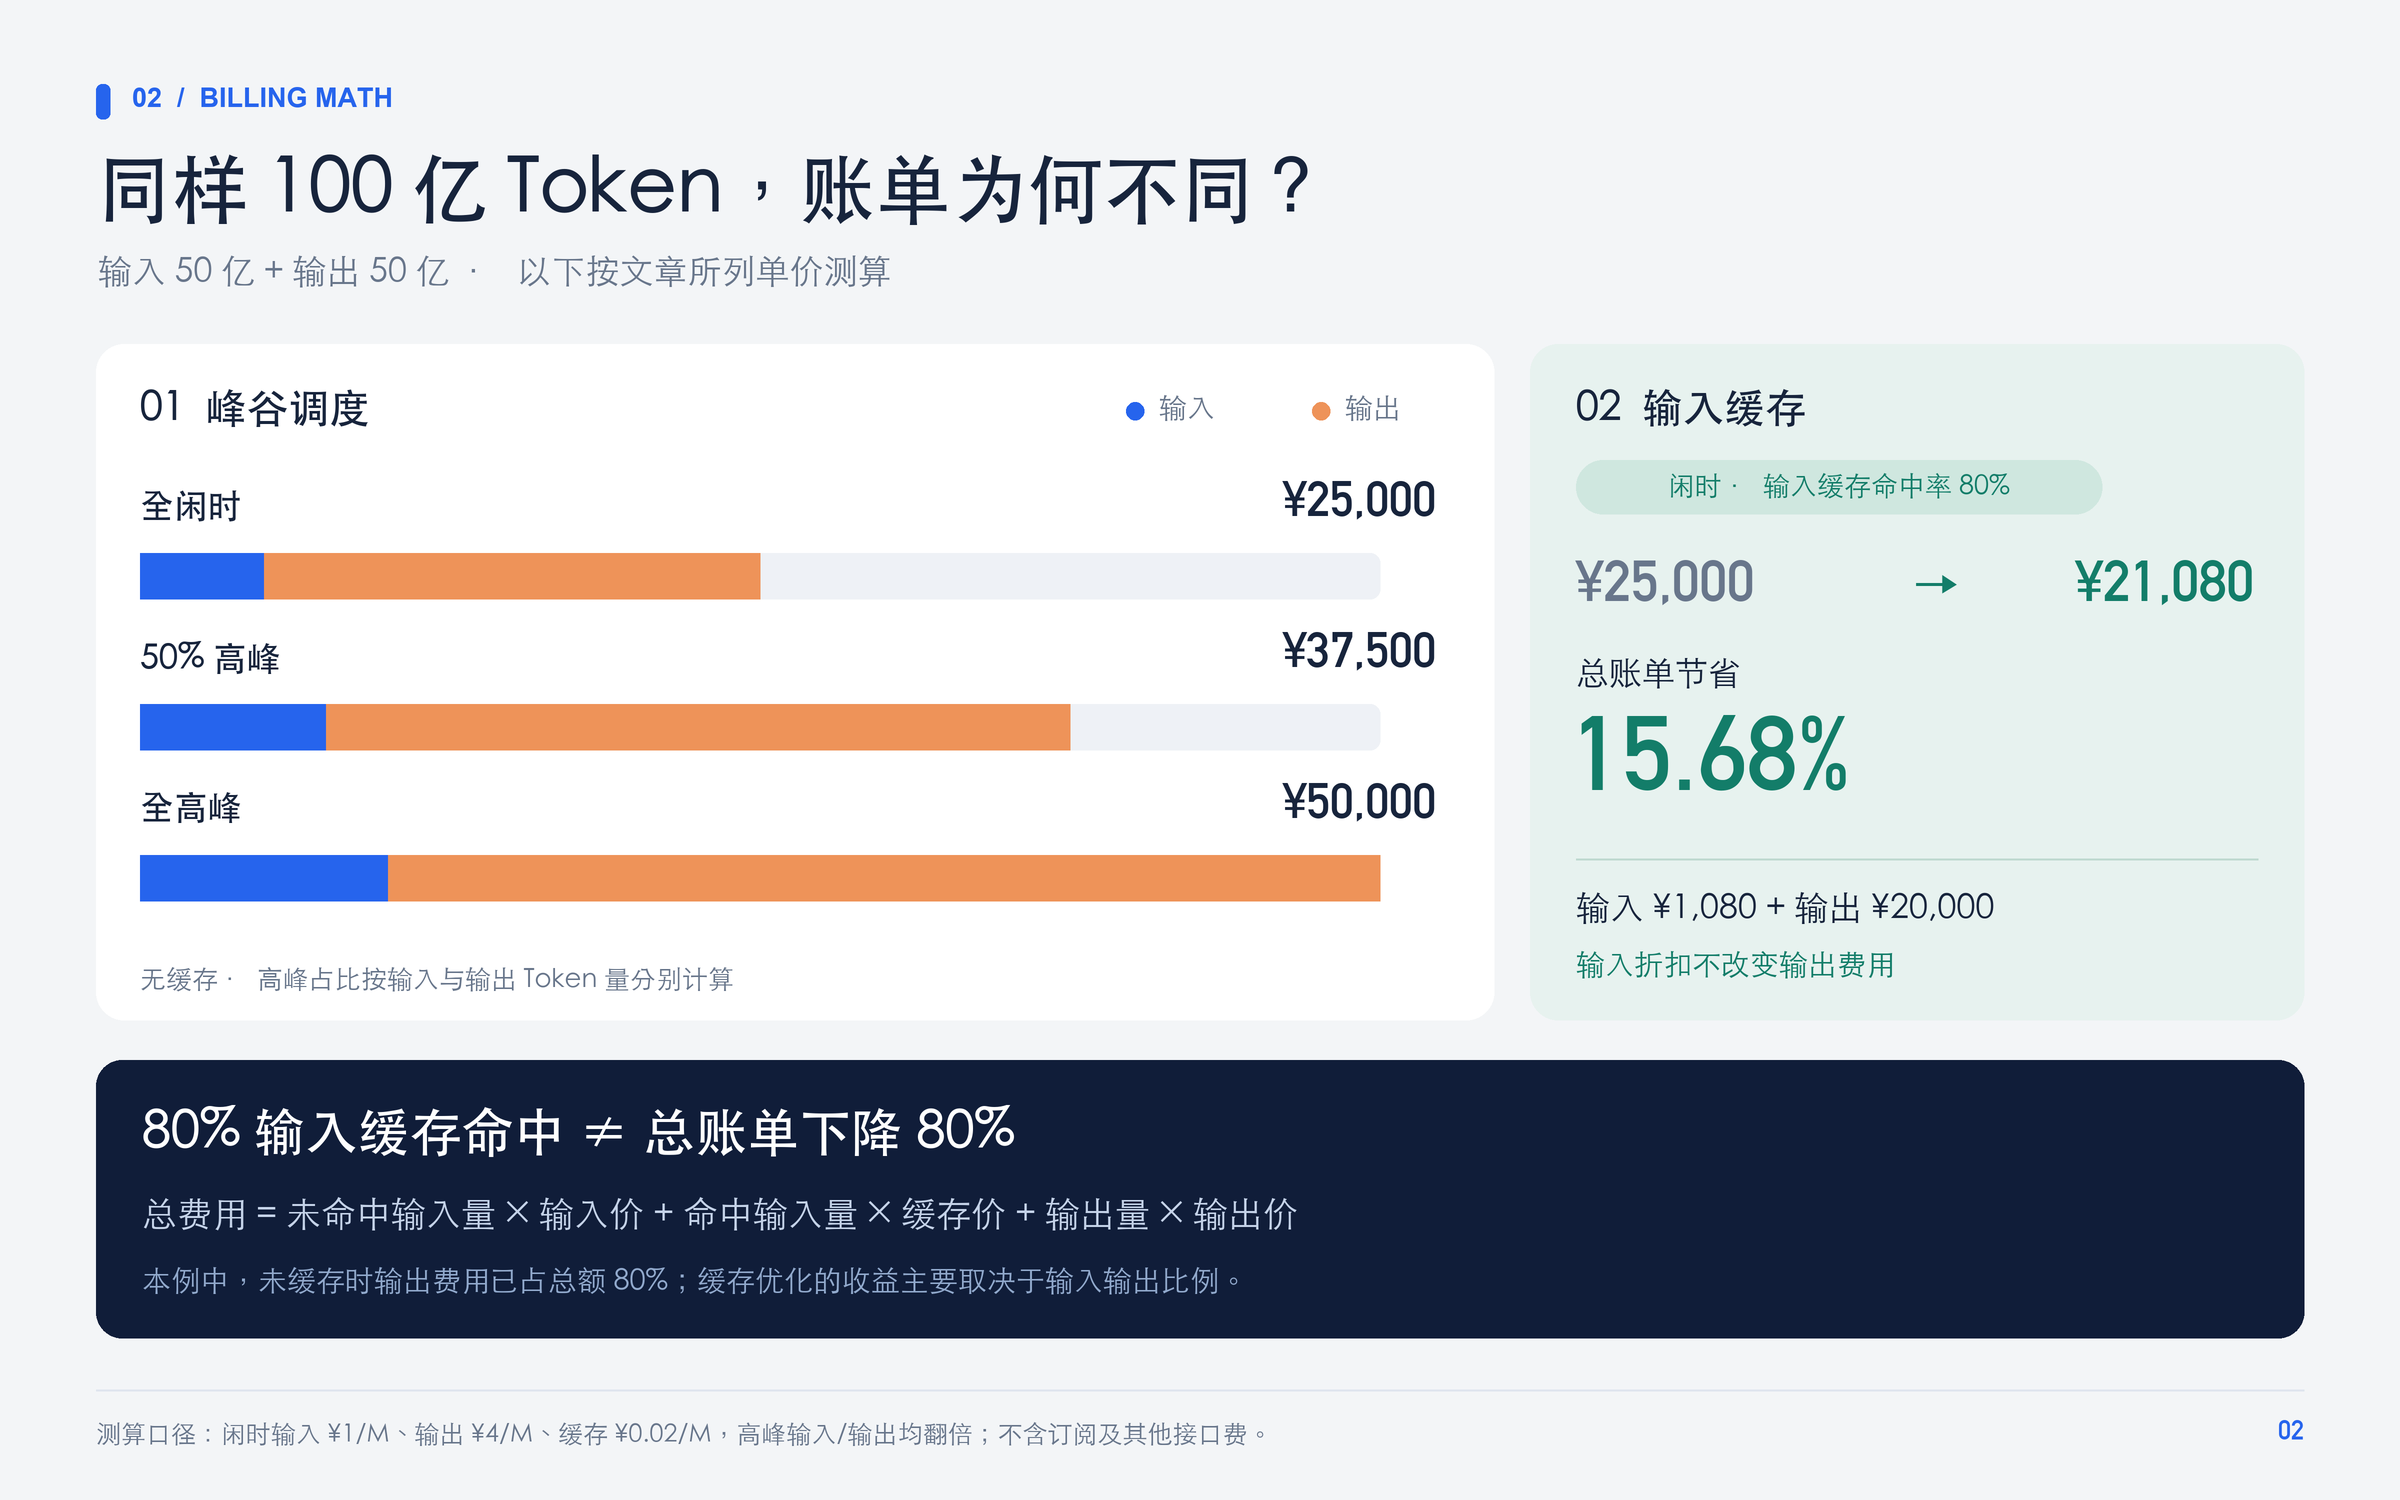
以下以 100 亿 token/月 的用量为基准(输入输出 1:1),在不同平台和时段下的月度成本:
估算基于官方公开定价,实际成本受缓存命中率、输入输出比例、调用分布影响较大,上线前建议用真实业务流量做基准测试。
影响实际成本的三个关键变量
1. 缓存命中率
如果你的请求有固定的系统提示词(system prompt)、知识库内容或重复上下文,缓存命中部分仅 ¥0.02/M(官方闲时),是正常输入价格的 2%。提高缓存命中率是降低输入成本的最高性价比手段,不需要换平台,只需要在工程侧做 prompt 稳定化。
2. 输入输出比
生成长文(输出多)和分类打标签(输出少)的成本差距可达 5~10 倍。如果你的任务以输出为主(如长文生成、全文翻译),输出价格占总成本 80% 以上,选平台时要优先看输出折扣,而非输入折扣。
3. 调用时段分布
将批量任务从高峰迁移到闲时(工作日 12:00–14:00 及 18:00 后、周末全天),成本直接减半,且无需更换平台。对于异步任务(数据处理、报告生成、批量摘要),这是成本优化优先级最高的方向。
选型建议
小团队 / 个人开发者:直接用 DeepSeek 官方 API,按量付费,无最低消费。闲时调用 + 缓存命中是最直接的省钱路径。
有稳定批量用量、希望降本:对比七牛云 Token Plan 的订阅折扣与闲时叠加收益,用自己的月均 token 量估算 ROI,通常月均超 30 亿 token 后订阅制开始有优势。
对稳定性和 SLA 有要求:优先考虑有多可用区基础设施的平台(火山引擎方舟、七牛云);确认 SLA 条款覆盖 API 调用链路全程,而非只覆盖基础设施层。
企业合规采购:如需第三方可信认证凭证,核查平台是否持有中国信通院词元服务安全可信证书或等效 ISO/等保认证。
FAQ
Q:DeepSeek V4.1 Flash 和 V4.1-Flash-1017 是同一个模型吗,价格一样吗? 是同一模型的迭代版本。2026 年 10 月 17 日 DeepSeek 将 V4.1 Flash 更新至 V4.1-Flash-1017,官方网页端、App 和 API 同步切换为新版本,定价维持 ¥1/M 输入、¥4/M 输出(闲时)不变。各国内平台跟进同步后,调用的也是 1017 版本,价格结构不变。
Q:OpenRouter 上 DeepSeek V4.1 Flash 的价格为什么比国内贵? OpenRouter 上的价格(Artificial Analysis 统计中位数约 $0.30/M 输入、$1.20/M 输出)是国际各服务商的综合报价,包含了部分国际服务商的溢价和汇率换算。按汇率约 7.3 折算,$0.30 ≈ ¥2.2,是国内官方闲时 ¥1 的两倍以上。如果业务面向国内,优先走国内渠道。
Q:七牛云大模型广场和 Token Plan 有什么区别,如何选择? 大模型广场是按量付费,适合用量不稳定或测试阶段;Token Plan 是订阅制,每月预付积分,折扣从 5 折到 7 折,叠加闲时特惠后可到 1.2 折。两者底层是同一套 API,切换只改计费方式。月均 token 用量较低时,大模型广场灵活;用量稳定后,Token Plan 单价更低。
Q:缓存命中的条件是什么,可以主动控制吗? 缓存命中通常要求请求的 prefix(前缀部分,如 system prompt)与近期历史请求完全一致。工程侧可以通过固定 system prompt、把知识库内容放在 prompt 最前面、避免每次请求加入时间戳等方式提高命中率。高命中率场景下输入成本可降至正常的 2%。
七牛云 Token Plan(多模型 API 统一接入):https://www.qiniu.com/ai/plan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free