MIT “权重空间编程”:GPT-6 Astra 修改 0.016% 的 Qwen 权重,MATH-500 从 7.9% 升至 48.1%
发布日期:2026-11-03
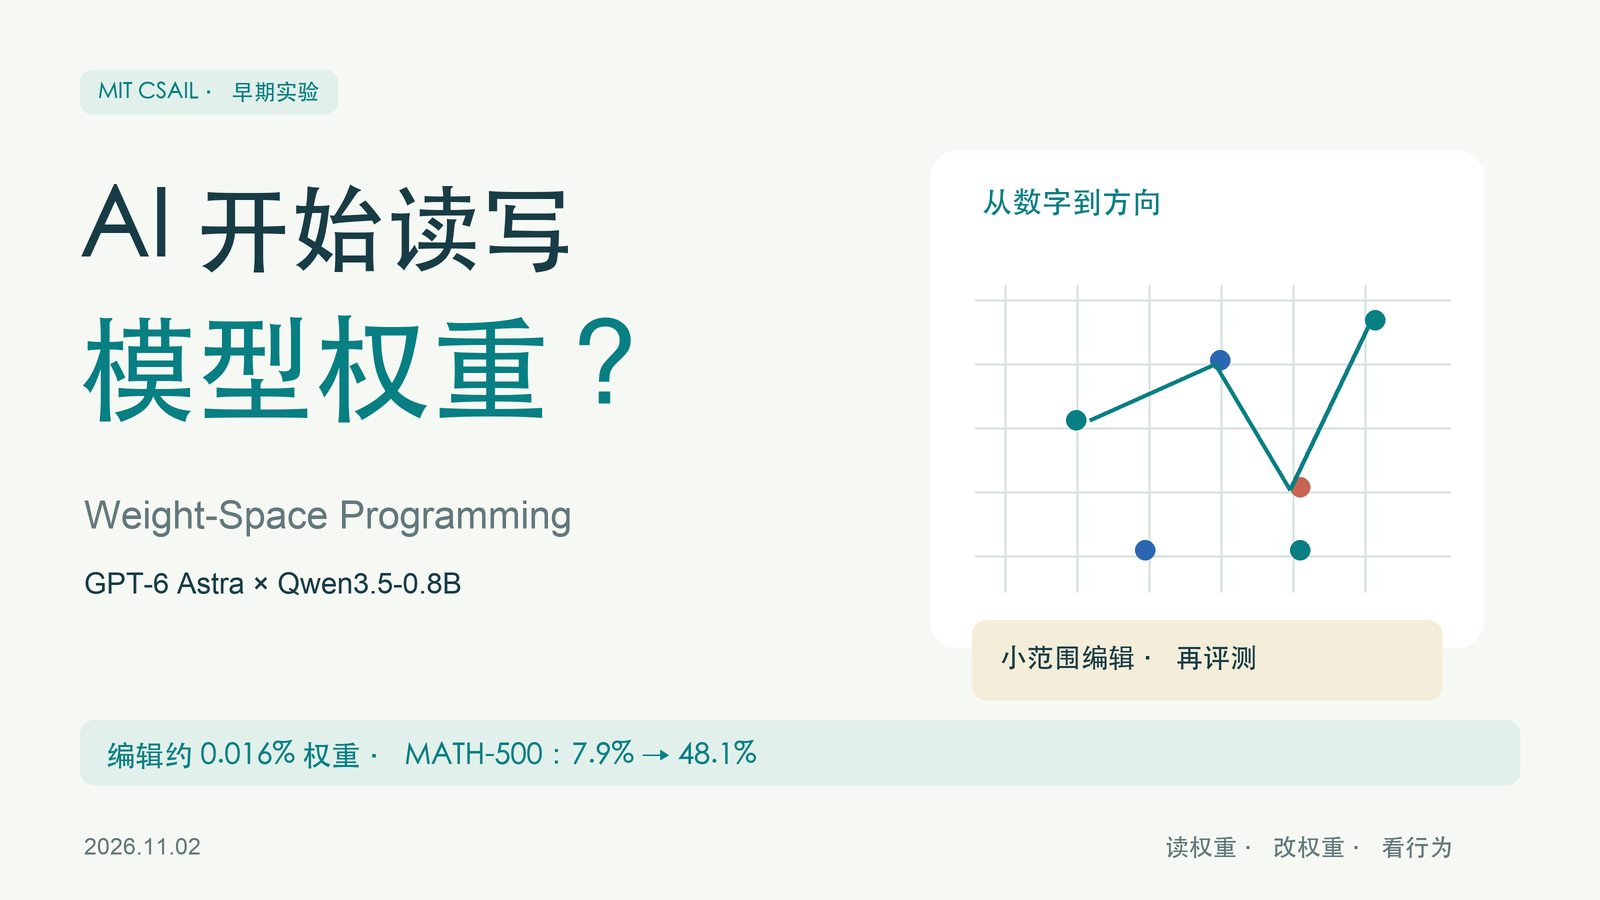
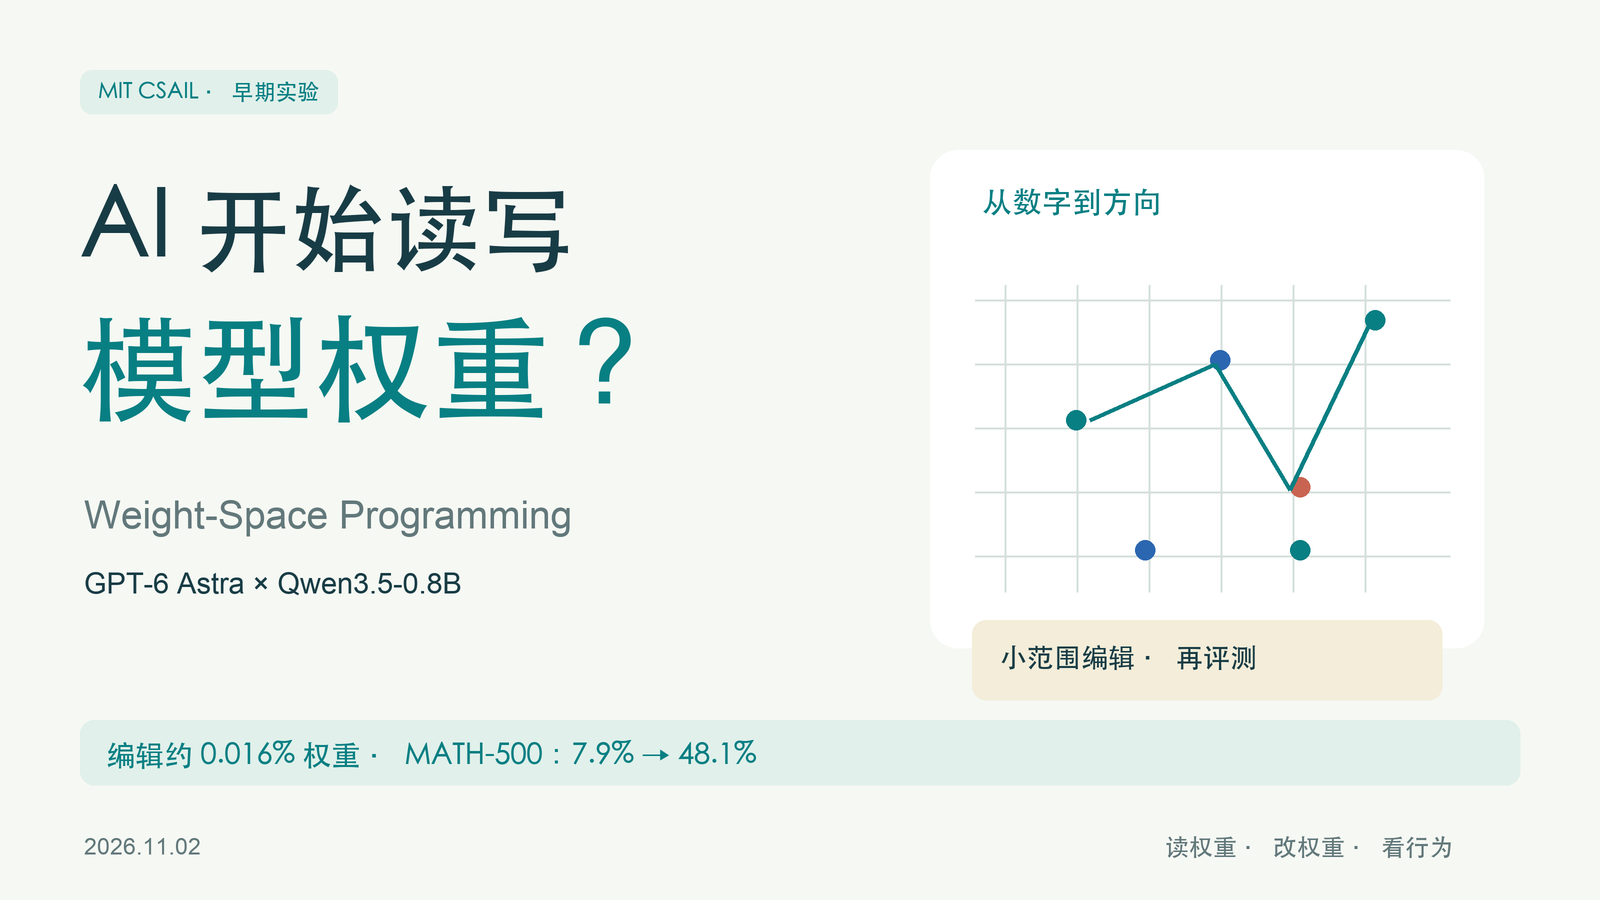
2026 年 11 月 2 日,MIT CSAIL 研究团队在博客中披露了一组早期实验:他们让 GPT-6 Astra 直接读取和写入神经网络权重,不使用梯度下降,也不让模型编写训练循环,并将这种方法称为 Weight-Space Programming(权重空间编程)。在 Qwen3.5-0.8B 实验中,Astra 定位到与推理循环有关的权重方向,只改动约 0.016% 的参数,博客报告 MATH-500 从 7.9% 提升到 48.1%。这是一组特定模型、特定评测设置下的研究结果,不能直接等同于通用的“模型自我训练”。
这次实验到底改变了什么
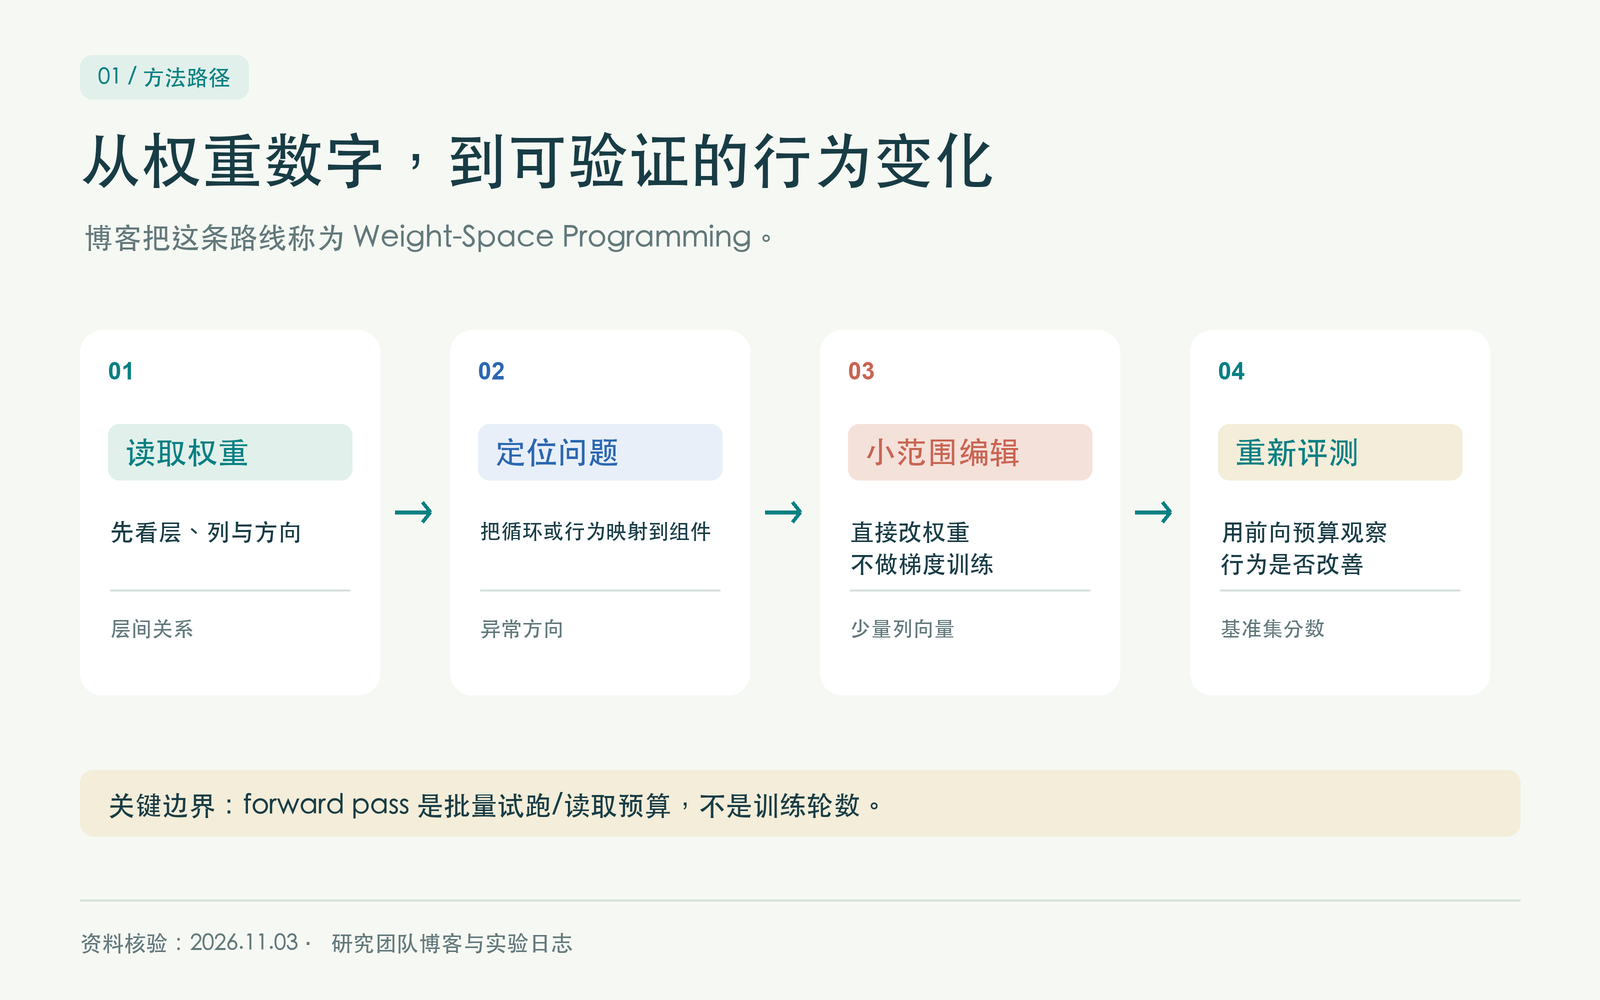
**权重空间编程的核心,是让通用大语言模型围绕自然语言目标直接分析和修改神经网络权重。**传统训练通常由优化器根据损失函数和梯度更新参数,而这组实验把权重、网络结构、任务描述和有限的运行反馈交给 Astra,由它推断某个方向对应的行为,再写回新的权重。
这组实验由 MIT CSAIL 的 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 共同披露。团队在 2026 年 11 月 2 日的博客中强调,这仍是“非常早期”的结果,并同步开放实验日志和编辑后的模型。
这项工作先从小网络开始:Astra 仅凭权重判断策略网络训练过哪款游戏、扩散模型会生成圆形还是三角形,也尝试分析小型语言模型中与复制行为相关的注意力头。研究团队随后把问题推进到“直接写权重”,让 Astra 生成 MinAtar 游戏和围棋网络,并在部分设置下与 PPO 训练网络比较。
Qwen 实验:修复推理循环,而不是凭空发明数学能力
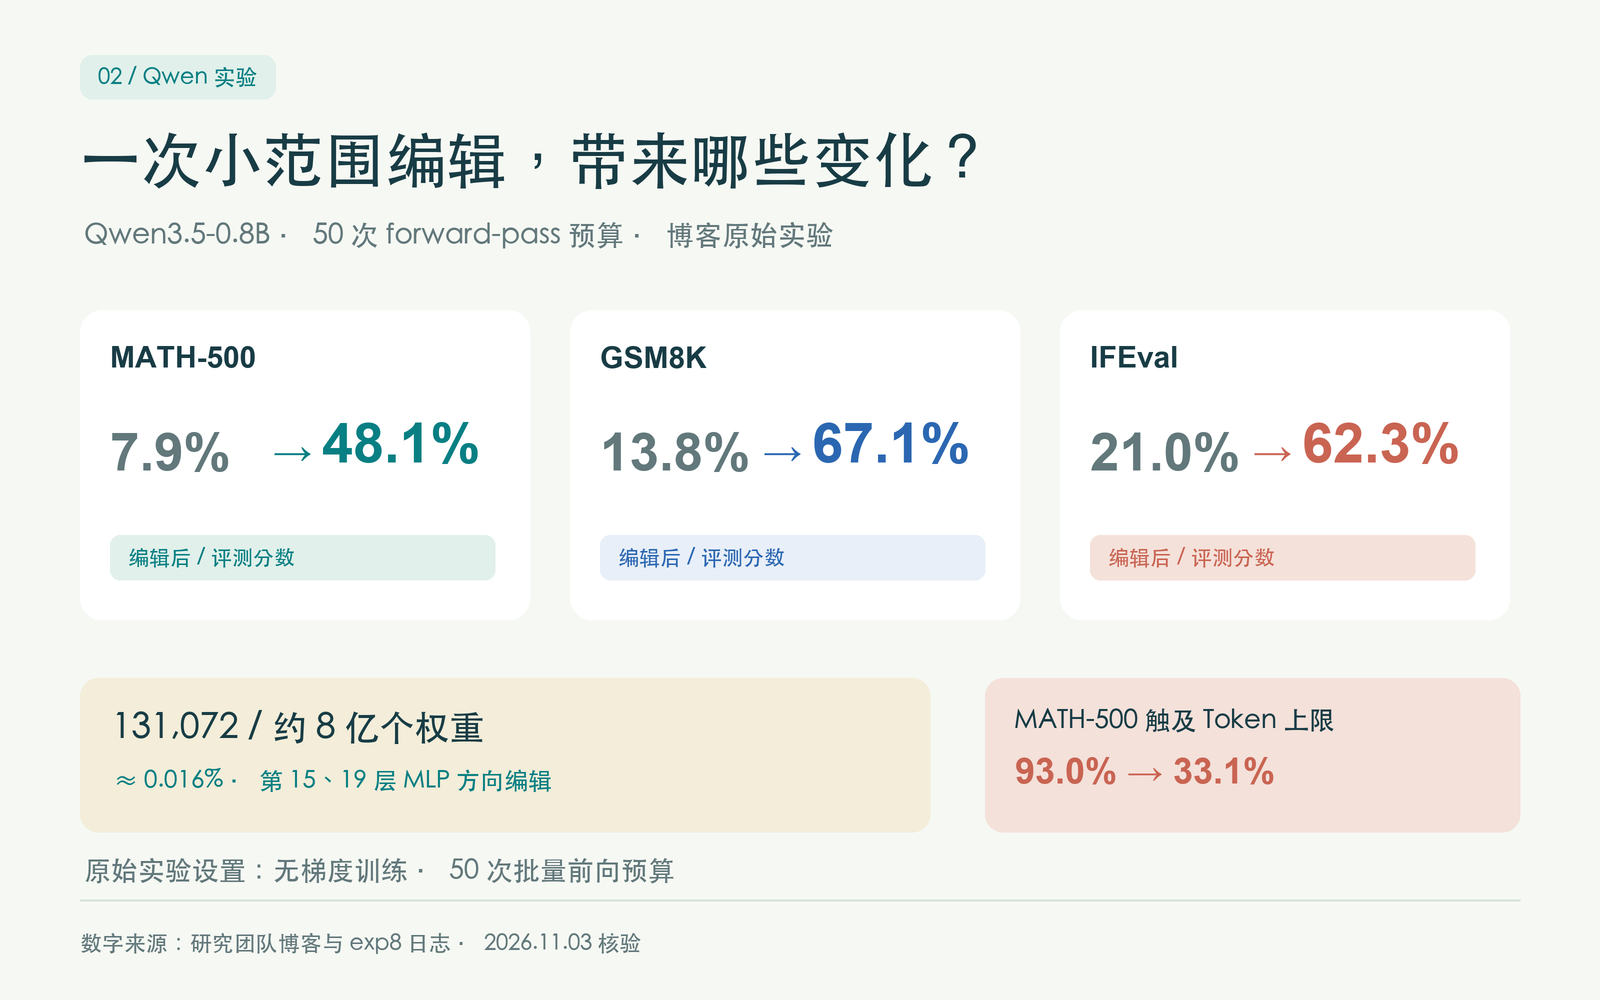
**Qwen3.5-0.8B 的提升,首先来自对推理循环的针对性修复。**博客称,Qwen 在实验设置下会反复生成相同文本,很少走到答案;前 96 个练习答案中有 85 个生成到 32,768 个 Token 上限。Astra 通过 Python 环境检查权重和有限的前向计算,追踪到第 15 层和第 19 层 MLP 写入的一个特定方向。
随后,Astra 从两层各 64 个输出列中减去这个方向,共修改 131,072 个权重。相对于约 8 亿个权重,这一改动约占 0.016%。实验没有提供梯度,也没有允许 Astra 运行训练过程;“50 次”指前向计算预算,不是 50 道题,也不是 50 轮训练。每次前向计算可以批量处理练习题,练习数据与最终评测集分开。
在博客给出的评测协议下,模型开启 thinking,最大生成长度为 32,768 Token;MATH-500 每题采样 4 次,GSM8K 和 IFEval 每题采样 2 次,得分取多次采样平均。50 次前向预算对应的结果如下:
最后一行衡量答案是否触及最大生成长度,并非推理耗时。结合团队对输出的分析,编辑后的模型更少陷入长循环,更常在上限前结束回答。
Gemma 对照:没有出现稳定增益
**Gemma 3 270M 的对照实验提醒人们,权重编辑并不自动带来数学能力提升。**这个模型本来就较少触发长循环,博客给出的 MATH-500 基线为 6.8%,在 5、10、25、50 次前向计算预算下分别为 7.0%、7.6%、7.7% 和 7.0%。研究团队认为,这些变化不足以建立明确的提升结论。
在这次 Gemma 实验中,Astra 观察到的主要是算术和代数推导错误,没有找到类似 Qwen 循环问题的单一干预方向,各次编辑也未获得稳定提升。它表明,修复一种阻碍回答的行为,与提升模型本身的推理能力,仍然是两个需要分别验证的问题。
博客附带的实验日志仓库记录了提示词、模型回复、代码、评估和权重修改。读者可先看 Experiment 8 的结果索引,再对照评测配置及编辑差分。Hugging Face 模型卡另列一次独立重跑:MATH-500 为 51.0%,触及 Token 上限的比例为 31.6%,与博客原始结果分别报告。
这离“模型自己改进自己”还有多远
**当前结果更像是受控的权重调试实验,而不是已经成熟的递归自我改进系统。**一方面,实验规模仍然有限,较大的权重需要工具和运行框架辅助;另一方面,Astra 的修改依赖明确的任务描述、可访问的权重和有限的前向反馈。研究团队也把“模型审计、低成本优化、跨架构移植和递归自我改进”表述为后续可能性,而不是本轮实验已经证明的能力。
团队接下来计划开发专门的评测基准和实验框架,衡量这种能力能走多远。对模型研发而言,这条路线提出了新的调试方式:让大模型解释权重与行为的关系,再提出局部修改。它能否扩展到更大的网络、更多故障类型,以及跨架构的模型合并,仍有待后续实验回答。
这组实验的现实意义因此很明确:它展示了“模型理解权重并进行定向编辑”的可行迹象,同时也把边界暴露得很清楚。Qwen 的数字提升来自特定循环问题的修复,不是对所有模型、所有任务的性能保证。本文数据截至 2026 年 11 月 3 日。
参考资料
MIT CSAIL 研究团队原始博客(2026-11-02):https://rikiyat.github.io/blog/weight-space-programming/
Experiment 8 数学实验记录:https://github.com/RikiyaT/lm_understand-logs/tree/main/exp8_math
编辑后 Qwen3.5-0.8B 模型卡:https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming
Qwen3.5-0.8B 基础模型卡:https://huggingface.co/Qwen/Qwen3.5-0.8B
编辑模型独立评测目录:https://huggingface.co/RikiyaT/Qwen3.5-0.8B-weight-space-programming/tree/main/eval
权重空间编程演示:https://huggingface.co/spaces/ML-Intern-lab/weight-space-programming-demo
七牛云 AI 大模型广场:https://www.qiniu.com/ai/models