DeepSeek Harness 上下文预算教程:compaction、spill 与统计插件
发布日期:2026-11-09 | 话题:DeepSeek Harness、上下文预算、compaction、spill | 约 2,500 字
DeepSeek Harness 是 DeepSeek AI 在 2026 年开源的 Agent harness。长会话的上下文预算由三层机制决定:compaction 压缩较早历史,spill 把超大工具输出落盘,统计页签展示上下文、缓存与耗时。本文基于 0.2.2-rc.1 官方文档,拆解三者的触发条件、默认参数和 KV Cache 影响,并给出一套“先量、再 spill、最后 compact”的排查顺序。
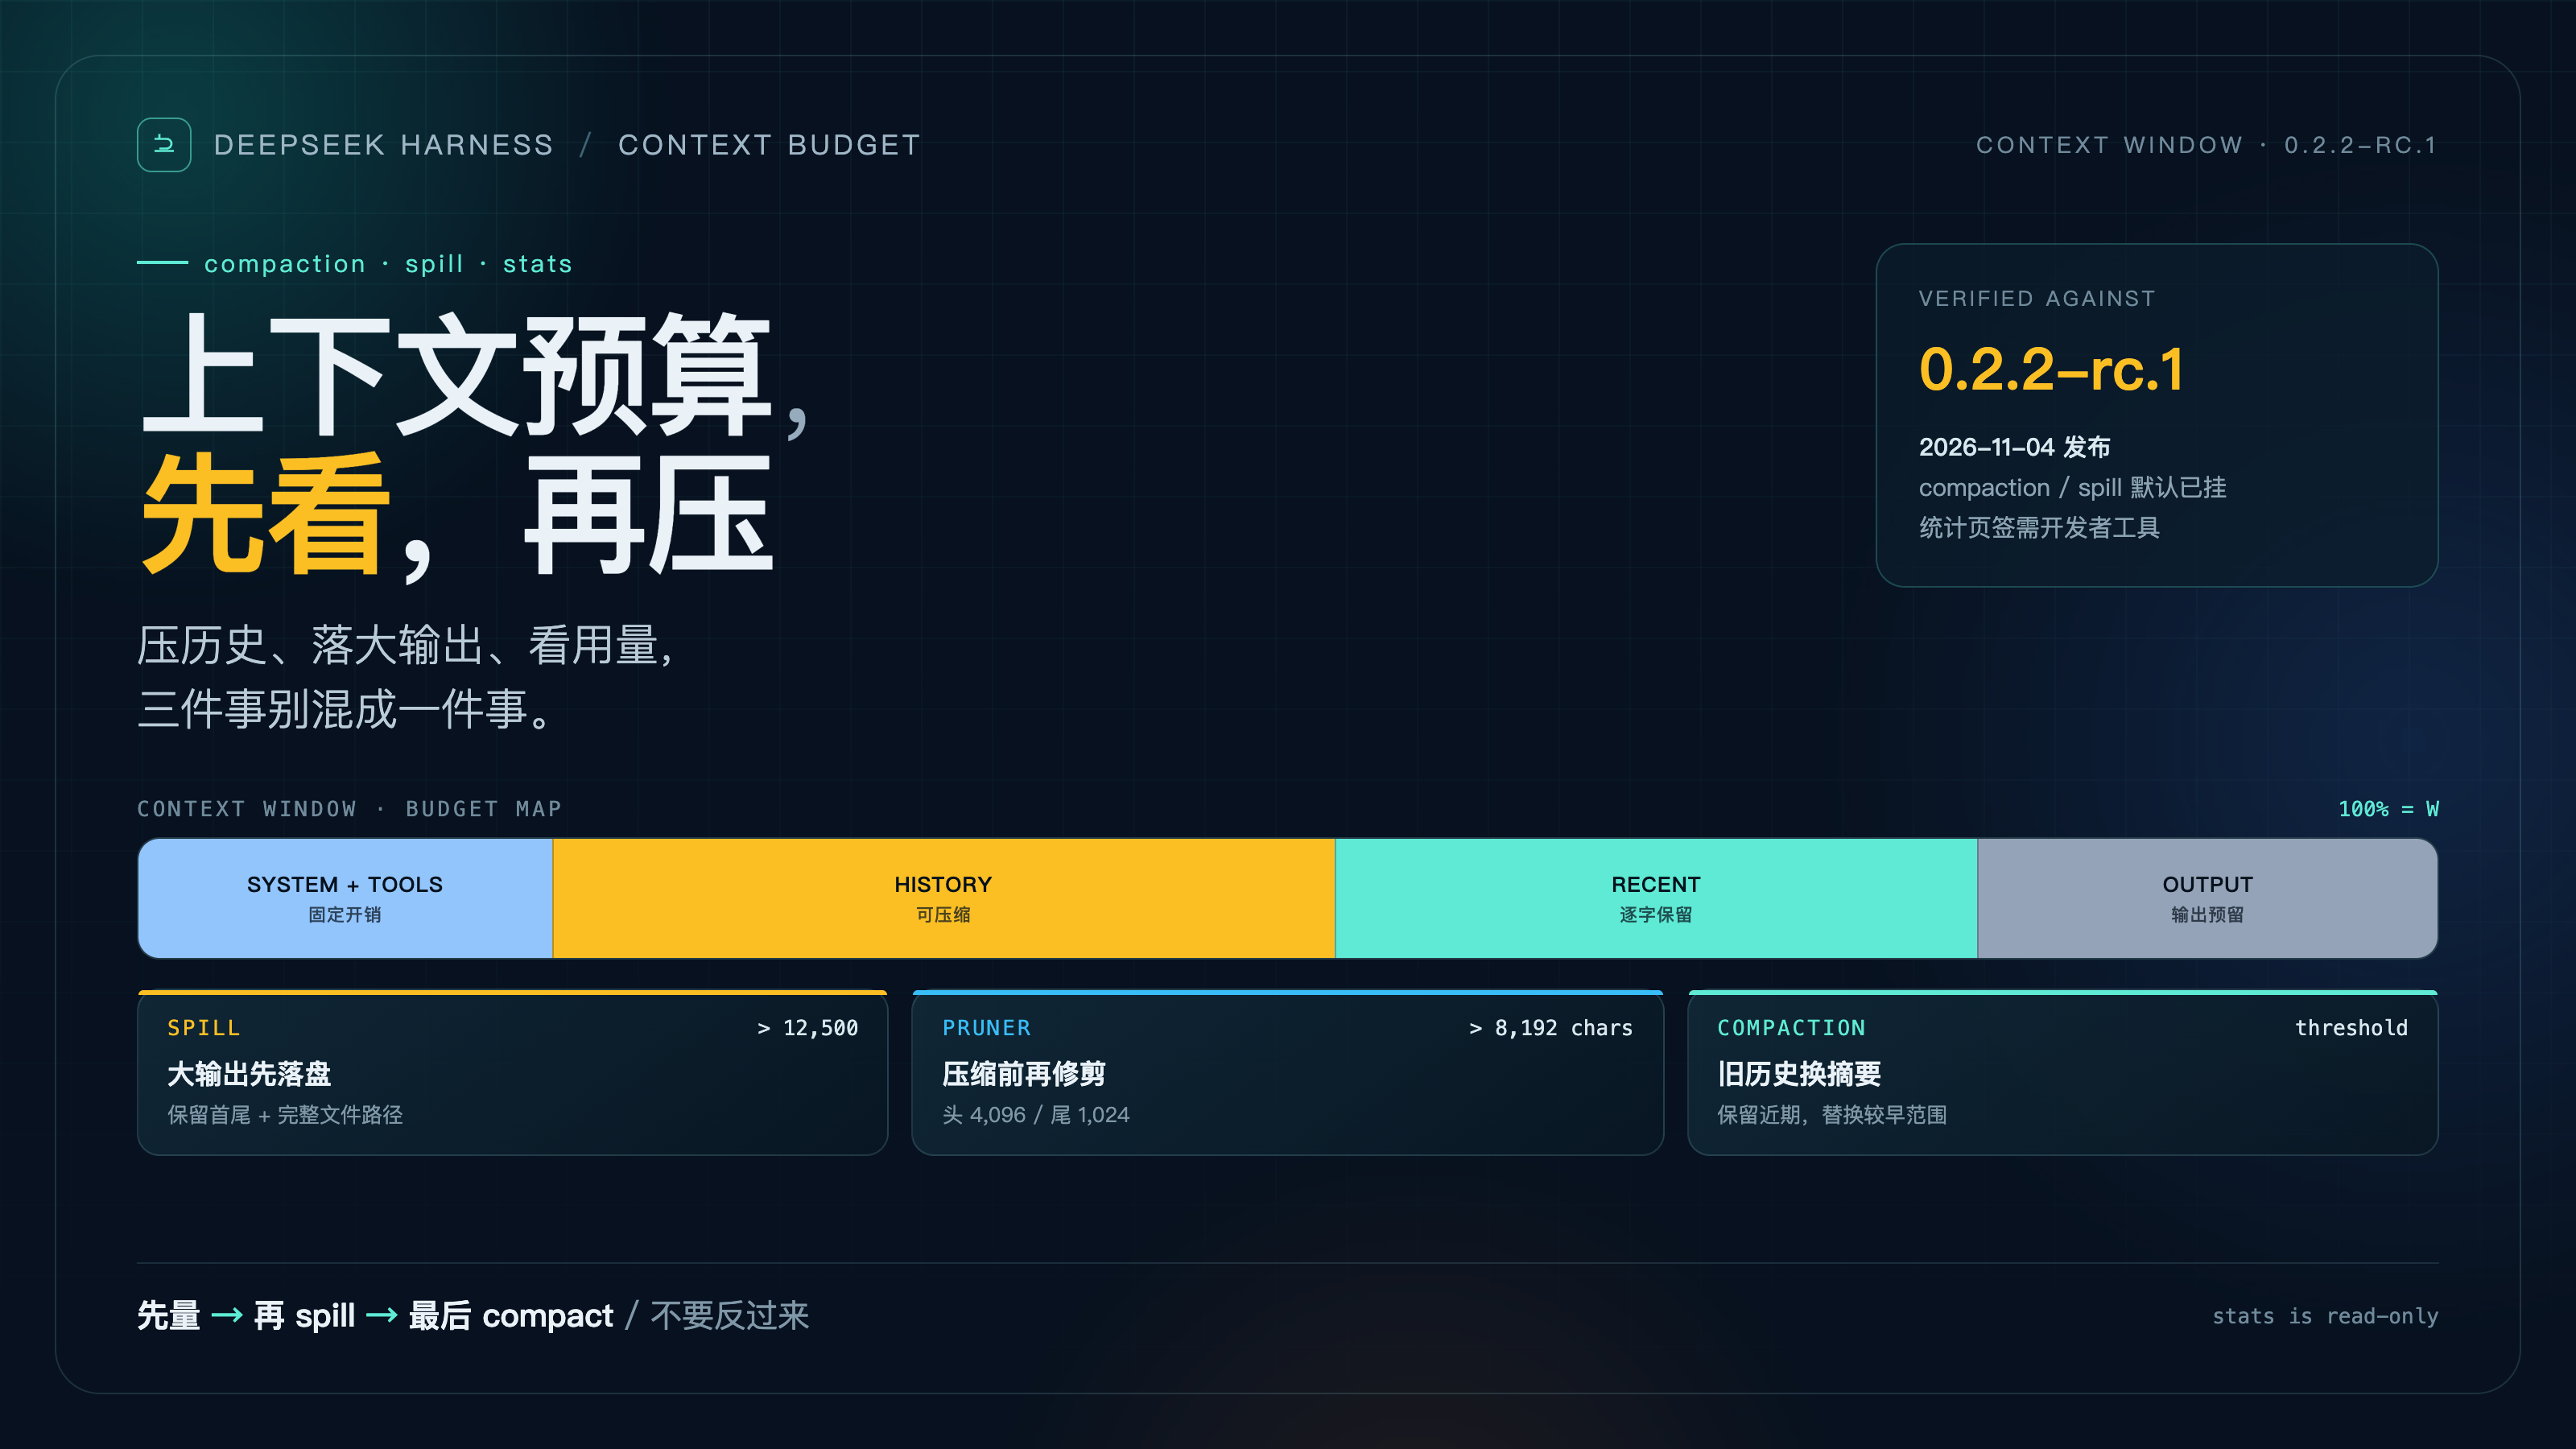
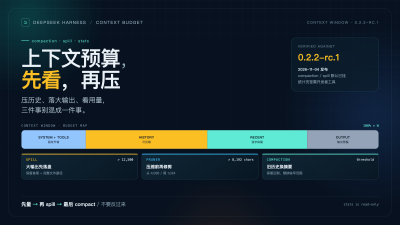
DeepSeek Harness 的上下文预算,是在 compaction、spill 和统计页签之间做选择:compaction 压缩较早历史,spill 把超大工具输出落盘,统计页签告诉你预算到底花在哪。
一、先给结论:这不是“压缩一下”那么简单
截至 2026-11-04 发布的 0.2.2-rc.1,随附的 dsh 基础配置已经挂了 compaction-basic、command-compact、spill-local 和 spill-policy。统计页签是例外,它属于实验性开发者工具,默认不挂载。
所以大多数部署不需要再装一个“上下文插件”,而是要先分清三种主机制、一个前置修剪器,以及一个只读统计视图:
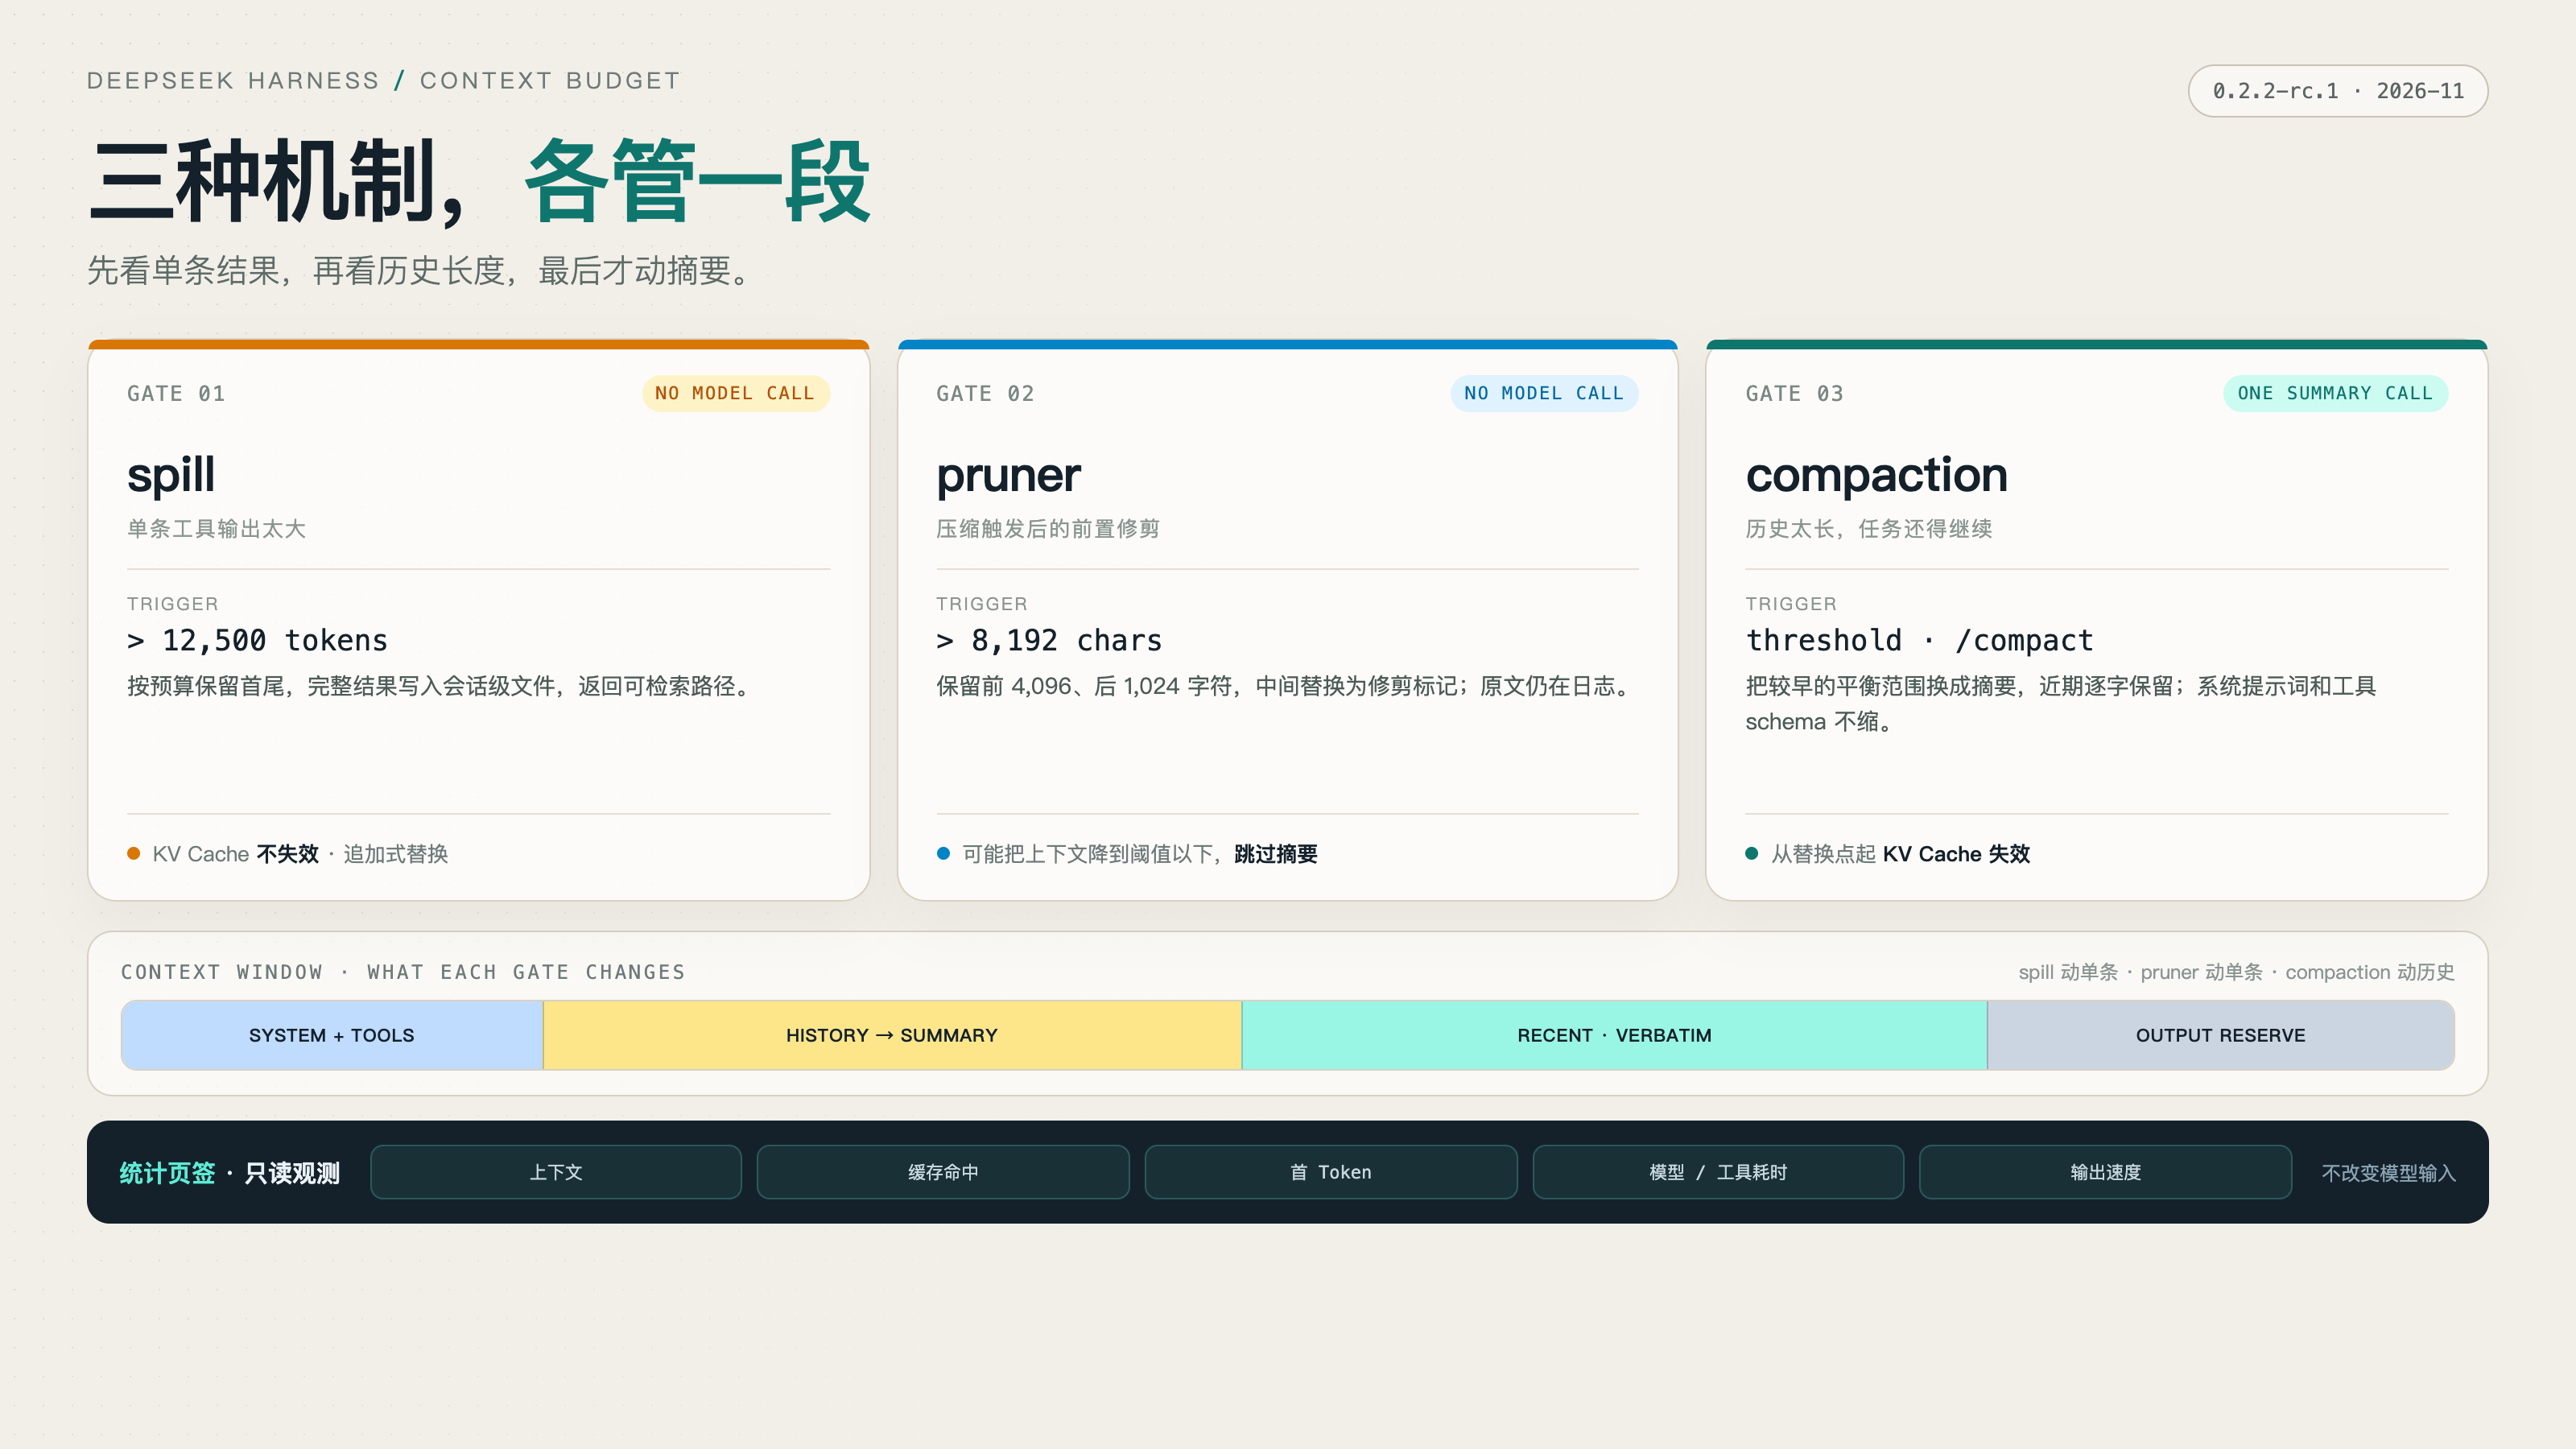
一句话结论:spill 管“单条结果太大”,pruner 管“压缩时先修剪”,compaction 管“历史太长”,统计页签管“先看清再动手”。
二、compaction:把较早历史换成摘要,但不是无损
compaction 的行为很明确:把最旧的平衡范围替换成一条摘要消息,近期对话逐字保留,会话从摘要继续。它不会缩减系统提示词、工具 schema 或会话前缀,也无法拆分一个不可分的超大工具调用。
默认触发阈值是:
floor(min(W × thresholdRatio, W − O − headroomTokens))其中 W 是上下文窗口,O 是单次输出预留,headroomTokens 默认 65,536。以 100 万窗口、256K 输出预留为例,默认阈值约为 678,464 Token;近期逐字保留预算为 (W − O) × 16%,约 119,040 Token。
对日常任务,这个阈值通常偏晚。可以按模型窗口收紧:
- id: compaction-basic
  config:
    thresholdRatio: 0.7
    headroomTokens: 4096
    maxTokens: 4096
    retainTokens: 2048
retainRatio 和 retainTokens 互斥;保留预算必须低于触发阈值,否则插件会在加载时拒绝。auto: false 会关闭自动压缩,只保留 /compact 手动入口。上面的 YAML 会整条替换同 id 的配置;如果 profile 里已有同 id,先合并字段,不要重复写两段。
compaction 有三个必须知道的边界:
摘要会丢细节:模板要求保留目标、文件、错误、决策和下一步,但不保留每一行原文;关键约束要重复一次或写进交接笔记。
压缩有额外请求:摘要是一次独立模型调用,压缩后不一定更快,价值在让后续请求变短。
缓存会失效:从第一个被替换历史 Token 起复用失效;替换点之前的前缀仍可复用。
三、spill 与 pruner:先处理单条大输出
spill:把超大结果落盘,保留可检索路径
spill 解决另一种问题:某次工具调用返回几万行日志、整页 HTML 或大段 JSON,直接塞进上下文会立刻挤占预算。
随附基础配置里,spill-policy 的 maxInlineTokens 默认是 12,500。超过预算时,模型看到的是按原顺序保留的首尾内容、省略提示,以及完整结果文件的路径;它可以用 read 的 offset/limit 或 grep 继续检索。
spill 的关键事实:
不调用模型:只做保留、存储和提示,不生成摘要。
保留全文:完整结果写入本地文件,文本可读可搜;图片按附件路径记录。
尽力而为:存储失败或图片不可读时保留原始内联结果,不会把成功调用变成错误。
缓存友好:追加式替换,新路径位于可复用前缀之后,不会让已有 KV Cache 失效。
本地后端默认把文件写入私有临时目录,会话子目录用 sha256(sessionId) 隔离,文件权限为 0600。需要固定位置时再覆盖:
- id: spill-local
  config:
    root: /var/lib/dsh/spill
    cleanupPeriodDays: 30
- id: spill-policy
  config:
    maxInlineTokens: 12500
这两段也是整条覆盖;已有同 id 时先合并字段。root 建议写绝对路径;相对路径从进程工作目录解析。cleanupPeriodDays 默认 30 天,清理只在进程启动时扫描一次。例如把 DSH 跑在七牛云 QVM 上时,可以把 root 指向单独挂载的数据盘,避免 spill 文件和系统盘抢空间。
pruner:压缩触发后才修剪,别和 spill 混了
dsh-compaction-tool-result-pruner 是 compaction 的前置闸门,不是独立的“大输出策略”。
它的默认规则是:文本超过 8,192 字符时,保留前 4,096 和后 1,024 个字符,中间替换为 [... tool result middle pruned ...]。它只在压缩触发条件满足后运行,低于压力阈值时不会碰任何结果。
pruner 和 spill 的区别看提示:Full formatted result stored at: ... 是 spill,完整结果在文件里;tool result middle pruned 是 pruner,中间被截断,原始事件仍在日志。
pruner 不调用模型,可能把上下文降到阈值以下,直接跳过摘要;但它只按语法保留头尾,精读长日志仍应让模型用 read 分段读取。
四、统计页签:先量,再决定压不压
统计页签按轮次和步骤展示上下文大小、输出 Token、缓存命中率、首 Token 延迟、模型与工具耗时、输出速度,以及总用时条。
启用方式:打开 Web 的“插件”,在“实验性插件”旁点“更多”,启用“开发者工具”;也可以在 profile 里显式挂载:
- id: ui-stats
  name: '@deepseek-ai/dsh-experimental-client-ui-stats'
统计页签默认不挂载,且属于实验性功能。启用开发者工具还会启动本地调试后端和未脱敏的 Host fetch 采集,不建议在共享或生产 profile 里长期开启。
读统计时重点看四件事:
每轮/每步上下文:确认是持续增长,还是某一步突然跳高。
缓存命中率:压缩后可能下降,观察后续几轮是否恢复。
模型与工具耗时:上下文不高但很慢,问题可能在工具或模型,不在预算。
压缩合成行:打开“显示事件行(含压缩)”,能看到压缩的 Token 数、摘要大小和摘要调用耗时。
统计页签的“总用时”是模型用时加工具用时,不是墙钟时间;并行工具调用会让工具段偏长,所以它适合比较趋势,不适合当精确 SLA。它也不会改变模型输入,单纯打开统计不会让会话变快或变慢。
五、怎么选:compaction、spill、新会话
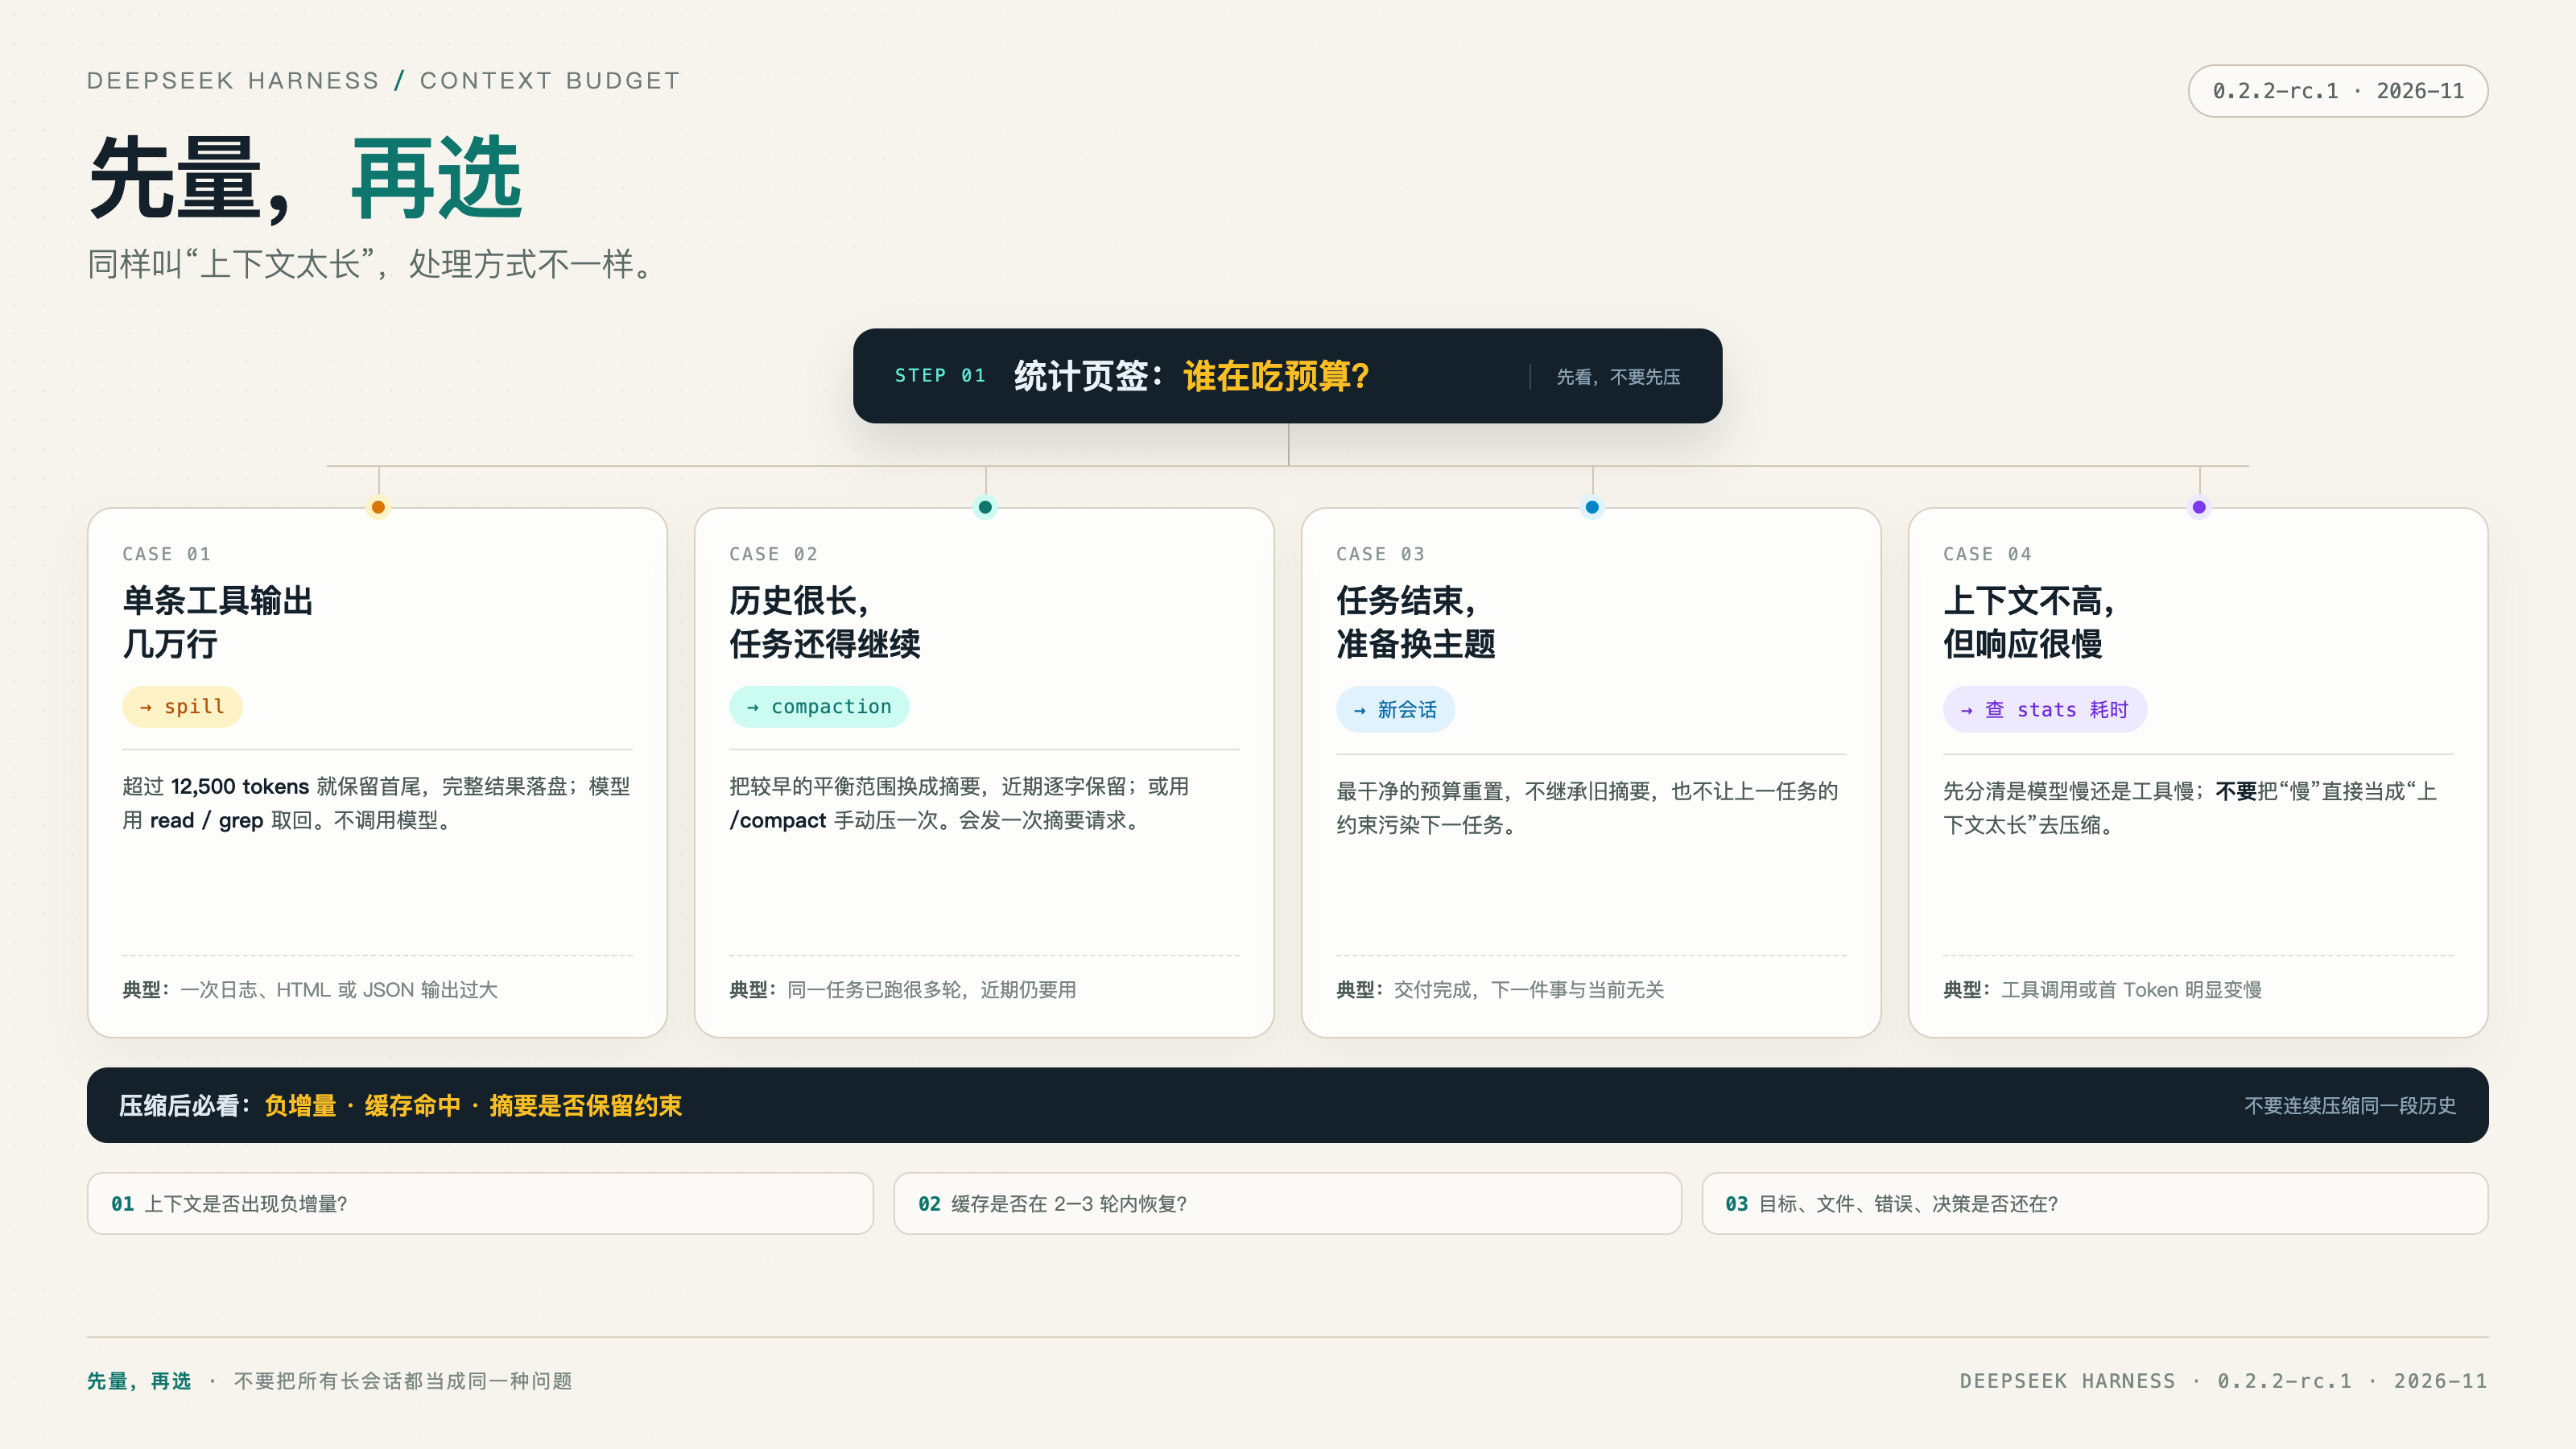
新会话不是“失败”,而是最便宜的预算重置:compaction 适合必须接着做的长任务,新会话适合任务已结束、准备开始下一件事的场景。
一套可复制的排查顺序
打开统计页签,先记录当前轮次的上下文、缓存和工具耗时,不要凭感觉压。
某一步上下文突然跳高:先看那一步的工具结果,判断是不是单条输出过大。
单条输出过大:确认 spill 是否触发;需要更早落盘就调低
maxInlineTokens。历史持续增长:输入
/compact做一次手动压缩,观察压缩合成行和负增量。压缩后回答变差或缓存下降:检查摘要是否漏掉关键约束;缓存观察 2-3 轮是否恢复。
重新测量,再决定是否继续压缩;不要连续多次压缩同一段历史。
如果只记一条:先用统计页签找到“谁在吃上下文”,再决定 spill、pruner 还是 compaction;不要把所有长会话都当成同一种问题。
六、常见问题
Q:compaction 和 spill 到底有什么区别? A:compaction 用一次模型调用把较早历史换成摘要,摘要会丢细节;spill 不调用模型,只把单条超大工具结果落盘,并给模型一个可检索路径。
Q:/compact 为什么提示不可用? A:agent 正在轮次中,或已有压缩在运行。压缩期间发送的提示词会排队,等压缩结束后再开始;命令本身不会排队,也不会打断当前轮次。
Q:统计页签为什么找不到? A:它不是默认功能,也不在普通插件列表里。需要在“插件 → 实验性插件 → 更多”里启用“开发者工具”,或显式挂载 @deepseek-ai/dsh-experimental-client-ui-stats;它是实验性视图,不会改变模型输入。
Q:spill 文件在哪里,会不会一直堆积? A:默认在私有临时目录的 session-<hash> 子目录;可用 root 固定位置。cleanupPeriodDays 默认 30 天,但清理只在进程启动时扫描一次,长期运行要留意堆积;会话多时建议固定 root 并定期检查。
Q:压缩后缓存命中率下降,正常吗? A:可能。替换会从第一个被替换历史 Token 起使复用失效;替换点之前的前缀仍可复用。观察后续 2-3 轮,不要只看压缩后的第一轮;如果一直不恢复,再查摘要和工具耗时。
七、结语
DeepSeek Harness 的上下文预算,不是“把阈值调低”这一件事。spill 处理单条大输出,pruner 在压缩前做无模型修剪,compaction 把较早历史换成摘要,统计页签把上下文、缓存和耗时摊开给你看。四者配合,才能既让长任务继续,又不让摘要悄悄吃掉关键约束。
本文基于 DeepSeek Harness 0.2.2-rc.1(2026-11-04)官方文档,写作时间为 2026-11-09。RC 版本行为可能变化,调整配置前请复核当前版本的 compaction、spill 与统计插件文档。
参考资料
DeepSeek Harness v0.2.2-rc.1 发布说明:https://github.com/deepseek-ai/deepseek-harness/releases/tag/dsh-v0.2.2-rc.1
compaction-basic:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/compaction/compaction-basic/README.zh.md
command-compact:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/compaction/command-compact/README.zh.md
spill-policy:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/spill/spill-policy/README.zh.md
spill-local:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/spill/spill-local/README.zh.md
compaction-tool-result-pruner:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/compaction/compaction-tool-result-pruner/README.zh.md
client-ui-stats:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/experimental/client-ui-stats/README.zh.md
inspector-profile:https://github.com/deepseek-ai/deepseek-harness/blob/master/packages/experimental/inspector-profile/README.zh.md
云服务器 QVM:https://www.qiniu.com/products/qvm
七牛云Token Plan 企业订阅(低至1.2折):https://www.qiniu.com/ai/tokenplan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free