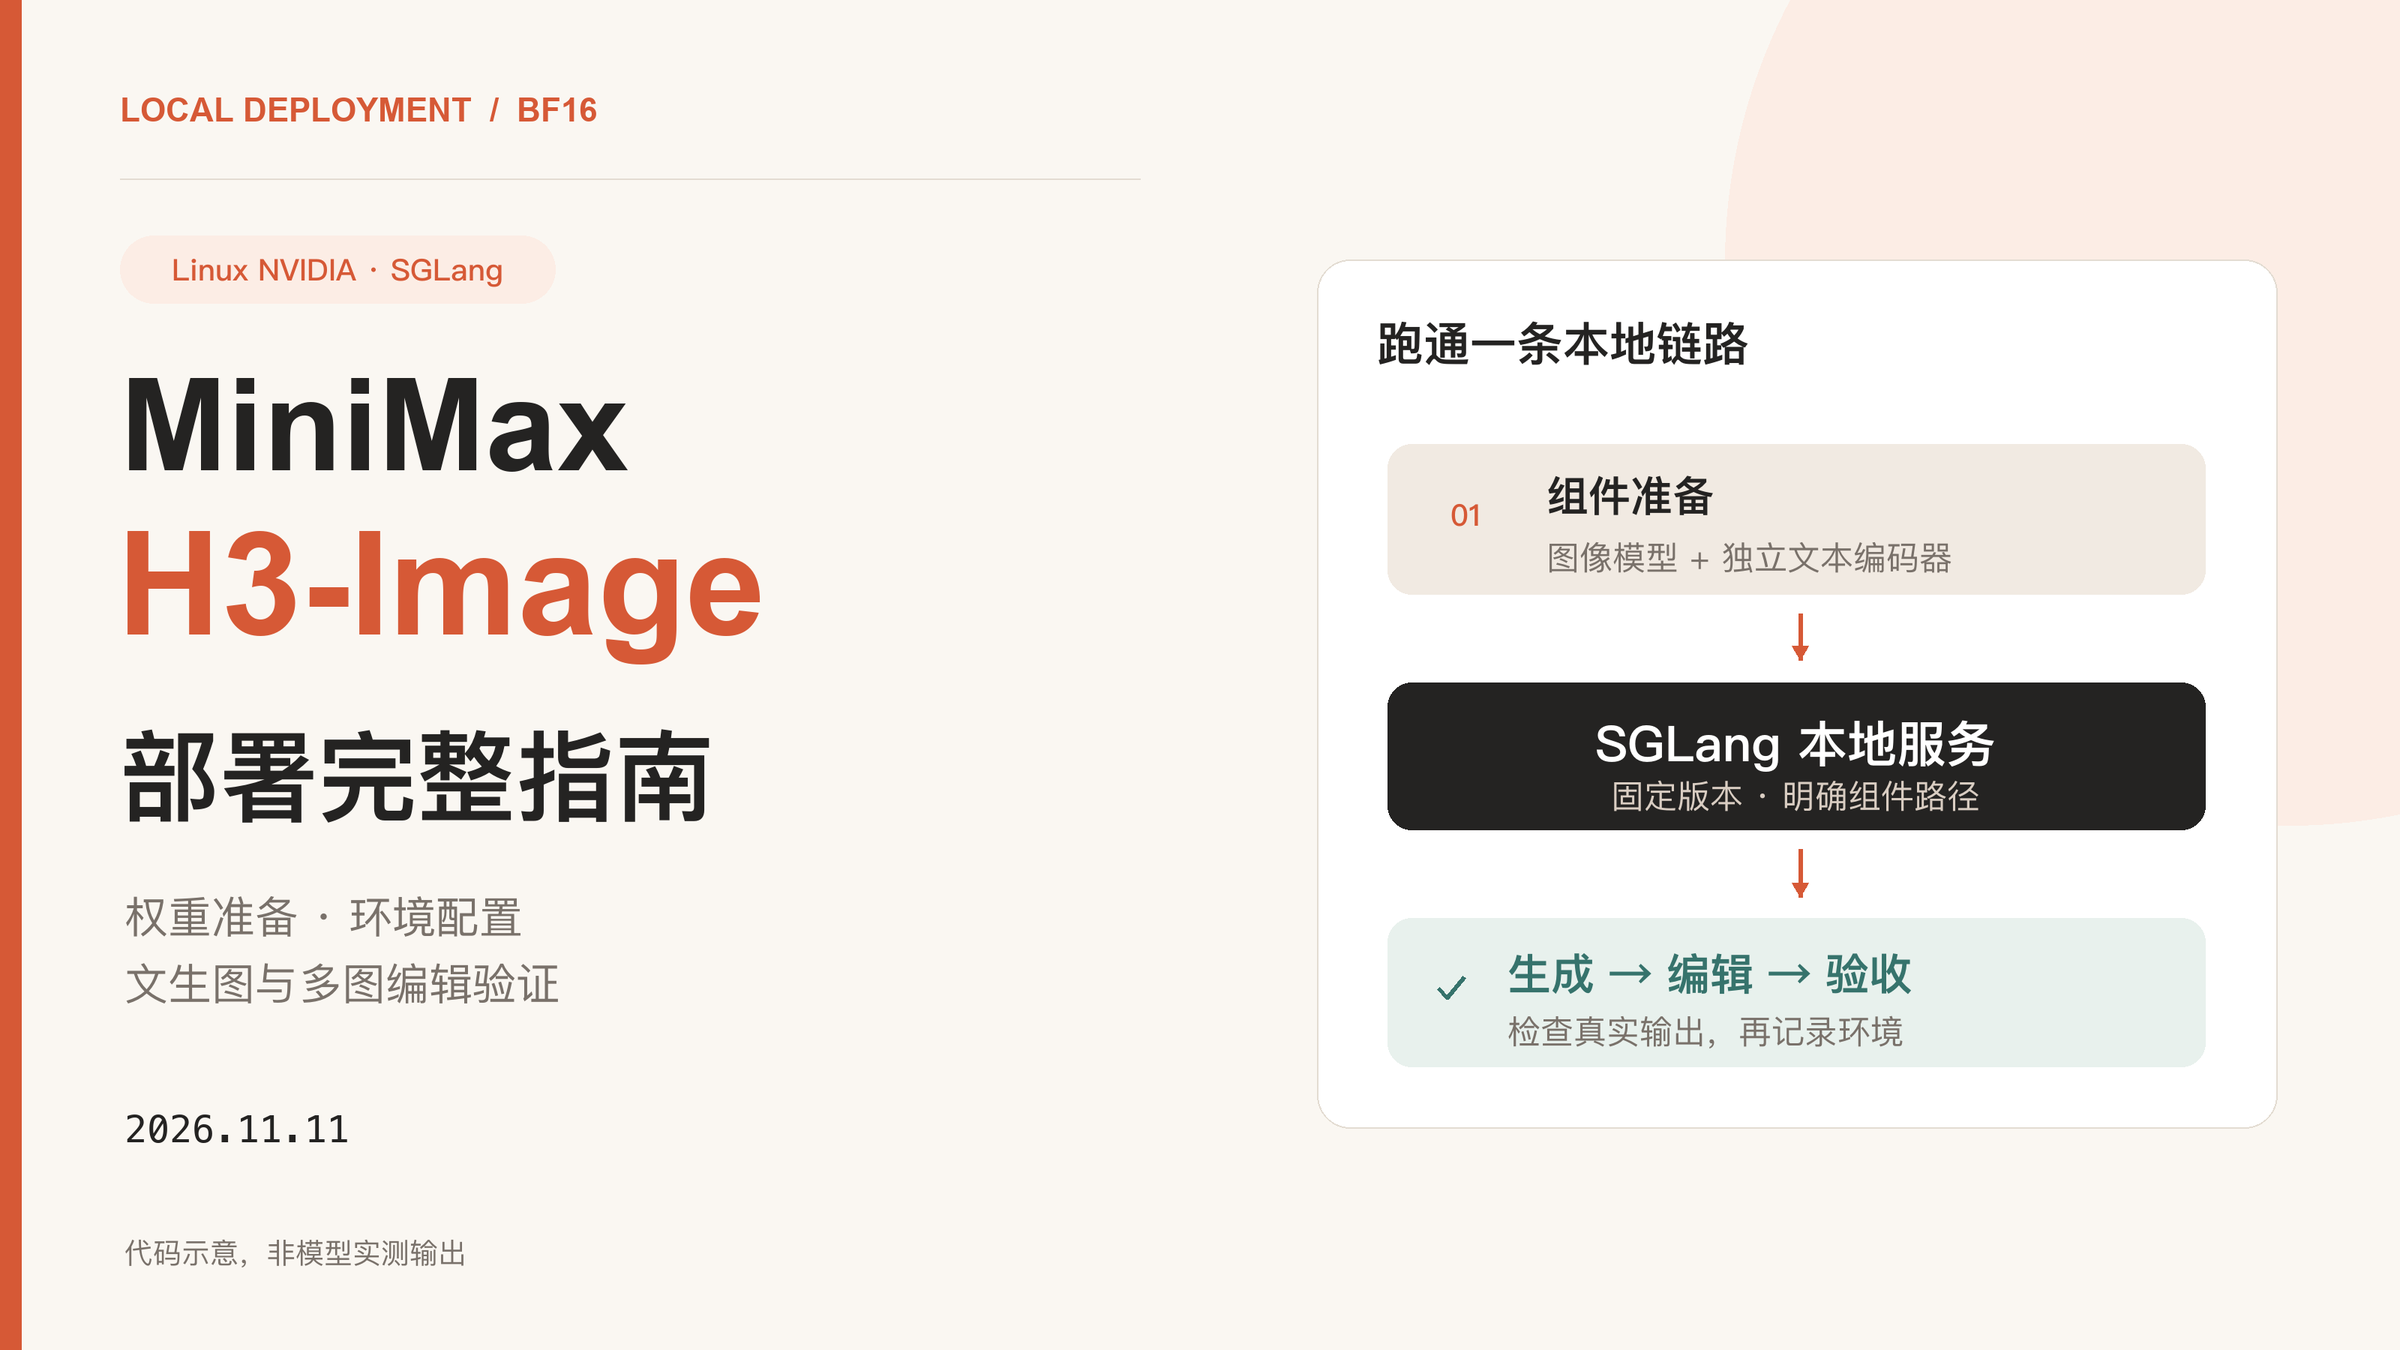
MiniMax H3-Image 部署完整指南:环境安装、文生图与多图编辑
发布日期:2026-11-11|分类:AI与智能服务|资料核验截至2026-11-11
MiniMax H3-Image 是 MiniMax 于2026年11月开放权重的图像生成与编辑模型,本地运行需要图像模型组件和独立文本编码器,同一套权重支持文生图与多参考图编辑。这篇指南以Linux NVIDIA环境和SGLang源码版为主线,依次完成环境准备、固定版本下载、服务启动、单图生成、双图编辑与结果检查,并说明ComfyUI转换权重、低显存offload和可选提示词扩写的差别。命令已按官方文档与源码核对,客户端经过离线验证;实际GPU容量、速度和输出质量仍需在目标机器验收。
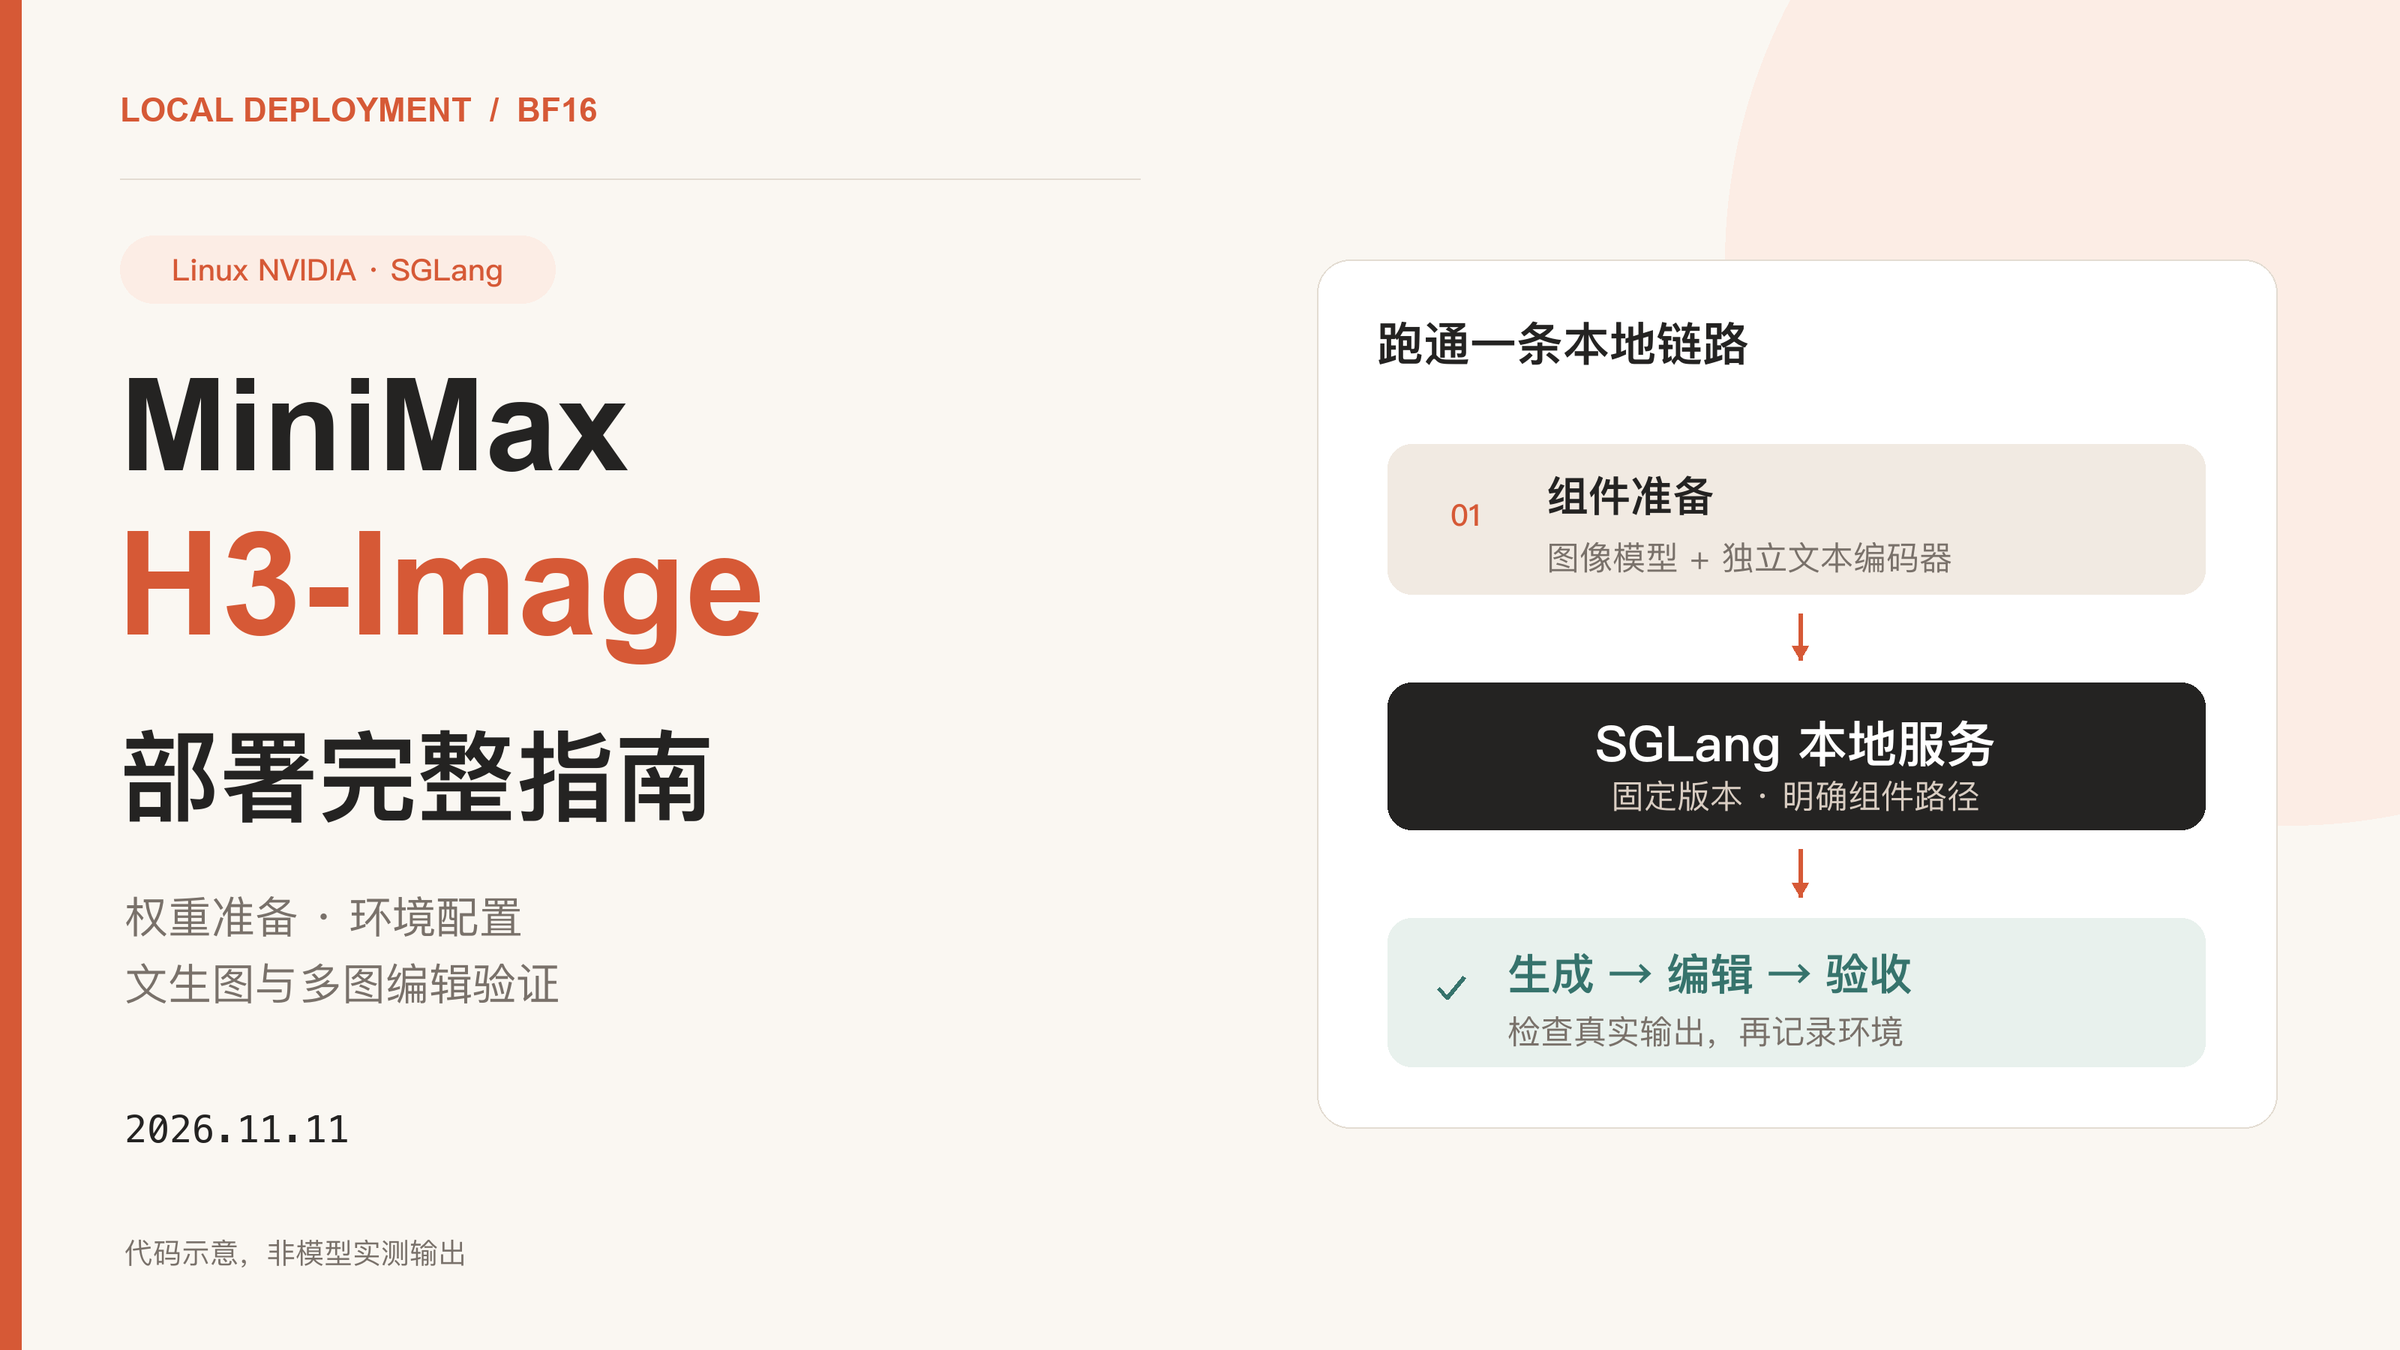
H3-Image 已经可以自行运行,但“下载权重”只是其中一步。图像模型、文本编码器、框架版本和请求格式需要对齐,才有一条能持续复现的本地链路。
下面从已准备好驱动的Linux GPU服务器开始,使用SGLang运行BF16主线。本文未在GPU上安装或执行推理,也没有把文档中的厂商测量当作自己的实测结果。
1. 先确定硬件和部署路径
H3-Image 的部署配置需要同时考虑显存、主机内存和磁盘,不能只看模型文件大小。
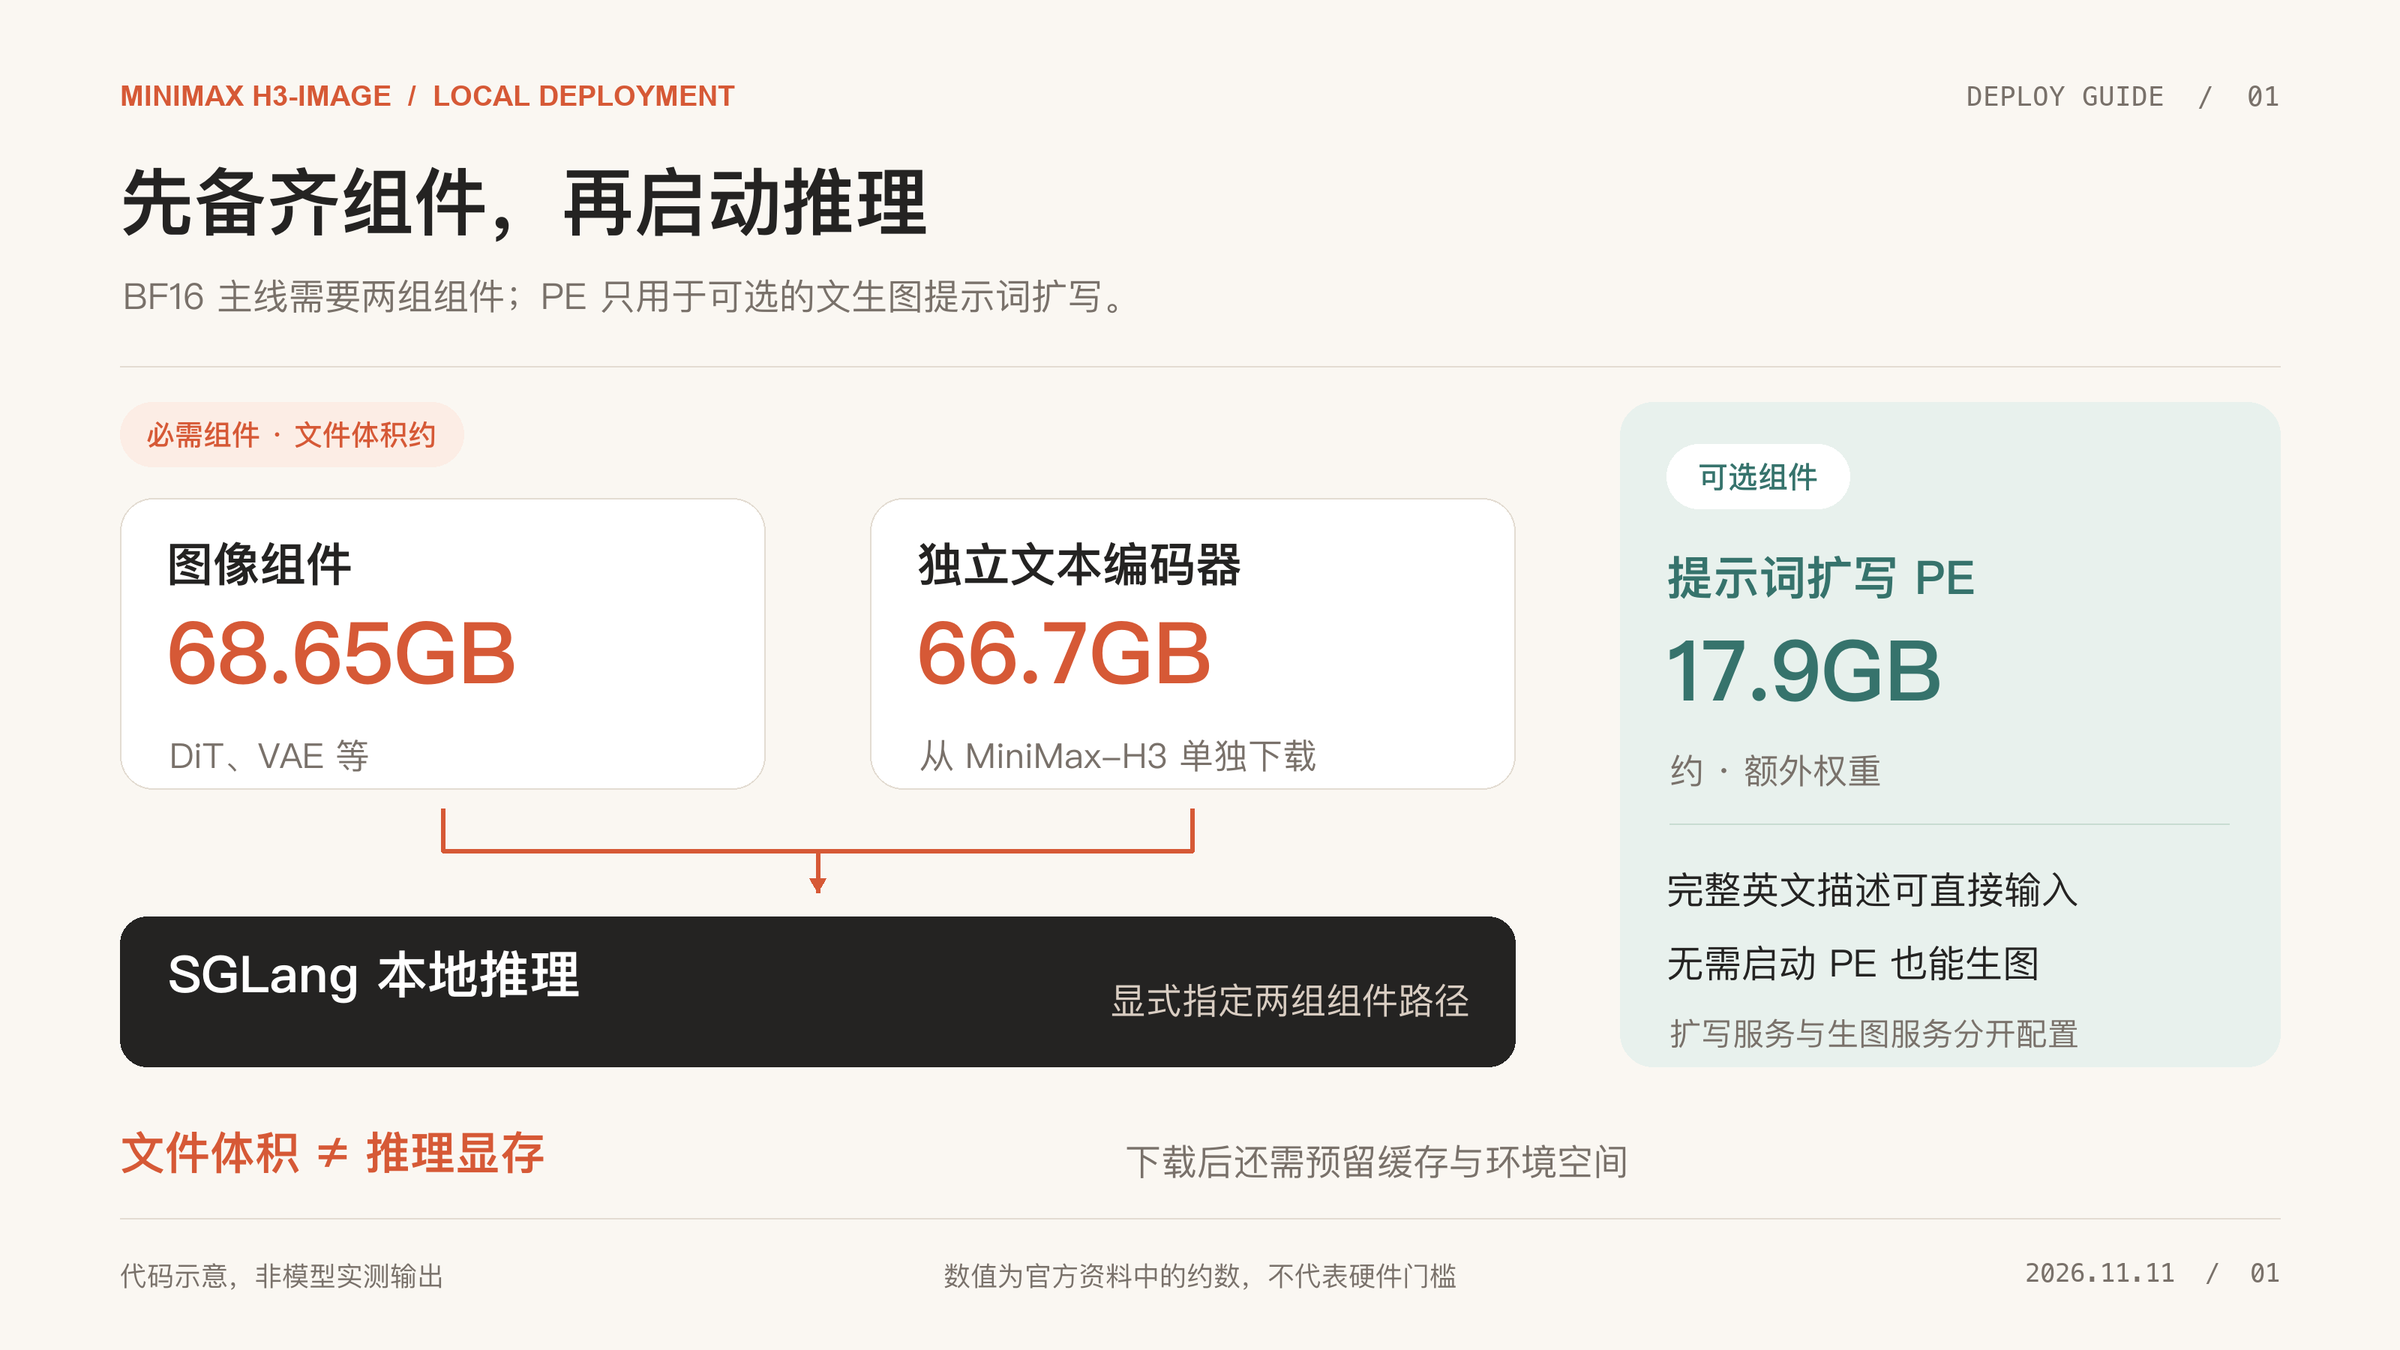
按2026年11月的官方模型卡,图像组件约68.65GB,另需约66.7GB文本编码器;约17.9GB的MiniMax-H3-Image-PE用于可选提示词扩写。本文按固定文件树核算,下载白名单合计约135.38GB,还应为缓存、环境与输出预留空间;这不是显存需求。
SGLang官方cookbook区分了实测配置和Derived推导配置。截至2026年11月11日,可以按下面的边界选择入口。
其中,Auto在每张独立GPU启动可用显存至少130GiB时保留组件常驻,否则保留offload。这个判断条件不是所有配置的统一最低显存门槛。
低显存方案会把权重传输和容量压力移到主存与总线。官方在受限B300分配器上做过容量验证,这不等于在所列消费级显卡上测得相同速度或稳定性。
2. 安装包含H3-Image支持的SGLang源码
H3-Image 的SGLang部署说明要求使用源码版本,并安装diffusion依赖,不能只安装一个未经核对的旧版包。
本文锁定2026年11月11日核验的源码commit,使用Python 3.12和兼容CUDA 13的驱动、Toolkit。该源码的依赖声明包含PyTorch 2.14.1、Transformers 5.19.0和FlashInfer 0.7.3;按同一份依赖安装。
源码安装默认编译Rust扩展,仓库的rust/rust-toolchain.toml指定Rust 1.92。还需准备C/C++编译器、CMake和系统开发库,不能只有Python环境。
先查看GPU和工具链。nvidia-smi显示的CUDA版本反映驱动支持范围,不能单独证明本机Toolkit和Python依赖已经匹配。
nvidia-smi --query-gpu=name,memory.total,memory.free --format=csv
nvcc --version
git --version
cmake --version
c++ --version
在Ubuntu上,可先用下面的命令准备基础构建工具;CUDA Toolkit仍需事先配置完成。
sudo apt-get update
sudo apt-get install -y git curl build-essential cmake pkg-config libssl-dev
在新目录安装uv和Rust工具链。以下使用两者的官方独立安装器,避免向系统Python环境写包;已安装时可跳过对应安装器。
mkdir h3-image-deploy
cd h3-image-deploy
export H3_WORKDIR="$PWD"

curl -LsSf https://astral.sh/uv/0.13.7/install.sh | sh
export PATH="$HOME/.local/bin:$PATH"
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh -s -- -y
source "$HOME/.cargo/env"
rustup toolchain install 1.92 --profile minimal
export RUSTUP_TOOLCHAIN=1.92
uv --version
rustc --version
cargo --version

uv venv --python 3.12 --seed
source .venv/bin/activate

git clone https://github.com/sgl-project/sglang.git sglang-src
git -C sglang-src checkout a93e89fd4a4eefb52c3ce73a609317d716d2a6ab
cd sglang-src
uv pip install -e 'python[diffusion]' --prerelease=allow
uv pip install --upgrade huggingface_hub
cd "$H3_WORKDIR"
安装完成后,在同一个虚拟环境核对CUDA可用性与依赖。若CUDA不可用或依赖检查报错,先修复环境,再下载大文件。
uv pip check
python - <<'PY'
import torch
import sglang
print("torch:", torch.__version__)
print("CUDA runtime:", torch.version.cuda)
print("CUDA available:", torch.cuda.is_available())
if not torch.cuda.is_available():
    raise SystemExit("CUDA is unavailable in this Python environment")
print("GPU:", torch.cuda.get_device_name(0))
PY源码版本固定了安装入口,并不等于锁住所有间接依赖。环境通过后,可用uv pip freeze > requirements-resolved.txt留存本机依赖,连同驱动和GPU信息一起记录。
3. 分别下载图像组件和文本编码器
使用组件白名单下载,可以避免把仓库中的其他转换副本也下载到同一部署目录。
官方模型卡声明了外部文本编码器。本文固定图像模型和MiniMax-H3编码器各自的revision,并在启动时显式指定编码器路径,不依赖随后可能变化的默认分支。
下面两条命令会开始下载大文件。需要先看下载清单时,可分别在命令末尾追加--dry-run;核对磁盘后再执行实际下载。
hf download MiniMaxAI/MiniMax-H3-Image \
  --revision fbde899fffb5c5225ee8dd7027680113746af42e \
  --include model_index.json pdd_config.json pdd_fused_heads.safetensors \
    'processor/*' 'tokenizer/*' 'transformer/*' 'vae/*' 'examples/*' \
    LICENSE README.md \
  --local-dir "$H3_WORKDIR/models/MiniMax-H3-Image"

hf download MiniMaxAI/MiniMax-H3 \
  --revision 0919fb684102ef115126612f3fbb84d1027e7317 \
  --include 'text_encoder/*' \
  --local-dir "$H3_WORKDIR/models/MiniMax-H3"
下载后的关键位置应为:
h3-image-deploy/
├── .venv/
├── sglang-src/
└── models/
    ├── MiniMax-H3-Image/
    │   ├── model_index.json
    │   ├── transformer/
    │   ├── vae/
    │   ├── pdd_config.json
    │   ├── pdd_fused_heads.safetensors
    │   └── examples/
    └── MiniMax-H3/
└── text_encoder/不要在模型索引声明外部编码器时,又随意把另一套text_encoder/复制进图像模型目录。当前加载器会检查这种冲突。下载中断后也不必立即清空目录,先核对缺失文件和缓存元数据。
4. 启动服务,先检查本地接口
单卡参考路径通过SGLang加载本地图像权重和指定编码器,监听本机30000端口。
在刚才的虚拟环境中运行。前台进程启动后,等待日志完成权重加载和默认warmup,再从另一个终端发请求。
sglang serve \
  --model-path "$H3_WORKDIR/models/MiniMax-H3-Image" \
  --text-encoder-path "$H3_WORKDIR/models/MiniMax-H3/text_encoder" \
  --backend sglang \
  --host 127.0.0.1 \
--port 30000另开终端并进入同一个h3-image-deploy目录,重新激活环境和设置工作目录。以下操作在客户端终端完成,服务端终端保持运行。
source .venv/bin/activate
export H3_WORKDIR="$PWD"
curl --fail http://127.0.0.1:30000/health
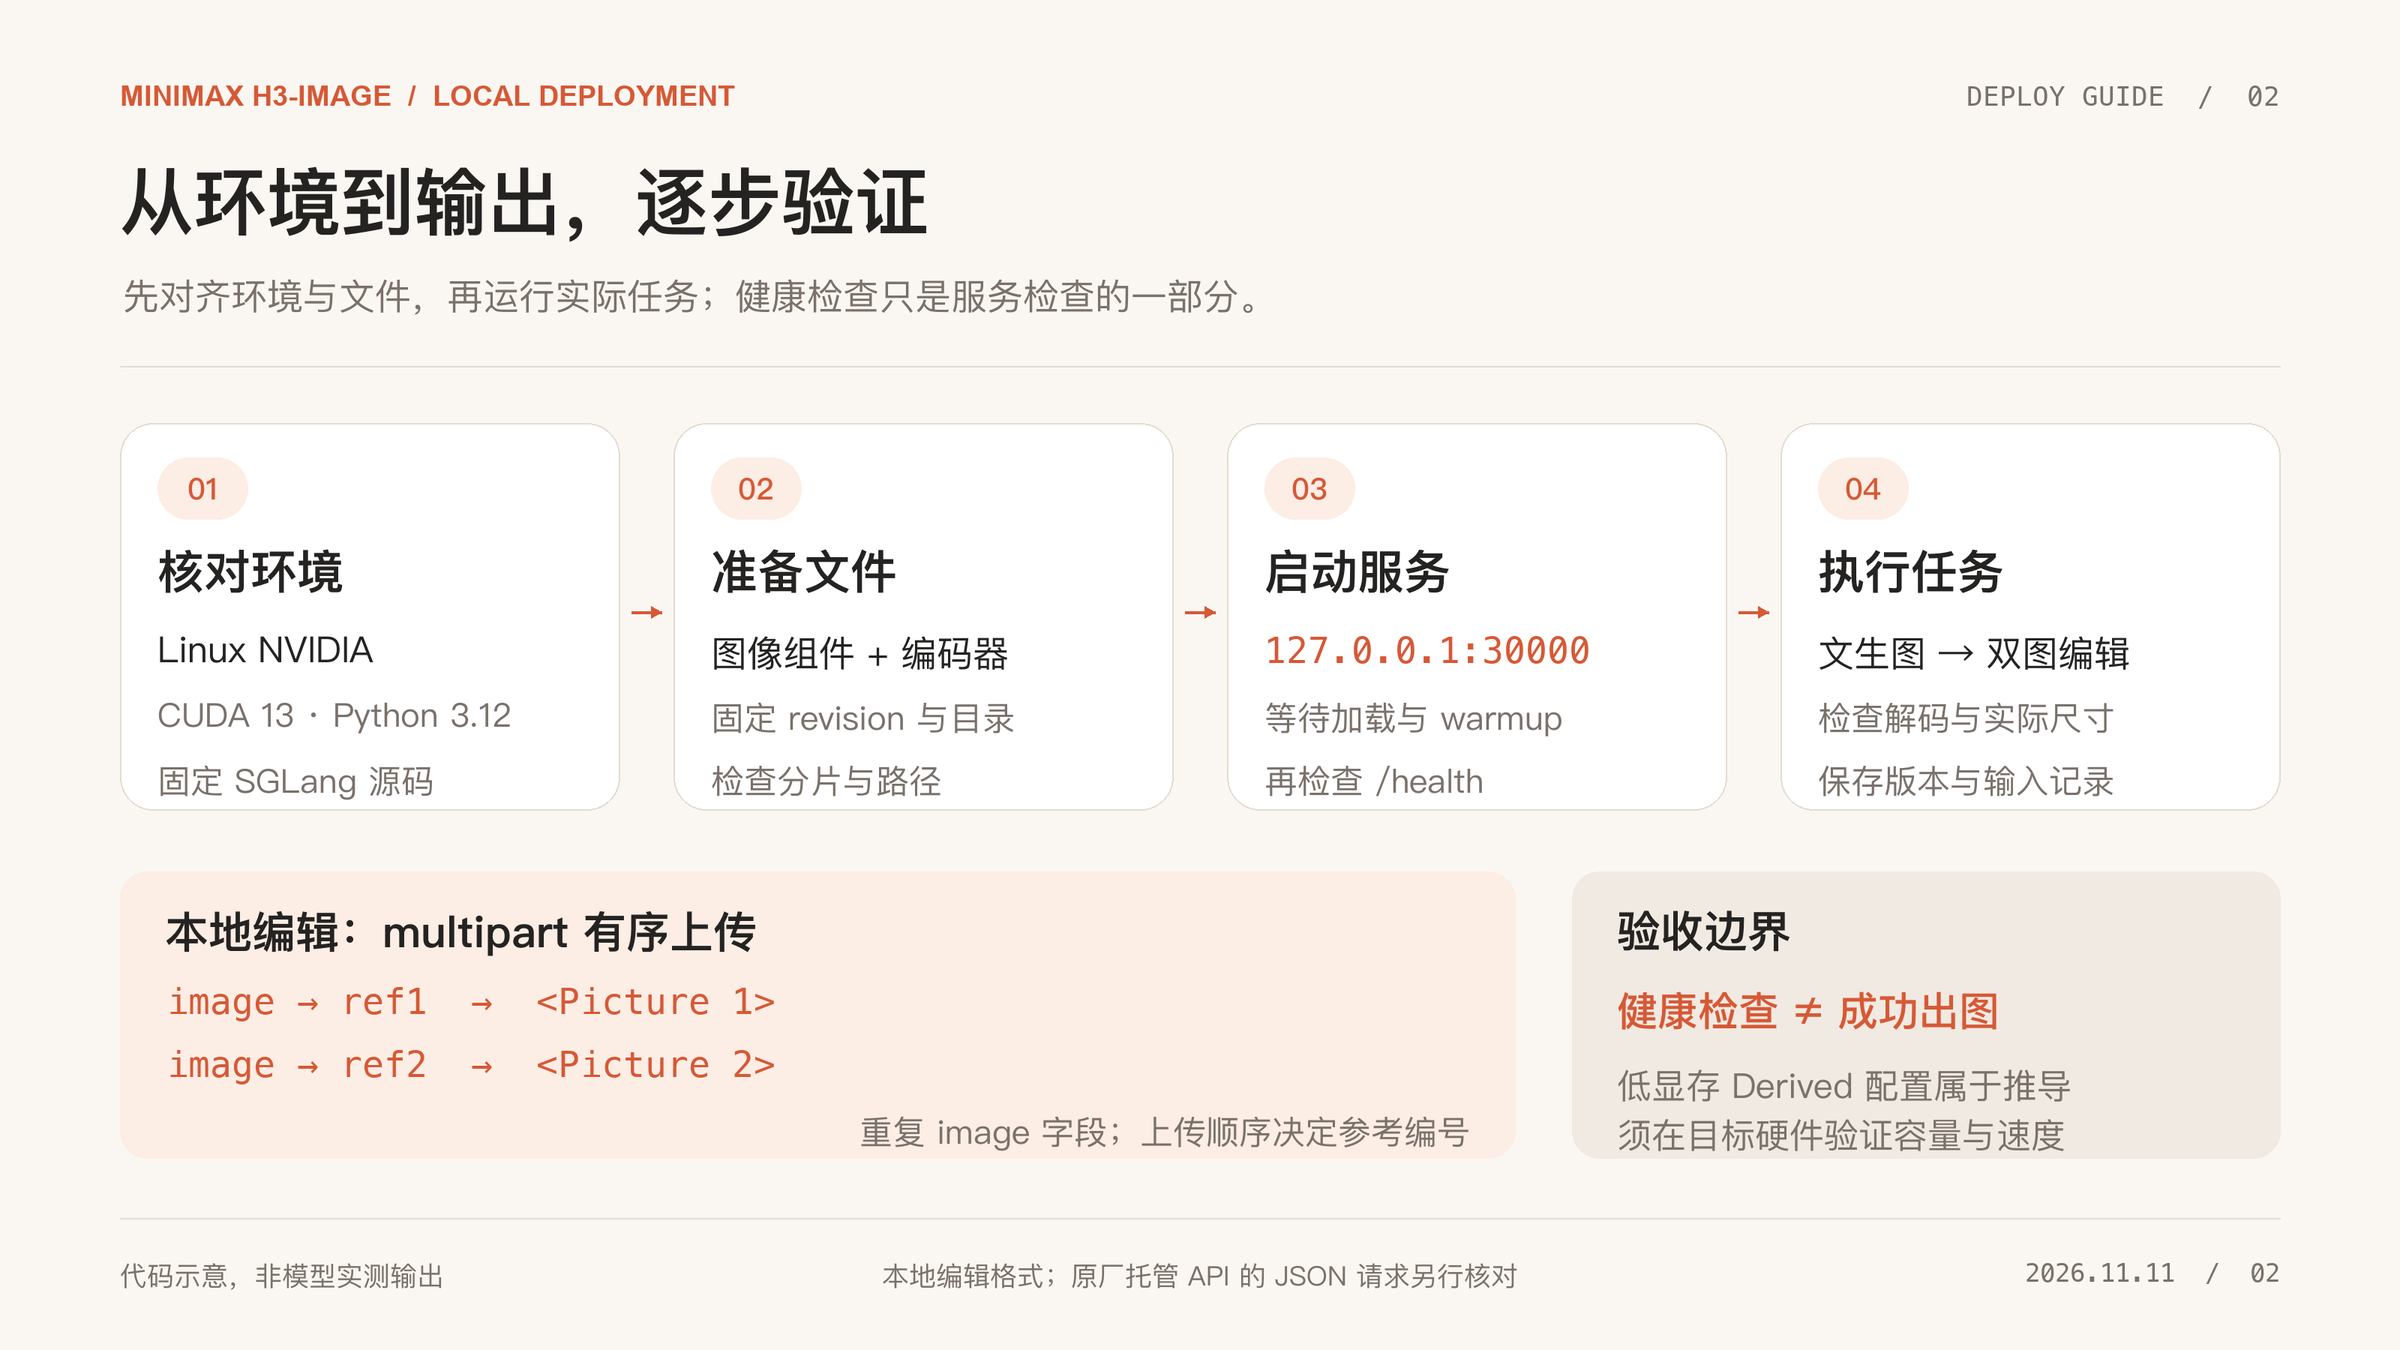
mkdir -p "$H3_WORKDIR/outputs" "$H3_WORKDIR/inputs"默认warmup期间,/health可以返回503;应继续查看启动日志,完成后再检查。/liveness返回200只说明HTTP服务存活。健康检查不能代替实际出图验收。
若使用同一节点上通过NVLink互联的两张H200,可停止原服务后改用下面的命令;仍需重新核对每卡可用容量。
sglang serve \
  --model-path "$H3_WORKDIR/models/MiniMax-H3-Image" \
  --text-encoder-path "$H3_WORKDIR/models/MiniMax-H3/text_encoder" \
  --backend sglang --host 127.0.0.1 --port 30000 \
  --num-gpus 2 --tp-size 1 --ulysses-degree 2 --ring-degree 1 \
  --encoder-parallel fold
Ulysses切分序列但仍复制DiT权重,编码器切分另由fold处理;不能把模型文件大小直接除以卡数估算显存。
对选择器列出的12—48GB卡,以下是单卡逐层offload的派生配置,需要256GB级主存和本地NVMe。停止原服务后再选择此入口;尚无所列消费卡的运行或延迟保证。
sglang serve \
  --model-path "$H3_WORKDIR/models/MiniMax-H3-Image" \
  --text-encoder-path "$H3_WORKDIR/models/MiniMax-H3/text_encoder" \
  --backend sglang --host 127.0.0.1 --port 30000 \
  --num-gpus 1 \
  --component-residency all=layerwise-offload \
  --layerwise-prefetch-size transformer=1,text_encoder=1,video_vae=1 \
  --minimax-h3-adaln-online true
先保持2048×2048请求,并记录加载、warmup与首张图的资源峰值;不要在首次启动时同时开启量化、编译和多卡配置。
5. 用官方客户端完成第一张文生图
本地H3-Image可以直接接收完整英文画面描述,首次验证不必启动扩写模型或调用远程API。
在工作目录创建提示词,明确主体、构图、材质和光线。这里是待验证的输入设计,不代表模型已经实现这些效果。
cat > "$H3_WORKDIR/prompt.t2i.txt" <<'EOF'
A square studio product photograph of a single cobalt-blue ceramic cup on a pale beige table. The whole cup and its handle are visible, centered with generous empty space around them. The glazed surface has subtle highlights and a slightly handmade texture. Soft daylight comes from the upper left, creating a natural shadow toward the lower right. The background is plain and warm, with no extra objects. Use realistic proportions and a calm editorial composition.
EOF

python "$H3_WORKDIR/models/MiniMax-H3-Image/examples/t2i.py" \
  --url http://127.0.0.1:30000 \
  --prompt "$H3_WORKDIR/prompt.t2i.txt" \
  --size 2048x2048 \
--out "$H3_WORKDIR/outputs/local-t2i-001.png"官方t2i.py从同目录的request.t2i.json读取请求,再用参数覆盖提示词和尺寸。当前示例使用seed 42、CPU随机数生成器、PNG和Base64返回,随后保存第一张图片。
SGLang文档要求省略采样步数或设为6,省略guidance或设为1,且不支持negative prompt。先保留官方脚本的这些设置,避免套入其他扩散模型的负向词和几十步采样参数。
截至2026年11月,SGLang默认最小生成面积是2048×2048。保留该默认值而请求1024×1024时,会先在较大画布生成再缩小,所以小输出不等于相同比例的计算量下降。
6. 上传两张参考图,完成本地编辑
SGLang的本地编辑接口使用multipart表单,按重复image字段的上传顺序定义参考图编号。
先准备自己有权使用的蓝色杯子商品图和桌面场景图,放入inputs目录,依次命名为ref1.png与ref2.png。下面将图1作为商品主体、图2作为场景参考;只使用文件名并不会让服务器自动读取这些图片。
cat > "$H3_WORKDIR/prompt.edit.txt" <<'EOF'
Create a realistic product photograph using <Picture 1> as the reference for the cup and <Picture 2> as the reference for the tabletop and lighting. Place the cup on the tabletop in a physically plausible position. Preserve the cup's shape, handle, blue glaze and visible markings from <Picture 1>. Follow the light direction in <Picture 2> and add a matching contact shadow. Keep the surrounding scene simple and do not add extra cups.
EOF

python "$H3_WORKDIR/models/MiniMax-H3-Image/examples/edit.py" \
  --url http://127.0.0.1:30000 \
  --prompt "$H3_WORKDIR/prompt.edit.txt" \
  --image "$H3_WORKDIR/inputs/ref1.png" \
  --image "$H3_WORKDIR/inputs/ref2.png" \
  --size 2048x2048 \
  --seed 42 \
  --out "$H3_WORKDIR/outputs/local-edit-001.png"
模型卡标注最多16张参考图,但本例只验证双图请求的组织方式。参考图更多、尺寸更大时,应重新检查资源占用和主体保持情况,不把支持上限当作交付保证。
上述两个官方脚本都会覆盖同名输出,重复运行时请更换--out文件名。它们不是完整的生产错误处理程序,失败后可能留下空文件,保存成功后仍须检查图片能否解码。
python - <<'PY'
import os
from pathlib import Path
from PIL import Image
output_dir = Path(os.environ["H3_WORKDIR"]) / "outputs"
for name in ("local-t2i-001.png", "local-edit-001.png"):
    path = output_dir / name
    if not path.is_file():
        raise SystemExit(f"Missing output: {path}")
    with Image.open(path) as image:
        if image.format != "PNG" or image.size != (2048, 2048):
            raise SystemExit(f"Unexpected image: {path}, {image.format}, {image.size}")
        image.verify()
    with Image.open(path) as image:
        image.load()
    print("Verified PNG, 2048x2048:", path)
PY
再人工查看杯子轮廓、标识、投影和背景变化。记录提示词、参考图顺序、尺寸、seed、模型revision和框架commit;仅固定seed不能保证跨硬件或精度逐像素相同。
7. ComfyUI、低显存和提示词扩写怎样衔接
其他部署入口需要按各自的权重格式和工作流运行,不应混用安装步骤与显存结论。
2026年11月的ComfyUI官方教程要求ComfyUI至少0.45.0、模板包至少0.11.104,提供文生图与编辑工作流。该路径使用Comfy-Org转换的INT8权重,应按教程放入对应模型目录,再加载模板;它不是本篇BF16服务器的同一精度配置。
Diffusers当前提供的是Modular Diffusers blocks集成,需要对应源码版本;vLLM-Omni也有独立部署配方。若已有这些环境,可直接沿各自官方指南继续,不必同时安装四套框架。
低显存机器应从SGLang硬件选择器生成对应offload配置,保留其主存和NVMe前提。不要只复制一个offload开关就承诺某张消费卡能运行,也不要把修改最小生成面积当作无损加速。
可选PE目前提供本地文生图扩写。它需要额外权重和推理服务,与图像服务同时运行时应使用不同端口;编辑扩写的完整本地替代仍不能按已交付功能描述。
官方示例中的context_ir.py会调用远程MiniMax服务。希望保持生成链路全本地时,可继续手写完整描述;本地与原厂API对比,也应记录是否经过Context-IR扩写。
8. 按环境、文件和资源顺序排错
H3-Image部署失败时,先定位失败阶段,再调整配置,避免同时更换框架、权重和精度。
命令不识别模型:确认客户端与服务端使用同一个虚拟环境,源码checkout与本文commit一致,安装的是
python[diffusion]依赖;不要在旧环境直接覆盖多个版本。缺编码器或重复下载:检查
--text-encoder-path是否指向真正的text_encoder/,确认分片和索引完整;查看图像目录是否混入与外部声明冲突的同名目录。显存或主存不足:记录是加载、warmup、编码还是VAE解码阶段失败,再按官方配方调整放置策略。offload同样可能耗尽主存或受NVMe传输限制。
健康检查失败:确认启动日志、30000端口和请求所在机器;
127.0.0.1表示当前机器,远程客户端不能拿自己的回环地址访问服务器。输出为空或效果与API不同:先检查HTTP与服务端日志,再检查输出解码;对比完整提示词、扩写流程、参考图顺序及精度,不用反复重试代替定位原因。
最后再核对许可。2026年11月10日版本的社区协议规定,使用者及/或关联方年化收入超过100万美元,或向第三方提供托管服务,任一条件成立都需要事先书面授权;另有地域、标识、再分发等条件。
依据MiniMax官方模型卡和SGLang部署资料,本地链路可以从固定权重、完整描述和单张请求开始,再逐步增加编辑与并发。完成安装后,还需要在目标硬件验收容量、耗时和画面质量;本文资料截至2026年11月11日。
参考资料
MiniMax H3-Image 官方模型卡:https://huggingface.co/MiniMaxAI/MiniMax-H3-Image
MiniMax H3-Image 社区许可证:https://huggingface.co/MiniMaxAI/MiniMax-H3-Image/blob/main/LICENSE
SGLang H3-Image 部署配方:https://docs.sglang.io/cookbook/diffusion/MiniMax/MiniMax-H3-Image
SGLang 安装文档:https://docs.sglang.io/docs/get-started/install
SGLang Diffusion 安装文档:https://docs.sglang.io/docs/sglang-diffusion/installation
SGLang 固定版本源码:https://github.com/sgl-project/sglang/tree/a93e89fd4a4eefb52c3ce73a609317d716d2a6ab
uv 官方安装文档:https://docs.astral.sh/uv/getting-started/installation/
Rust 官方安装文档:https://rust-lang.org/tools/install/
MiniMax-H3 编码器固定版本:https://huggingface.co/MiniMaxAI/MiniMax-H3/tree/0919fb684102ef115126612f3fbb84d1027e7317/text_encoder
Hugging Face CLI 下载文档:https://huggingface.co/docs/huggingface_hub/guides/cli
MiniMax H3-Image 官方示例:https://huggingface.co/MiniMaxAI/MiniMax-H3-Image/tree/main/examples
MiniMax H3-Image-PE 官方模型卡:https://huggingface.co/MiniMaxAI/MiniMax-H3-Image-PE
ComfyUI H3-Image 官方教程:https://docs.comfy.org/tutorials/image/minimax/minimax-h3-image
Diffusers H3-Image 官方文档:https://huggingface.co/docs/diffusers/main/en/api/pipelines/minimax_h3_image
vLLM-Omni H3-Image 部署配方:https://recipes.vllm.ai/MiniMaxAI/MiniMax-H3-Image
相关文章
七牛云产品
七牛云对象存储 Kodo:https://www.qiniu.com/products/kodo
七牛云Token Plan 企业订阅(低至1.2折):https://www.qiniu.com/ai/tokenplan
七牛云10亿 Token 免费送:https://www.qiniu.com/ai/model/qiniu/conatus-free