Gemini 3.5翻译上线:流式API能力解析与快速接入实战
跨语言沟通的痛点往往在于高昂的延迟成本。传统语音翻译API需要经历完整的录制、上传、推理、返回链路,几秒钟的停顿足以打断一场流畅的跨国会议或跨语种直播。Gemini 3.5翻译上线:流式API能力解析与快速接入,正是为了打破这种交互壁垒。通过原生的双向流式处理机制,开发者现在能够构建真正意义上边听边译的无缝交互应用。
Gemini 3.5流式处理技术解析与底层架构
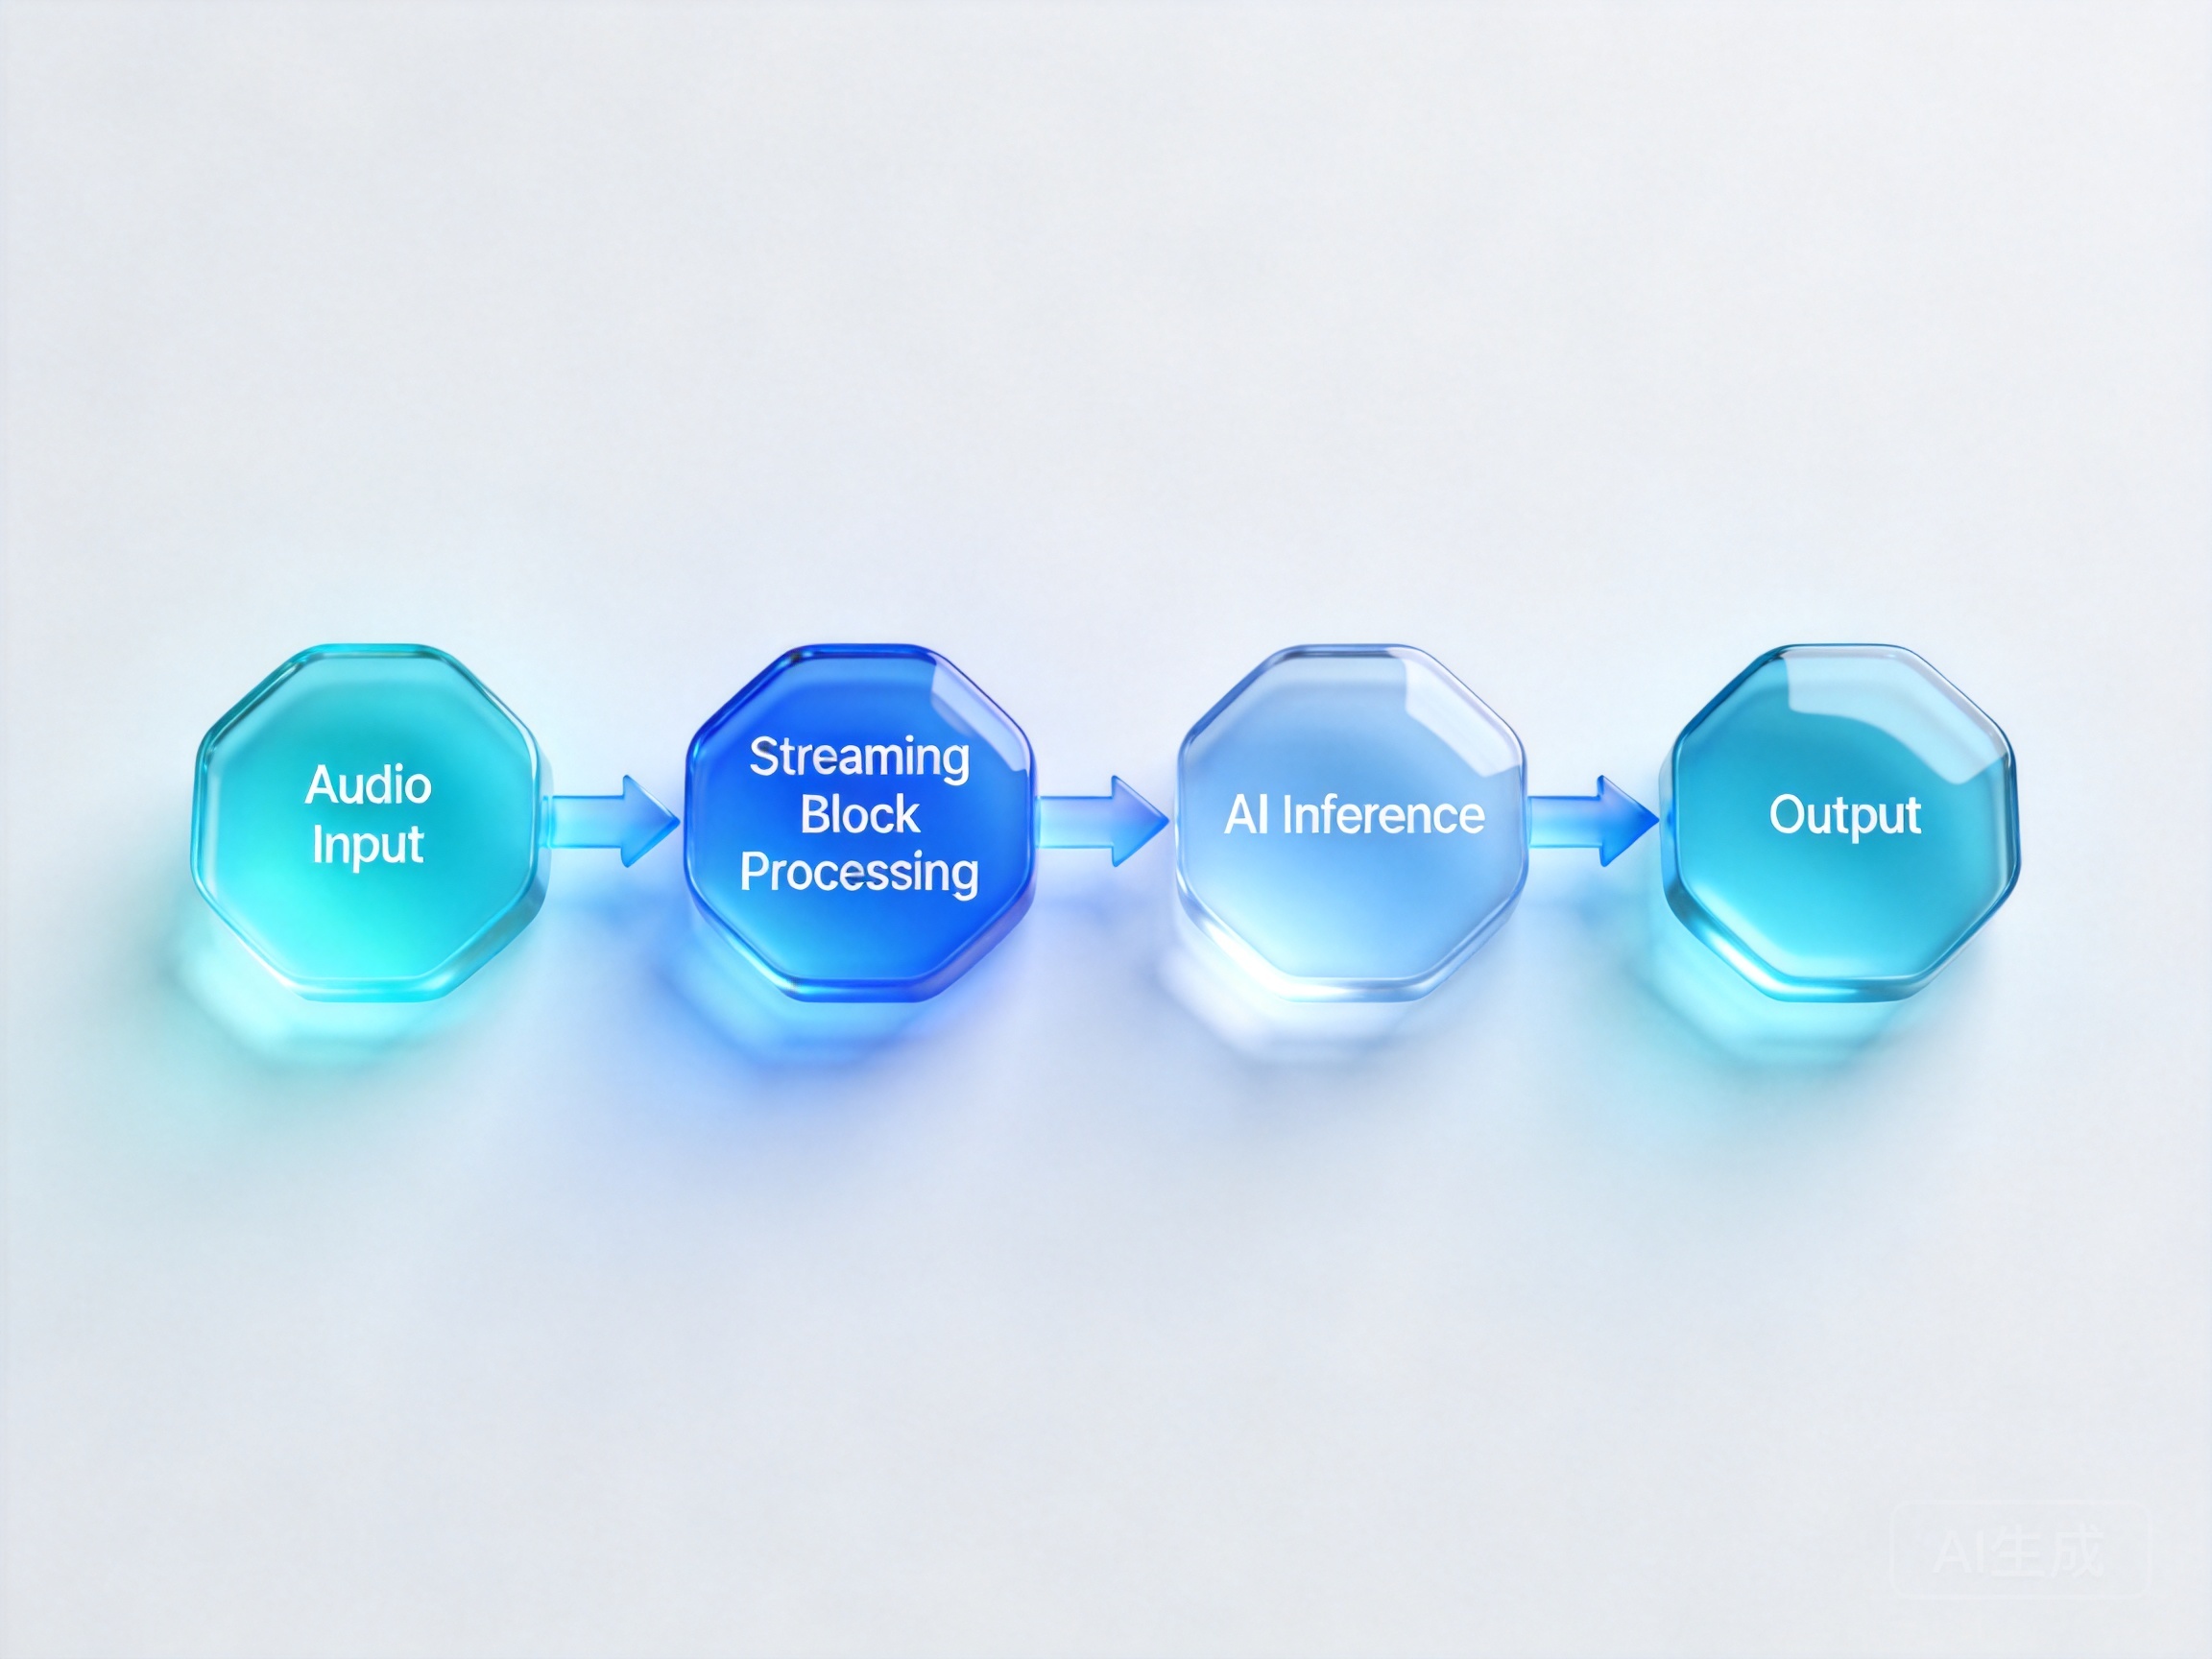
探究其卓越表现的根源,必须深入Gemini 3.5实时语音互译低延迟架构方案。区别于传统的级联模型(即语音转文本、文本翻译、文本转语音三个独立步骤),Gemini 3.5采用了端到端的多模态流式输入输出设计。
在这一架构中,客户端将音频数据切割成极小的毫秒级音频帧,通过WebSocket长连接持续推送到云端。模型在接收到初始音频块的瞬间,便开始进行特征提取与上下文意图预测,无需等待整句话结束即可吐出首个翻译Token。这种边接收、边推理、边输出的机制,将端到端延迟压缩到了极致。
针对复杂应用环境,业界也总结出了详尽的流式AI翻译抗噪能力优化与开发教程。Gemini 3.5在底层训练中强化了声学特征的分离能力,能够在嘈杂的街道或嘈杂的会议室背景中,动态过滤非人声频段。开发者在前端采集时配合简单的降噪算法,即可大幅提升流式翻译的连贯性和准确率,避免因环境噪音导致的翻译中断或误判。
实时语音互译API快速接入指南
接入 Gemini 流式翻译能力时,应先查阅 Google 官方文档,确认账户权限、接口版本和音频格式要求。
通过模型提供商的官方控制台获取调用凭证后,应先核对计费和配额,再按官方接口要求完成开发与联调。开发流程主要分为三步:
- 建立长连接:使用客户端库或原生WebSocket向服务端发起连接请求,并在请求头中带上刚刚获取的API Key进行鉴权。
- 配置会话参数:在连接建立后的初始帧中,发送JSON格式的配置信息,指定输入音频的采样率、编码格式以及目标翻译语种。
- 双工数据传输:客户端持续以二进制形式发送麦克风采集的音频分块,同时异步监听服务端返回的事件流,解析并渲染翻译后的文本或直接播放合成的语音数据。
Gemini Live API多语言同步翻译实践指南
在实际的全球化业务中,处理多语言混合输入是一大技术挑战。虽然模型具备自动语种识别能力,但在极致要求低延迟的流式场景下,建议在初始化请求时明确指定源语言和目标语言,以此消除模型初期的语种判断耗时。
复杂场景需要稳健的重连机制和音频帧序列管理,确保弱网环境下翻译内容不乱序、不丢失。参数、计费和高级接口能力应以 Google 官方文档为准。
流式架构正在彻底重塑AI应用的交互体验。从被动等待整句翻译到毫秒级的实时响应,Gemini 3.5的底层技术革新为出海电商、跨国客服和实时社交提供了极具竞争力的技术底座。研发团队应当尽早利用成熟的开放平台完成接口跑通与业务联调,在下一波自然语言交互革命中抢占市场先机。