AI与智能服务
未读
GLM-5.3 发布:基座不换只炼后训,开源编程能力超越 Claude Opus 4.8
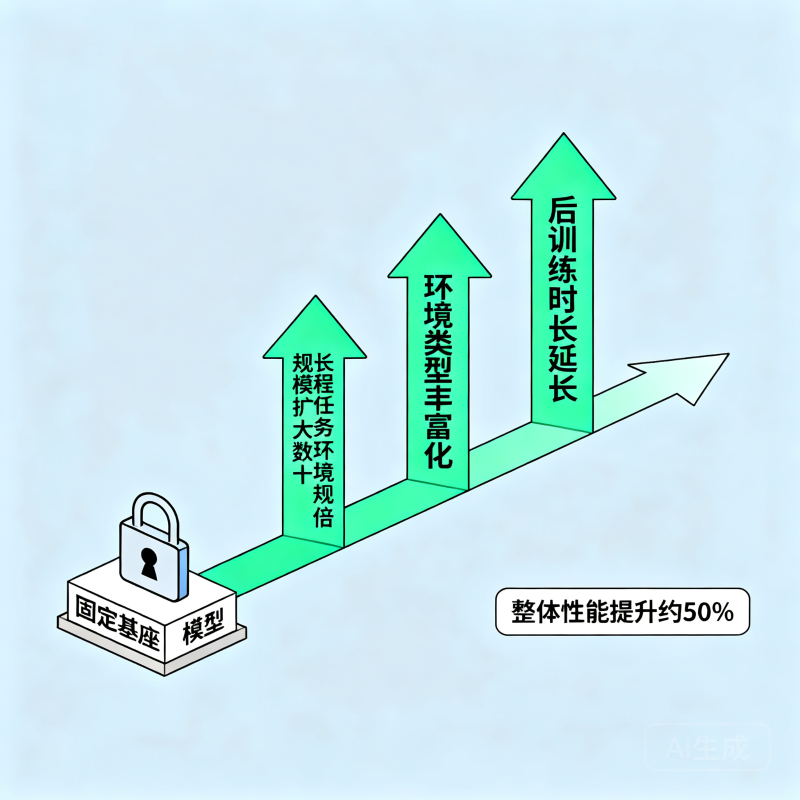
数据来源:智谱 AI 官方公告 | 话题:GLM-5.3 · 智谱 AI · 开源大模型 · Agent 编程 GLM-5.3 于 2026 年 8 月 14 日中午正式发布,是智谱 AI GLM-5 系列的最新版本;与 GLM-5.2 的核心差异在于技术路线——基座模型参数量(约 7430 亿,M
AI与智能服务
未读
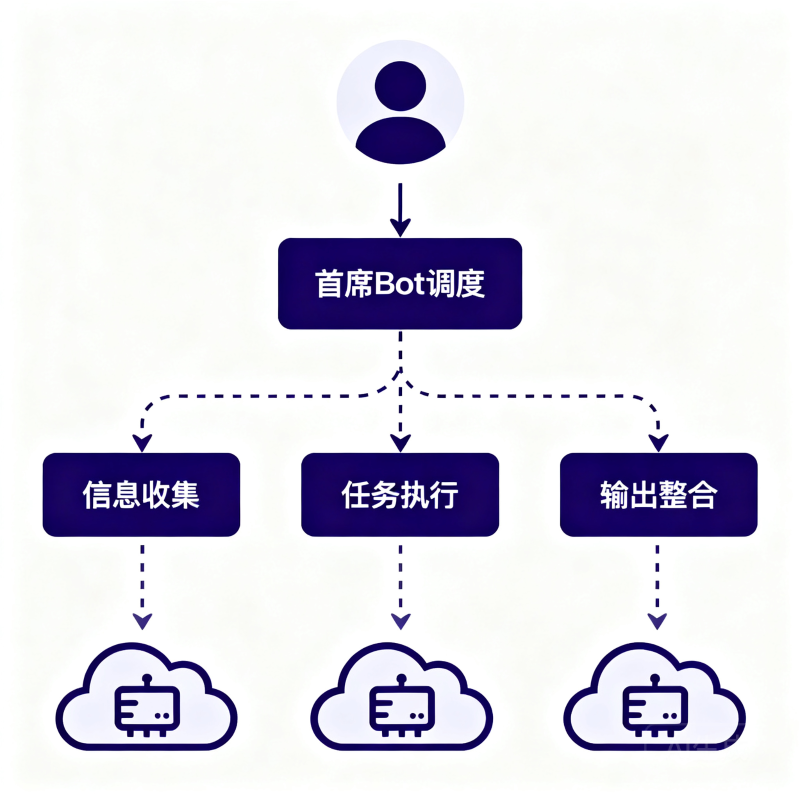
Grok Bots 是什么:xAI 的全天候 AI 队友,独占云电脑、无需 API、合上电脑照样干活
发布日期:2026-08-14 | 数据来源:xAI 官网、xAI Grok 4.5 发布公告| 话题:Grok Bots · xAI · AI Agent · 云电脑 Grok Bots 是 xAI 于 2026 年 8 月 11 日正式推出的 AI Agent 产品(早期测试版),由 xAI 与
AI与智能服务
未读
DeepSeek Harness 部署指南:从 npx 一键启动到 Python SDK 完整接入
发布日期:2026-08-14 | 数据来源:deepseek-ai/deepseek-harness 官方 GitHub 文档、53AI 首批实测 | 话题:DeepSeek Harness · dsh · Agent 部署 · Python SDK DeepSeek Harness(命令行名 d
AI与智能服务
未读
Gemini 3.7 Flash 发布:三周迭代、价格腰斩,编程与 Agent 能力全面拆解
发布日期:2026-08-14 | 数据来源:Google DeepMind 官网、Google AI for Developers | 话题:Gemini 3.7 Flash · Google AI · Agent 能力 · API 接入 Gemini 3.7 Flash 于 2026 年 8 月
AI与智能服务
未读
轻量级大模型边缘部署与GPU显存优化
企业在推进AI业务落地时,常常面临云端推理延迟高、数据隐私保护难的双重挑战。将百亿参数级别的模型下放到工厂质检设备、智能终端或车载计算平台,已经成为不可逆的技术趋势。然而,边缘设备的算力与显存资源极为受限。要在功耗和硬件成本的戴着镣铐下跳舞,轻量级开源大模型边缘侧部署:基于Nvidia新架构的推理加
AI与智能服务
未读
Cursor集成Grok 4.6:云端协同提效实战与企业级架构配置指南
面对数十万行的祖传代码,传统IDE的检索和重构能力往往捉襟见肘。开发团队在处理跨文件逻辑联动时,常常因为上下文丢失而引发线上事故。为了彻底解决这一痛点,Cursor全面集成Grok 4.6模型:云端协同编码环境搭建与企业项目提效实战成为了技术团队破局的关键路径。Grok 4.6凭借其惊人的长上下文处
AI与智能服务
未读
Gemini 3.7 Flash长上下文RAG优化:打破推理瓶颈与幻觉克星
当企业尝试将数十万字的财报、技术文档或法律合同直接喂给大模型时,往往会遭遇一个尴尬的现实:模型要么在海量信息中“迷失”,遗漏关键细节;要么为了强行回答而胡编乱造。解决这一痛点的关键,正是Gemini 3.7 Flash长上下文RAG优化:文档推理召回率提升与幻觉规避策略。拥有百万级上下文窗口的Gem
AI与智能服务
未读
DeepSeek Harness vs Grok Build:企业级AI代理选型指南与成本优化实战
企业在步入智能化转型深水区时,往往会面临一个棘手的技术决策:面对市场上琳琅满目的开发工具,究竟该如何为团队挑选最契合的底层支撑?特别是当研发团队需要在极其有限的预算内,快速落地具备复杂推理和工具调用能力的智能体时,选型失误往往意味着高昂的重构成本。本文将围绕 DeepSeek Harness vs
AI与智能服务
未读
Qwen3.8私有化部署与推理优化:MoE架构下的显存管理与多卡协同实战
面对动辄千GB级别的显存需求,如何将万亿参数巨兽关进企业自己的机房,成为许多技术团队面临的现实难题。完成一次完整的Qwen3.8万亿参数模型私有化部署:从多卡并行切分到企业级推理优化全流程,不仅是对硬件算力的考验,更是对底层通信框架与显存调度策略的极限压榨。本文将跳出常规的基础环境配置,直接切入核心