AI与智能服务
未读
社交广告大模型接入与Snap动态生成部署实战
当用户在社交媒体信息流中极速滑动时,留给广告素材吸引注意力的时间不到半秒。传统的静态广告素材早已无法满足千人千面的个性化需求,实时生成匹配用户兴趣的商品图像成为破局关键。然而,要在毫秒级延迟内完成高质量的图像生成,对底层架构提出了极高要求。本文将深入探讨社交广告场景接入大模型:Snap动态产品生成架
AI与智能服务
未读
突破边界:Claude Opus 5全平台上线后的网安风控与开发者实战
当开发团队满怀期待地准备将最新一代大语言模型接入核心业务时,往往会遭遇意想不到的阻碍。数据合规审查、接口限流报警以及难以预测的调用成本,让原本激动人心的技术升级变成了运维噩梦。Claude Opus 5全平台上线:网安风控策略与开发者适配指南不仅是当前技术圈的热议话题,更是摆在每一位技术负责人面前的
AI与智能服务
未读
告别一本正经的胡说八道:本地知识库RAG多路召回与幻觉治理指南
企业在构建内部问答系统时,经常会遇到大模型“一本正经地胡说八道”的尴尬场景。明明已经接入了内部文档,AI却依然会编造出不存在的产品参数或虚构公司规章制度。要彻底根治这一痛点,单一的向量检索往往力不从心。实施本地知识库RAG系统优化:多路召回策略与大模型幻觉解决方案,已经成为当前企业级AI应用落地的必
AI与智能服务
未读
拒绝糊涂账:vLLM vs 云端API推理成本实测与吞吐量优化指南
很多研发团队在上线内部代码辅助工具时,都会卡在算力账单这一关。到底是直接调用现成的云端接口,还是租用算力节点自己搞私有化部署?为了算清楚这笔账,我们针对“vLLM vs 云端API推理:代码生成大模型吞吐量与成本实测”展开了一次硬核对比。这不仅是简单的单价拼杀,更是对底层调度机制和实际并发承载力的极
AI与智能服务
未读
企业级大模型私有化部署:GPU配置与推理加速指南
当核心业务数据成为企业的生命线,将敏感信息直接输送给公有云API显然已不再是明智之举。越来越多的技术团队开始将目光转向内部,试图建立完全自主可控的AI基础设施。掌握企业级大模型私有化部署:从GPU环境配置到推理加速完整流程,已经成为现代企业IT架构升级的必修课。这并非简单地将开源模型下载到本地运行,
AI与智能服务
未读
企业级多智能体协同:Agent通信架构解析
当单个大模型无法满足企业复杂的业务流转时,多智能体(Multi-Agent)的组合便成了破局的关键。真实的业务场景往往包含需求分析、代码编写、测试验证等多个环节,单打独斗的Agent极易在长链路中“迷失”。此时,企业级多智能体协同爆发:Agent通信架构解析与业务边界设定成为了技术架构师们必须攻克的
AI与智能服务
未读
AI编码助手工具链迭代及联通踩坑实录
很多研发团队在尝试将大语言模型接入日常开发流程时,都会遭遇巨大的预期落差。本地算力跑不动顶级模型,而直接调用公共云端API又常常因为上下文割裂导致生成的代码完全无法运行。这正是我们团队在进行AI编码助手工具链迭代:云端模型与本地环境联通踩坑实录中最为深刻的体会。为了打破这种割裂感,找到稳定高效的云端
AI与智能服务
未读
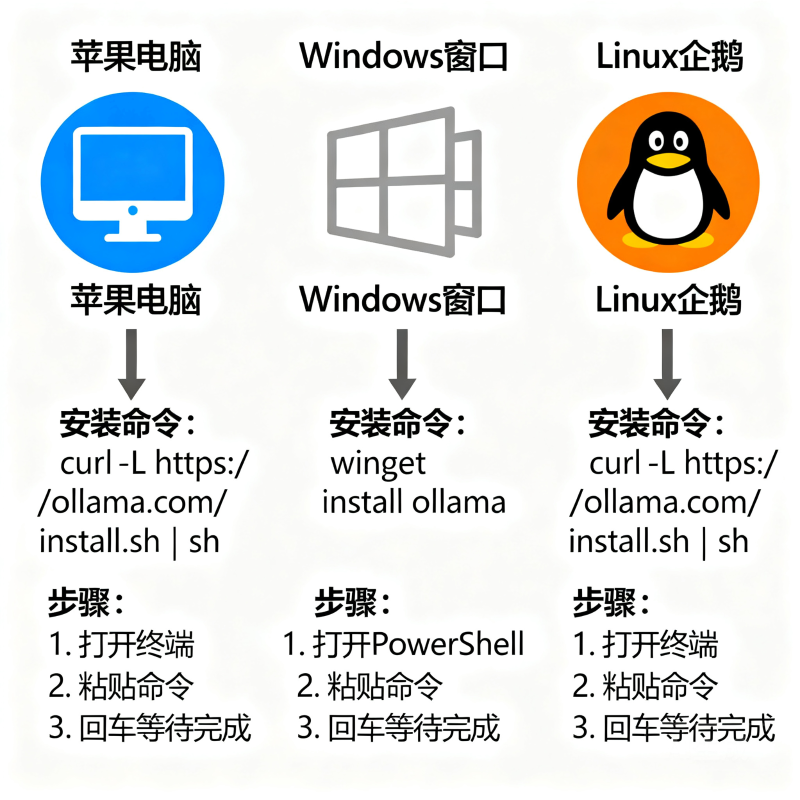
Ollama 本地部署 DeepSeek:macOS / Windows / Linux 三端完整教程
关键词:Ollama / DeepSeek / 本地部署 / LLM Ollama 是目前最流行的本地大模型运行工具,GitHub 累计 176,741 Star,底层基于 Georgi Gerganov 的 llama.cpp 项目,支持 macOS、Windows、Linux 三端一键安装,三条
AI与智能服务
未读
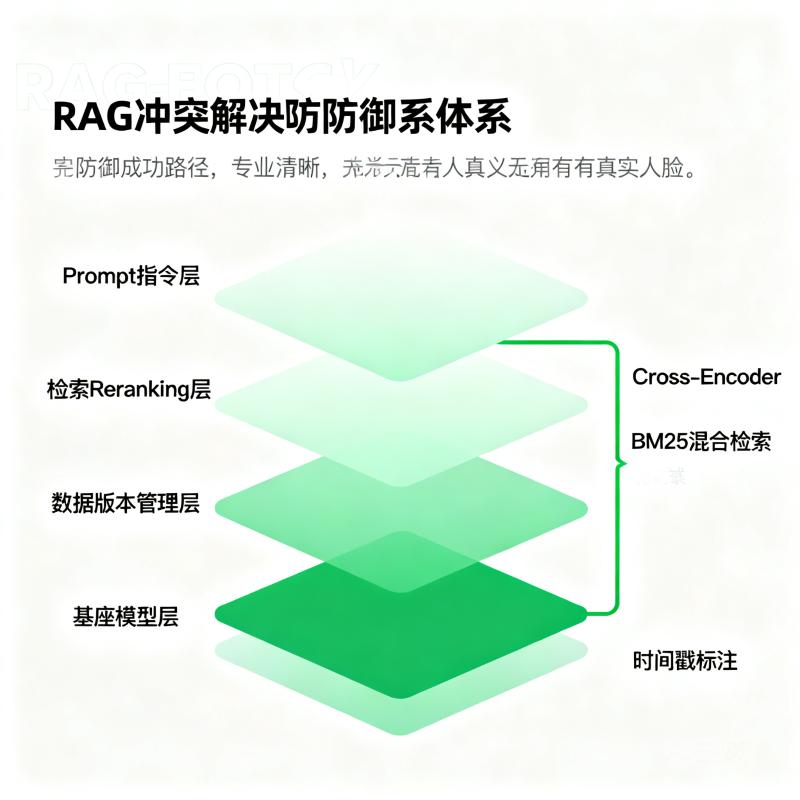
为什么你的 RAG 应用会「打架」:上下文冲突三类根因与解法
关键词:RAG / 上下文冲突 / 知识冲突 / LLM / 检索增强生成 RAG 最难搞的问题不是检索命中率,而是冲突:检索回来的内容和模型自身的训练记忆打架,或者多个检索块之间互相矛盾,导致 LLM 要么固执地忽略你精心准备的知识库,要么盲目相信明显错误的检索结果。清华大学、剑桥大学与西湖大学联