AI与智能服务
未读
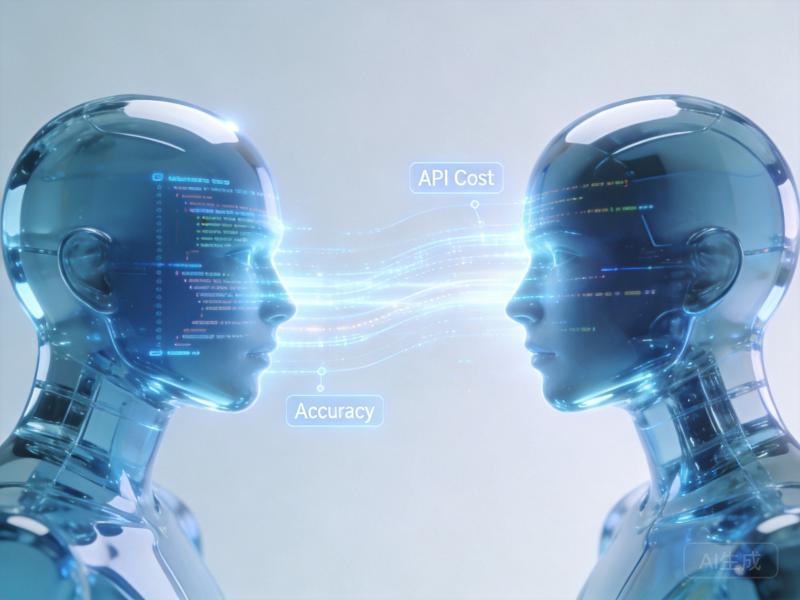
Grok 4.5 vs Opus代码生成实测:API成本与推理准确率对比
开发团队在引入大语言模型辅助编程时,往往会陷入一个两难境地:顶级模型能写出优雅的复杂架构代码,但高昂的账单让人望而却步;平价模型虽然便宜,却频频输出带有明显逻辑漏洞的废代码。为了打破这种信息差,我们开展了本次 Grok 4.5 vs Opus代码生成实测:API成本与推理准确率对比,试图从真实的工程
AI与智能服务
未读
Hermes 多 Agent 完整拆解:五种协作机制、选型边界与踩坑清单
发布日期:2026-07-27 | 关键词:Hermes Agent、多 Agent、delegate_task、Kanban 编排、Nous Research 适用版本:Hermes Agent v0.19.0(v2026.7.20) Hermes Agent 的多 Agent 能力是 Nous
AI与智能服务
未读
Hermes Agent MOA 教程:让多个模型同时答题再合并,实测超过单一顶级模型
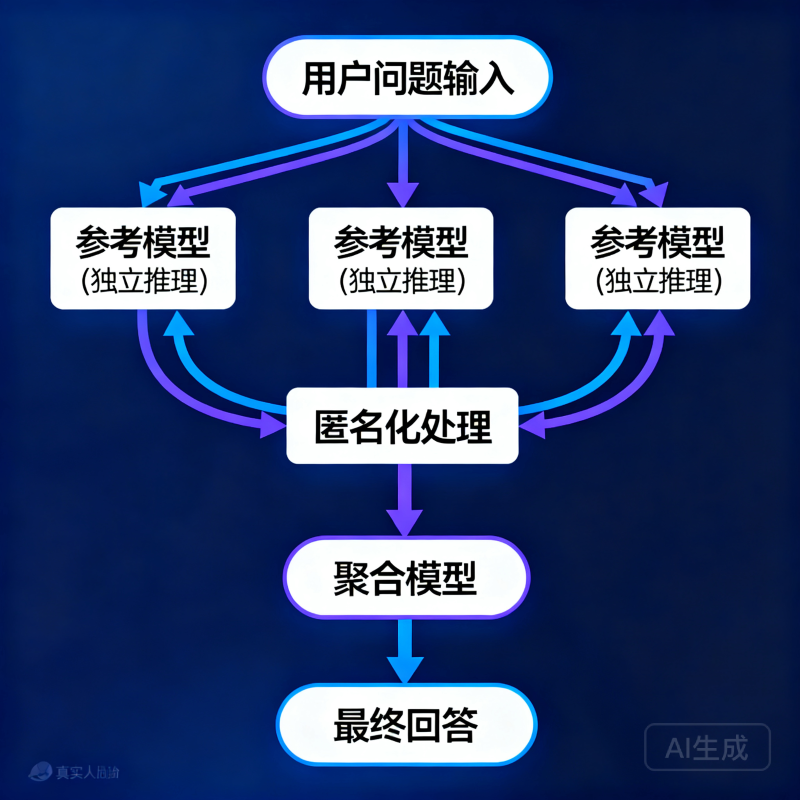
关键词:Hermes Agent / MOA / Mixture of Agents / 多模型协作 MOA(Mixture of Agents)是 Together AI 联合斯坦福、芝加哥大学、杜克大学于 2024 年提出的多模型协作推理架构,核心思路是:同时让多个参考模型独立回答问题,把它们的
AI与智能服务
未读
ZCode 安装使用完整指南:智谱 ADE 桌面端从下载到跑通第一个任务
关键词:ZCode、智谱、GLM-5.2、Agentic Development Environment、AI 编程 适用版本:ZCode v3.5.2(macOS / Windows),Linux 内测中ZCode 是智谱 AI(Z.ai)于 2025 年 12 月 26 日发布的 Agentic
AI与智能服务
未读
Claude 模型怎么选:Opus 5、Sonnet 5、Fable 5 一文搞懂
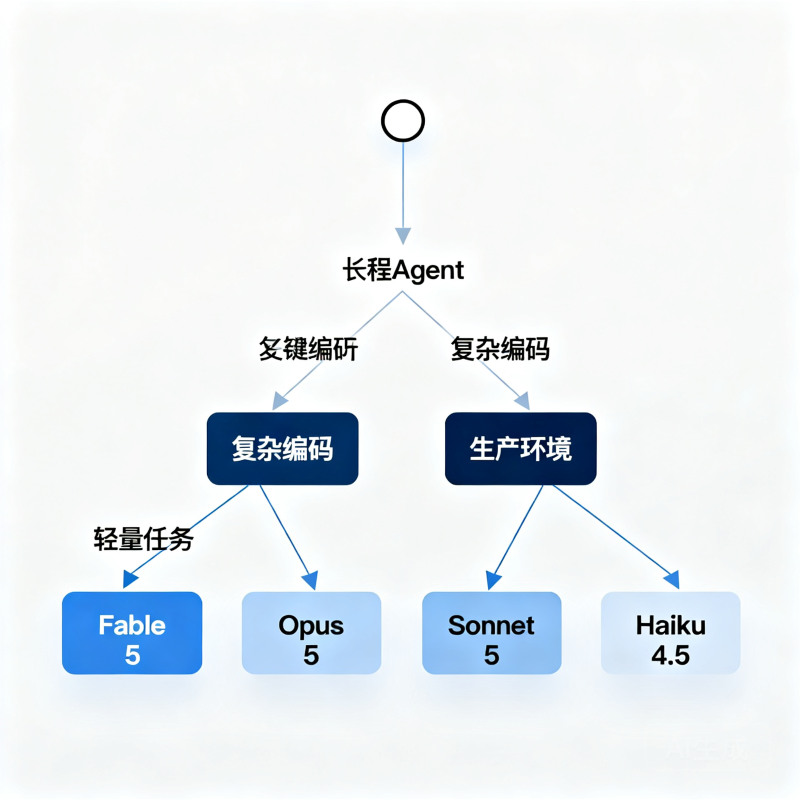
数据来源:Anthropic 官方文档(platform.claude.com)、Anthropic 定价页(claude.com/pricing) 时效性:截至 2026 年 7 月,Sonnet 5 introductory pricing 将于 2026-08-31 结束Claude 是 An
AI与智能服务
未读
Claude Opus 5版深度评测:性能翻倍架构与API调用成本实测
当开发者在复杂业务场景中尝试落地大语言模型时,往往会面临一个两难的选择:要么忍受顶级模型高昂的Token账单,要么妥协于廉价模型的逻辑短板。Anthropic近期推出的新一代旗舰模型打破了这一僵局。本次为您带来Claude Opus 5版深度评测:性能翻倍架构与API调用成本实测,我们将剥离官方宣传
AI与智能服务
未读
大模型API定价战重塑与开发者应对策略
当近期四大前沿大模型集中发布:API定价战重塑与开发者应对策略成为技术圈热议的话题时,许多技术团队发现,原本高昂的AI推理成本正在经历断崖式下跌。从百万Token几十美元到如今几美分,这场大模型API定价战全景分析显示,算力普惠已经从口号变成了实打实的账单数字。但面对眼花缭乱的降价公告,单纯追逐低价
AI与智能服务
未读
Brave与Perplexity搜索API对比:准确率评估与智能体接入实战
当开发者试图为大模型插上互联网的翅膀时,往往会面临一个棘手的选择:是直接获取原始网页数据进行本地RAG(检索增强生成),还是依赖已经过AI消化的总结性答案?Brave Search vs Perplexity 这一对决正是该问题的核心缩影。在构建下一代AI应用时,AI搜索API准确率对比不仅关乎数据
AI与智能服务
未读
Gemini 2026版评测:深度研究能力拆解与企业级工作流集成实战
当研发团队面对海量技术文档和碎片化数据时,传统的问答式大模型往往只能给出表层摘要,难以胜任需要多步交叉验证的复杂调研。这种浅尝辄止的痛点,正是新一代模型着力解决的核心命题。本次开展的Gemini 2026版评测:深度研究能力拆解与工作流集成实战,彻底打破了我们对大模型“偏科”的刻板印象。它不仅在多模