蚂蚁开源 Ling-3.1-flash 部署指南:硬件准备、SGLang 启动与 API 验证
发布日期:2026-10-15
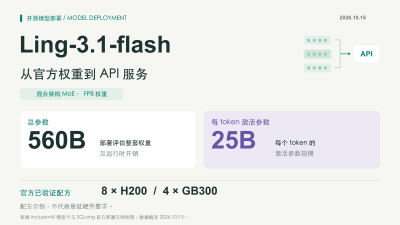
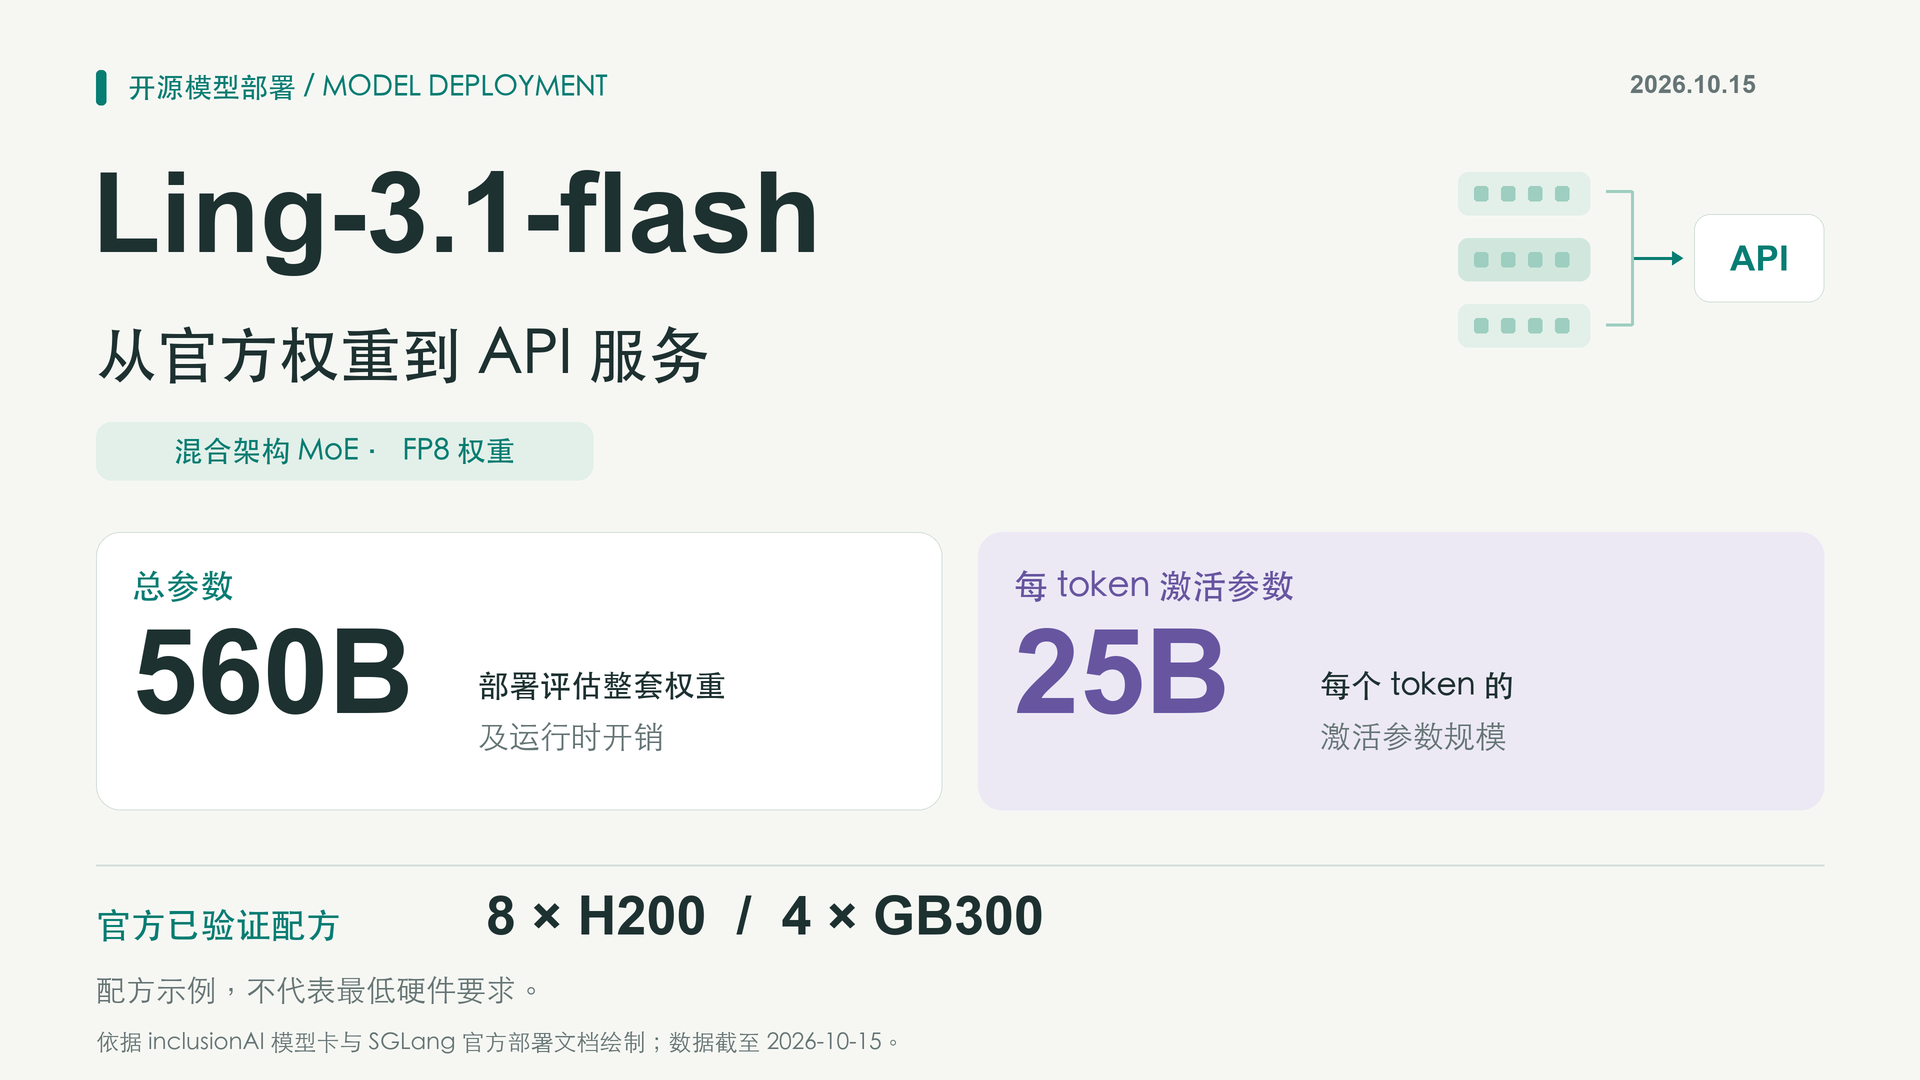
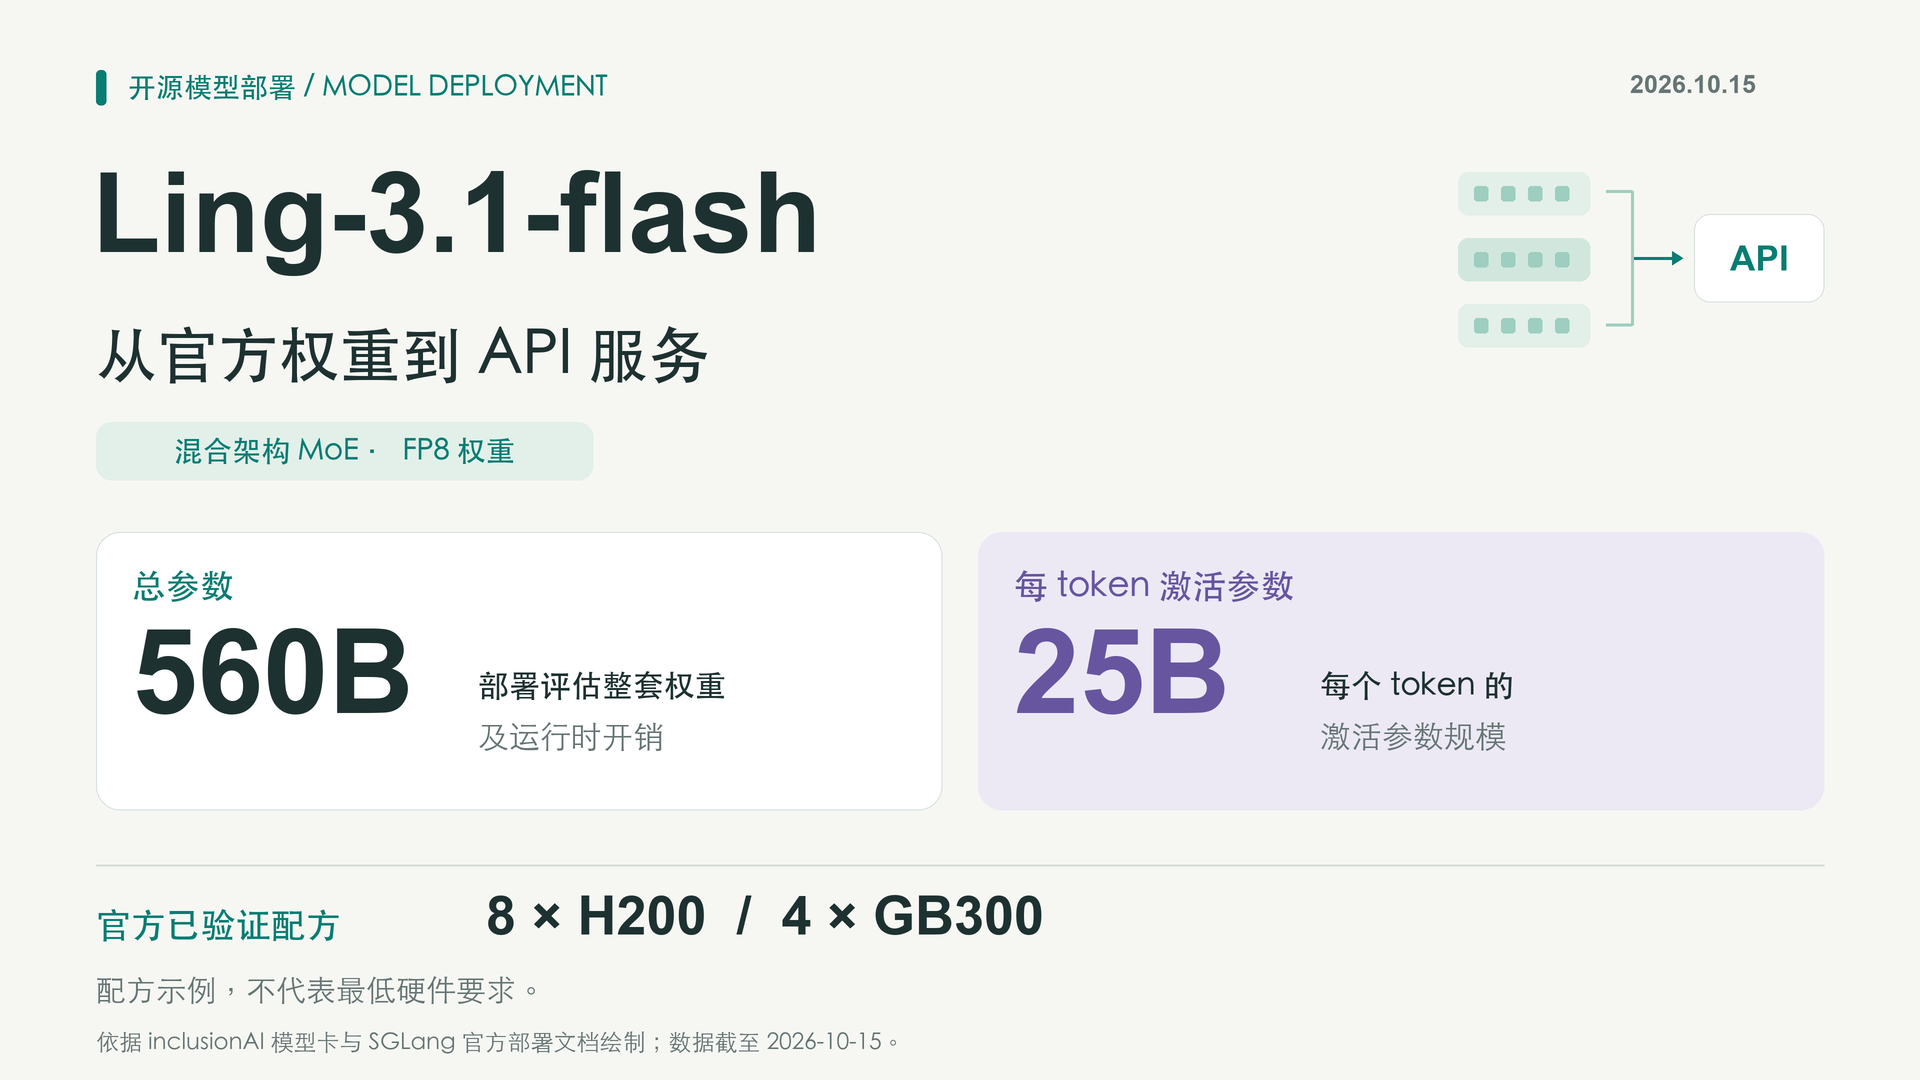
Ling-3.1-flash 是蚂蚁集团 inclusionAI 开源的混合架构 MoE 语言模型。截至 2026 年 10 月,官方模型卡标注总参数 560B、每 token 激活参数 25B,并提供 FP8 权重。自部署需要先确认整套权重、显存和推理框架的适配,不能按 25B 模型估算硬件。本文沿用官方 SGLang 专用镜像,以已验证的多卡配方为基础,完成环境检查、服务启动和 API 验证,同时说明 1M 标称上下文与当前部署配置的区别。
先看清模型规格,再准备机器
**Ling-3.1-flash 的 25B 指每 token 激活参数量,不代表部署只需加载 25B 权重。**据 inclusionAI 模型卡和配置文件,截至 2026 年 10 月,该模型采用混合注意力与 MoE 架构,模型类型为 bailing_hybrid,权重已配置 FP8 量化。
2026 年 10 月 15 日核对的官方仓库中,54 个 safetensors 分片合计约 573.8 GB。这是文件体积,运行时还需要缓存和其他开销,不能直接当作显存需求。磁盘也要为镜像、下载缓存和编译缓存预留额外空间。
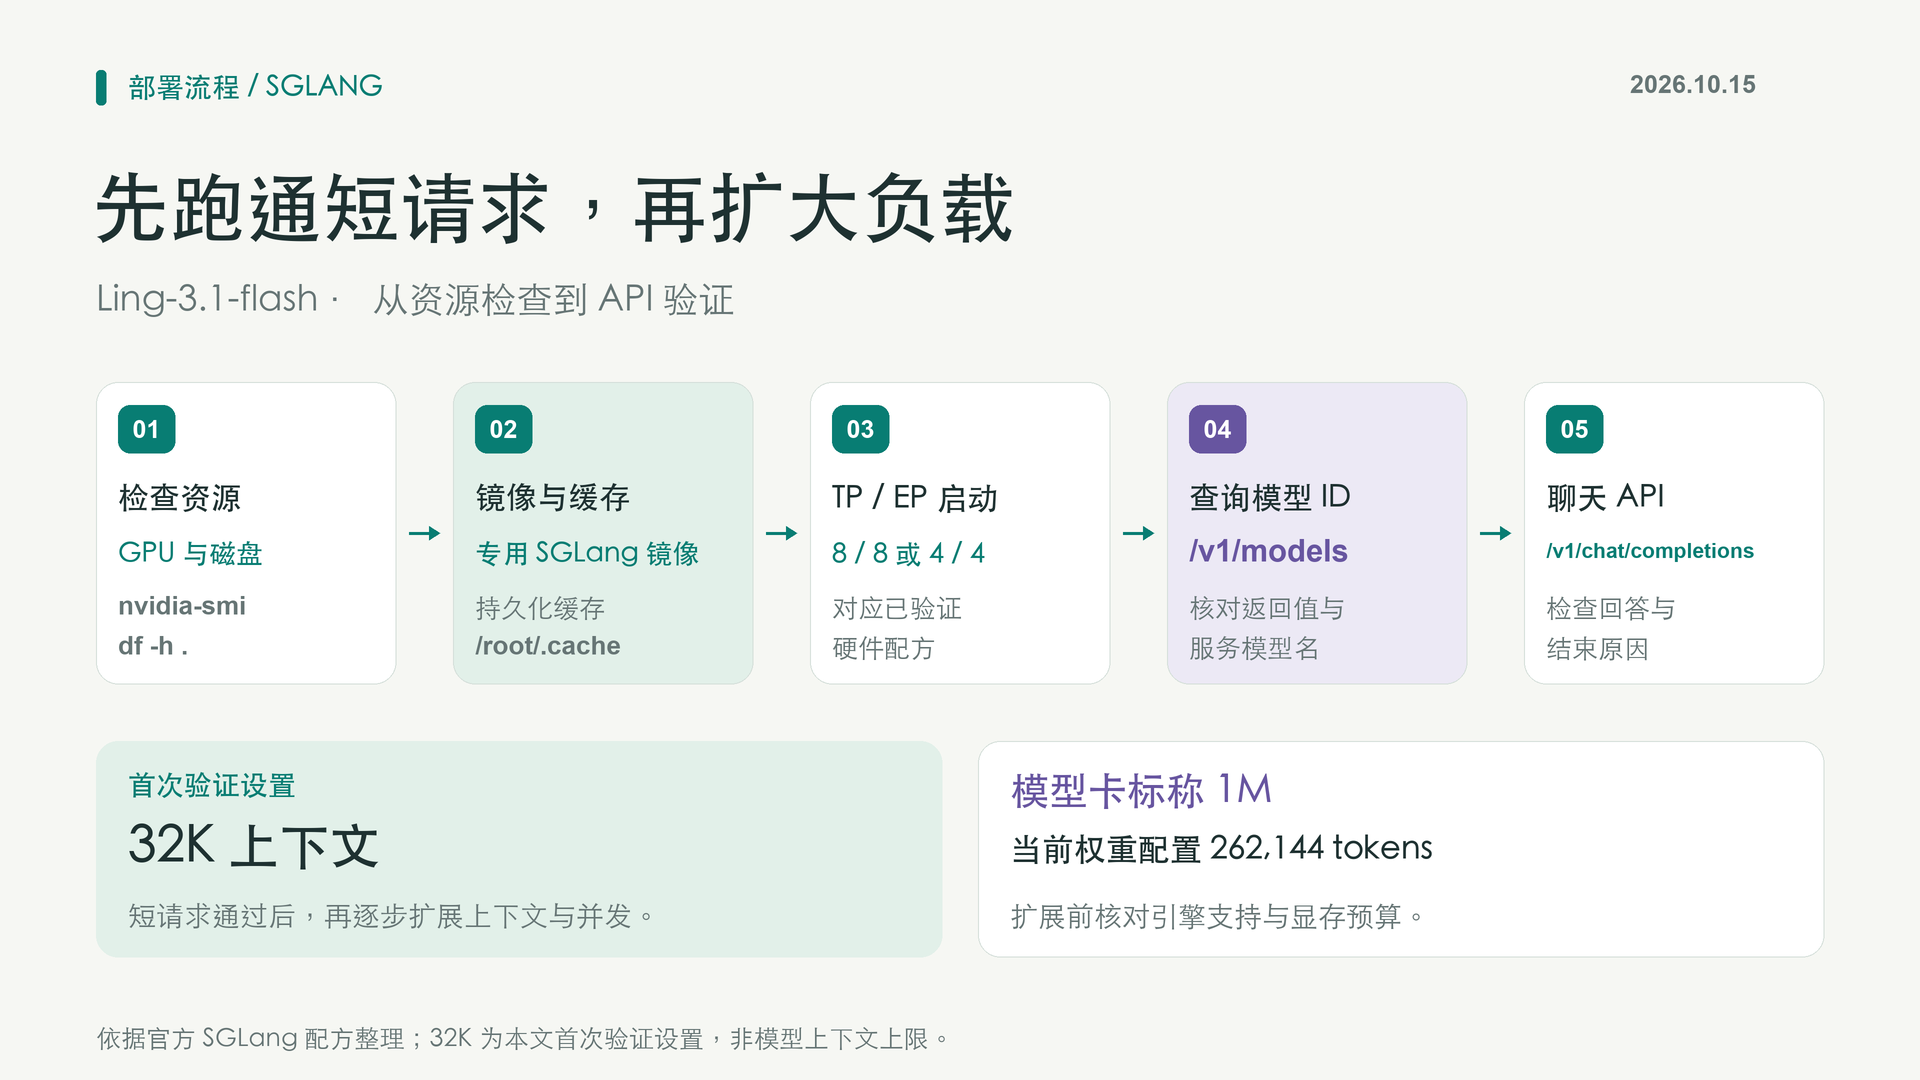
上下文有三个需要分清的口径:模型卡标称 1M;蚂蚁灵开发者文档 2026 年 10 月 14 日更新页写明,当前官方服务开放 256K;此次核对的权重配置与 SGLang 配方写的是 262,144 tokens。
**官方服务长度和自部署配置属于不同口径。**首次部署先使用较短上下文跑通请求,再结合当前权重、引擎支持和显存预算验证长上下文,不能只把启动参数改成 1M。
硬件按已验证配方准备
**截至 2026 年 10 月 15 日,SGLang 官方部署页明确验证了 H200 和 GB300 两组配方。**下表是官方示例,不是最低硬件要求。
同页虽然提供 H20-3e、H800、H100、B200 的命令,但标注为未验证,不能据此承诺可用。只有消费级单卡时,应先解决资源问题,再考虑启动命令。
以下步骤面向 Linux 多卡服务器,预先安装 NVIDIA 驱动、Docker 和 NVIDIA Container Toolkit,并按 NVIDIA 文档完成 Docker 运行时配置。本文核对的专用镜像内含 CUDA 13.0.3,按 NVIDIA 兼容表使用 580 或更新的兼容驱动。
先检查宿主 GPU、可用磁盘,以及 Docker 是否能访问 GPU:
nvidia-smi
df -h .
docker run --rm --runtime=nvidia --gpus all ubuntu nvidia-smi
最后一条应能列出 GPU。若宿主能看到显卡而 Docker 看不到,先处理驱动和 NVIDIA Container Toolkit 配置。镜像自带运行环境,不要求另外在宿主安装同版本 CUDA Toolkit。
拉取专用镜像,保留下载缓存
**首次部署使用模型卡指定的 dev-ling-3.1-flash 镜像,避免通用旧版缺少模型适配。**2026 年 10 月核对的 SGLang 文档也采用这一镜像。
mkdir -p ./ling-cache
docker pull lmsysorg/sglang:dev-ling-3.1-flash
后面的启动命令会把这个目录挂载到 /root/.cache,同时保留模型下载与相关编译缓存。首次启动会下载大体积权重,并可能编译内核;应结合下载进度、日志和 GPU 状态判断,不能仅凭等待时间认定服务卡死。
开发镜像标签和模型仓库都会变化。需要复现时,记录镜像 RepoDigest、权重提交和启动参数,避免不同时间运行同一个标签却得到不同环境。
用 SGLang 启动推理服务
**以下以官方 8 × H200 配方为基础,增加固定服务名和较短上下文,完成首次验证。**在刚才创建缓存目录的同一工作目录执行:
docker run --gpus all --network host --ipc=host --rm \
  -v "$PWD/ling-cache:/root/.cache" \
  -e SGLANG_ENABLE_FP8_BLOCK_GEMV=1 \
  -e SGLANG_ENABLE_FUSED_KDA_OUTPUT_QUANT=1 \
  lmsysorg/sglang:dev-ling-3.1-flash \
  python3 -m sglang.launch_server \
    --model-path inclusionAI/Ling-3.1-flash \
    --served-model-name Ling-3.1-flash \
    --tp 8 --ep 8 \
    --speculative-algorithm NEXTN \
    --context-length 32768 \
    --host 127.0.0.1 --port 30000
--tp 分配张量并行,--ep 分配专家并行;NEXTN 对应模型内置 MTP 的推测解码。两项环境变量启用 H200 解码优化。4 × GB300 按官方配方改为 --tp 4 --ep 4,可省略这两个环境变量,其余参数仍需结合实际机器验证。
这里的 32,768 是本文用于首次检查的上下文设置,不是模型上限,也不保证任意并发下都能装入显存。服务监听服务器本机地址,客户端测试也应先在该服务器上运行。
先查模型列表,再发聊天请求
**服务完成加载后,先确认 API 中的模型标识,再测试生成。**保持启动终端运行,另开一个服务器终端执行:
curl -sS --fail http://127.0.0.1:30000/v1/models返回列表中的模型 ID 应与启动时指定的 Ling-3.1-flash 一致。接着发一条短请求,先关闭思考模式,便于检查最终回答:
curl -sS --fail http://127.0.0.1:30000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "Ling-3.1-flash",
    "messages": [
      {"role": "user", "content": "用一句话解释混合专家模型。"}
    ],
    "chat_template_kwargs": {"enable_thinking": false},
    "temperature": 1.0,
    "top_p": 0.95,
    "top_k": 20,
    "max_tokens": 256,
    "stream": false
  }'
检查 choices[0].message.content 是否有回答,并查看 finish_reason。若为 length,说明触及输出预算,不能据此判断模型已完成回答。
SGLang 2026 年 10 月部署文档说明,ling3 解析器将思考内容放入 reasoning_content,最终回答放入 content。需要思考模式时把 enable_thinking 改为 true,同时增加输出预算,再验证业务效果。
遇到报错,按资源、版本、请求顺序排查
**首次部署排错应先确认资源和环境,再调整请求参数。**最常见的检查入口可以收敛为以下几项:
加载时显存不足:检查 GPU 数量和其他进程占用,核对 TP、EP 与硬件是否匹配;不要把 25B 激活参数当成权重规模。
生成时显存不足:降低上下文和并发,先保留短请求验证,再逐项扩大负载。
架构或算子不支持:确认实际使用专用镜像,排除误用旧 SGLang 环境。
API 模型名错误:以
/v1/models返回值和--served-model-name为准。回答为空或被截断:检查 HTTP 状态、输出预算、
finish_reason,以及思考与最终回答字段。重启后重复下载:确认工作目录及缓存挂载位置一致,检查目录权限和剩余空间。
inclusionAI 模型卡与 SGLang 官方部署文档共同给出了可核对的部署路径:先满足多卡资源,使用专用镜像,再验证 API 和实际任务。本文命令已按官方文档与对应源码核对,未在 GPU 服务器实跑;本文数据截至 2026 年 10 月 15 日,来源见文末参考资料。
参考资料
inclusionAI 官方介绍:inclusion-ai.org/
inclusionAI Ling-3.1-flash 模型卡:huggingface.co/inclusionAI/Ling-3.1-flash
官方权重配置:huggingface.co/inclusionAI/Ling-3.1-flash/blob/main/config.json
官方权重文件清单:huggingface.co/inclusionAI/Ling-3.1-flash/tree/main
蚂蚁灵开发者文档:developer.ant-ling.com/zh-CN/docs/models/ling/
SGLang 官方部署指南:docs.sglang.io/cookbook/autoregressive/InclusionAI/Ling-3.1-flash
SGLang 服务参数文档:docs.sglang.io/advanced_features/server_arguments.html
SGLang 专用镜像信息:hub.docker.com/r/lmsysorg/sglang/tags?name=dev-ling-3.1-flash
NVIDIA Container Toolkit 安装与配置:docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/install-guide.html
NVIDIA GPU 运行检查:docs.nvidia.com/datacenter/cloud-native/container-toolkit/latest/sample-workload.html
NVIDIA CUDA 驱动兼容表:docs.nvidia.com/deploy/cuda-compatibility/minor-version-compatibility.html
七牛云 AI 大模型企业订阅:www.qiniu.com/ai/plan