DeepSeek V4.1 Flash、MiniMax M3.1 Flash 与 Kimi K3.1 Pro:你的 Agent 该选谁?
发布日期:2026-10-26
截至2026年10月26日,DeepSeek V4.1 Flash、MiniMax M3.1 Flash与Kimi K3.1 Pro分别是DeepSeek、MiniMax和月之暗面已发布的通用模型,均支持视觉与工具调用。三者提供百万级上下文,但思考控制、计费和权重开放进度不同。10月24日发布的K3.1 Pro,标准版输入、输出价为每百万tokens 13元和68元,完整权重计划于11月4日前发布。本文依据官方资料比较接入与任务成本,提供可复用测试方法,帮助开发者判断是否迁移。
先对齐版本:这次比较的是Kimi K3.1 Pro
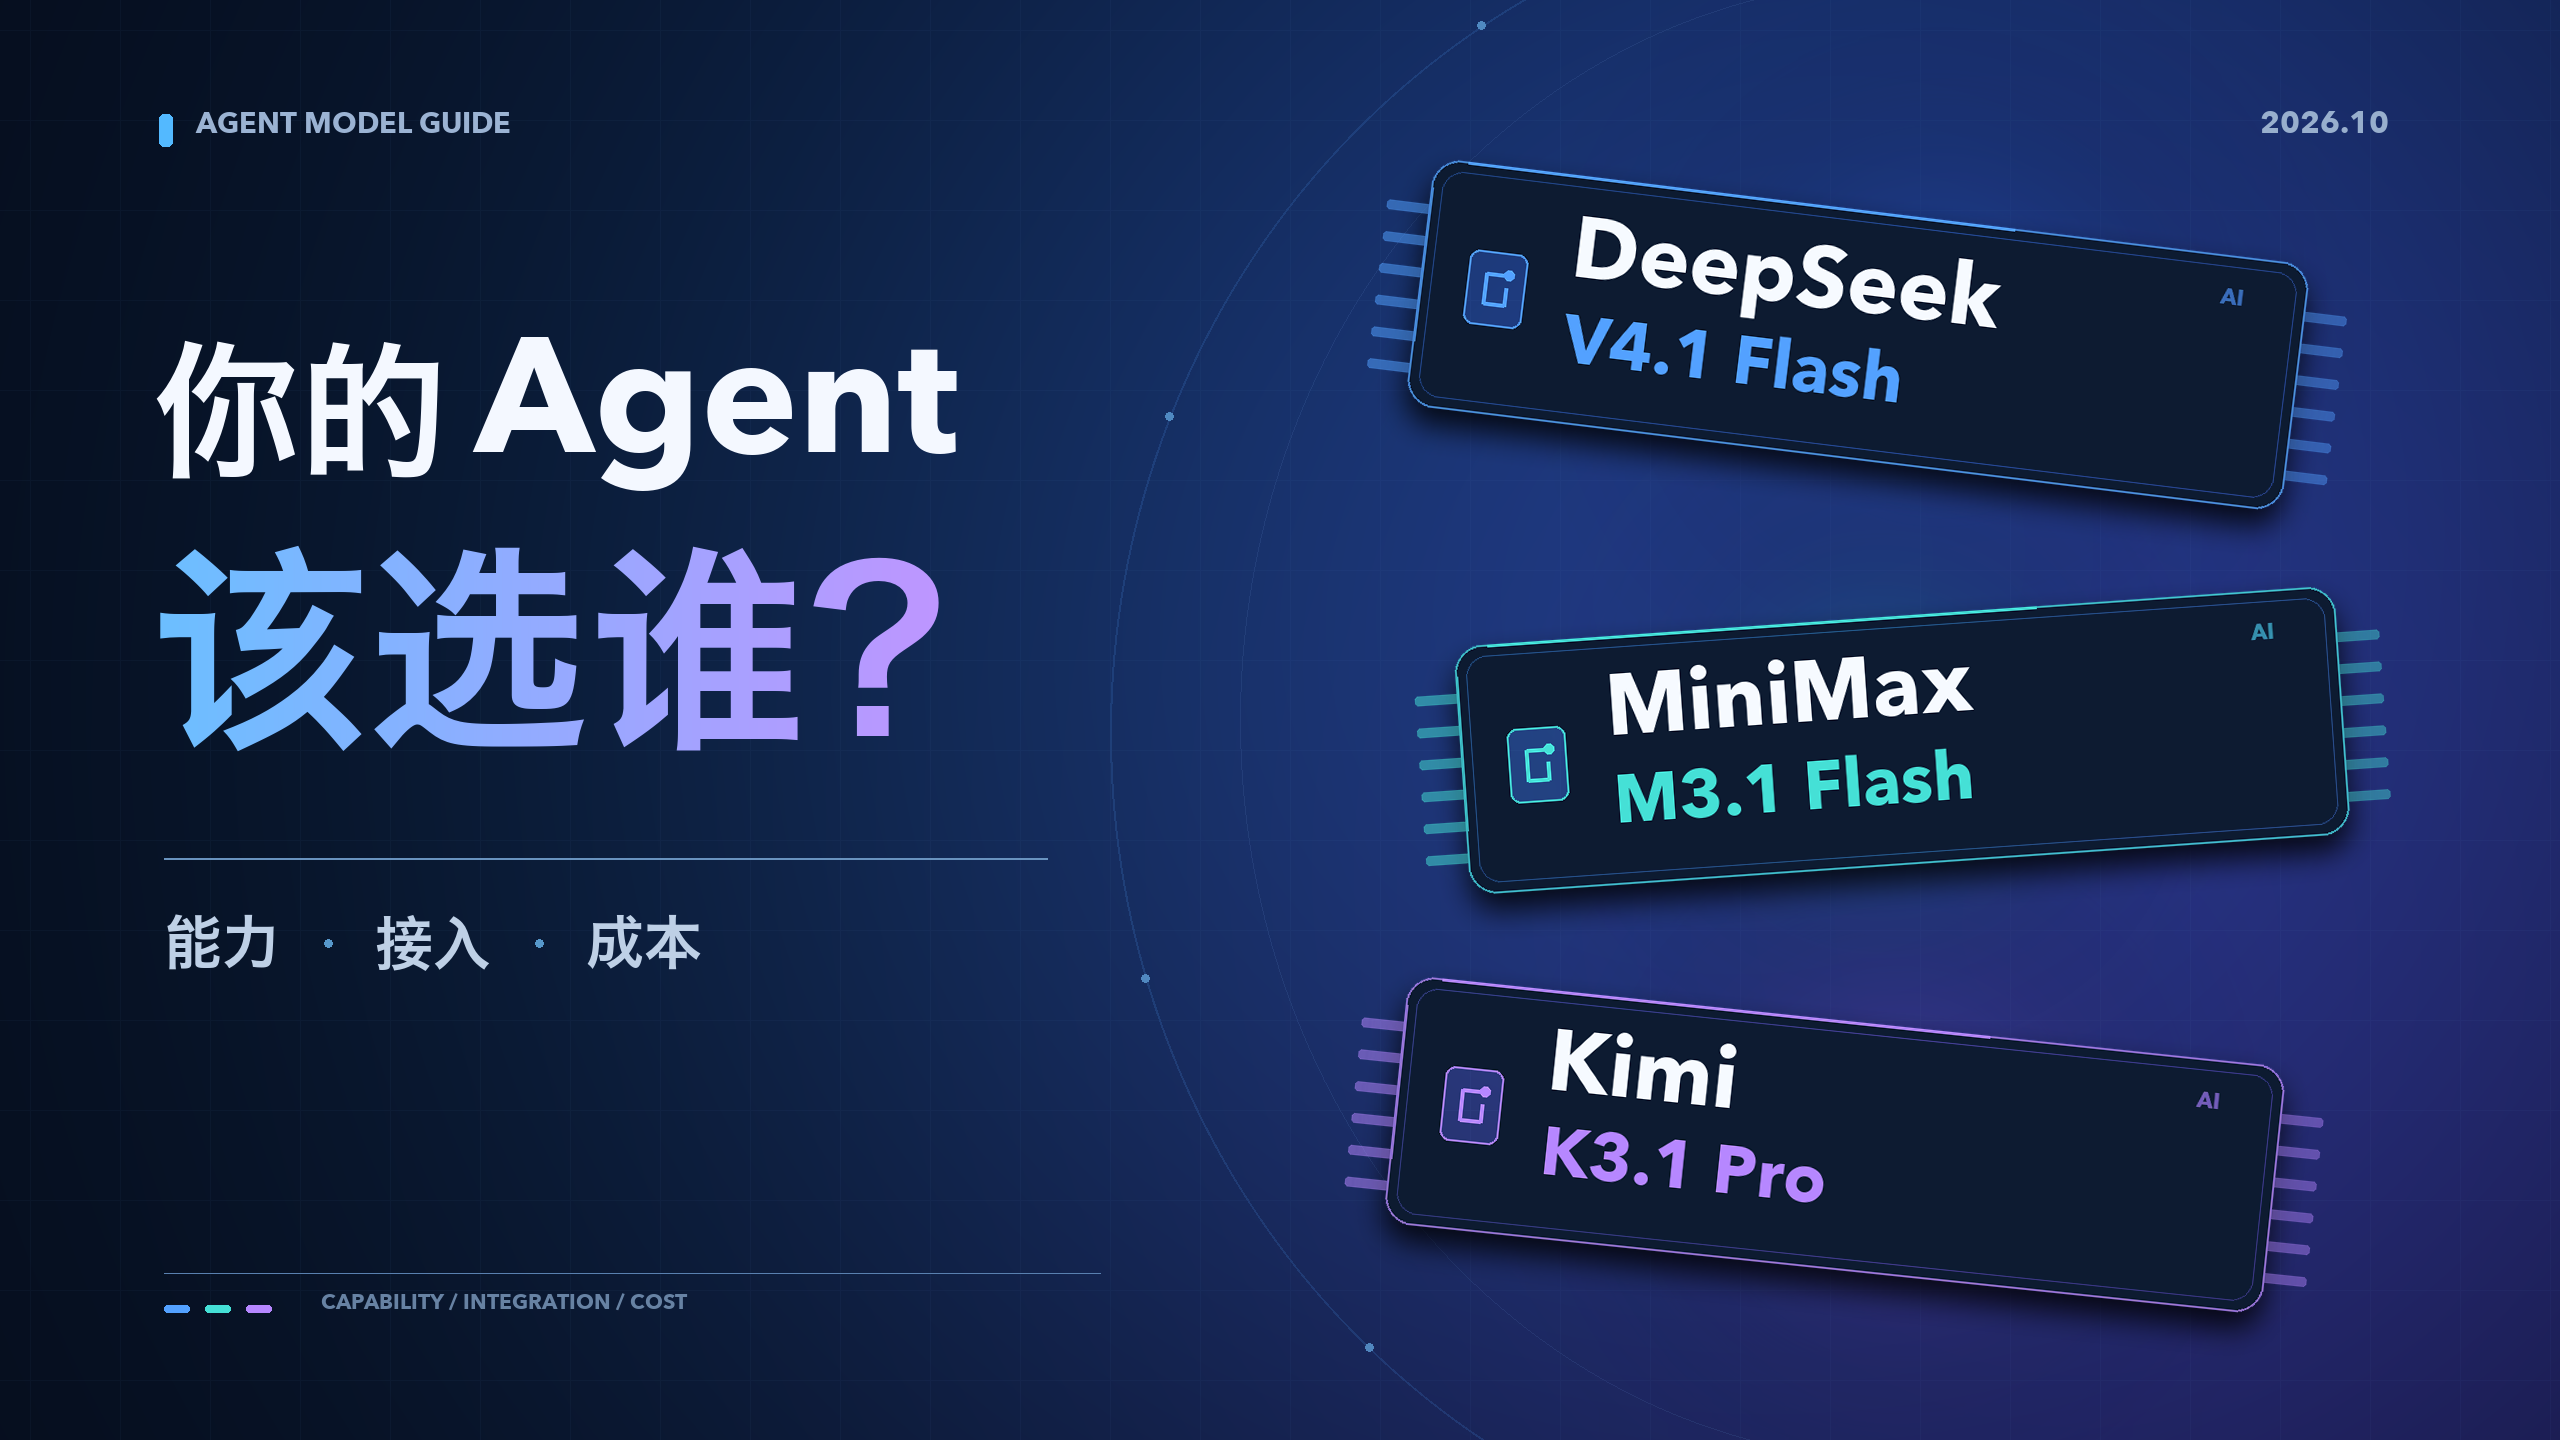
Kimi官方将10月24日发布的新模型命名为Kimi K3.1 Pro,称其为K3.1系列的首款模型。比较它时,应使用当前指南中的kimi-k3.1-pro,并区分标准版和高速版的计费。
另外两款也要记录具体版本。DeepSeek官方更新记录显示,V4.1 Flash于9月10日发布,10月17日更新至1017;MiniMax M3.1 Flash于10月19日发布。以下规格均按2026年10月26日的官方资料整理。
这些数字适合核对接口规格;业务选型还要检查长材料中的检索、约束遵循和多轮任务完成情况。把输入窗口装满,并不能替代任务验收。
能力差异,落在思考控制和工具链适配
三款模型都具备视觉理解与工具调用能力。DeepSeek当前文档列出图像与文本输入;MiniMax和Kimi K3.1 Pro还列出视频输入。需要处理截图、视频或图文资料时,应使用同一份素材验证输入方式和结果。
思考控制是一处明确差异。DeepSeek支持非思考模式,可以测试简单请求是否需要额外推理;MiniMax与Kimi K3.1 Pro的思考始终开启,通过档位调整投入。Kimi的reasoning_effort支持low、high、max,默认max。
工具调用也需要客户端配合。MiniMax和Kimi的指南要求保留完整assistant消息;Kimi明确包括reasoning_content和tool_calls。只保存最终回答,可能丢掉后续工具轮次需要的信息。
Kimi K3.1 Pro另有视觉输入限制:当前指南不接受公网图片URL,应使用base64或平台文件引用。已有应用接入前,可以先用一张业务截图检查请求格式,再扩展到长任务。
厂商展示的编码、办公或Computer Use成绩,可以用来发现测试方向。业务效果应在相同材料、工具权限与验收标准下判断;本文没有调用三款模型进行性能实测。
成本比较,要把币种、缓存和时段写清楚
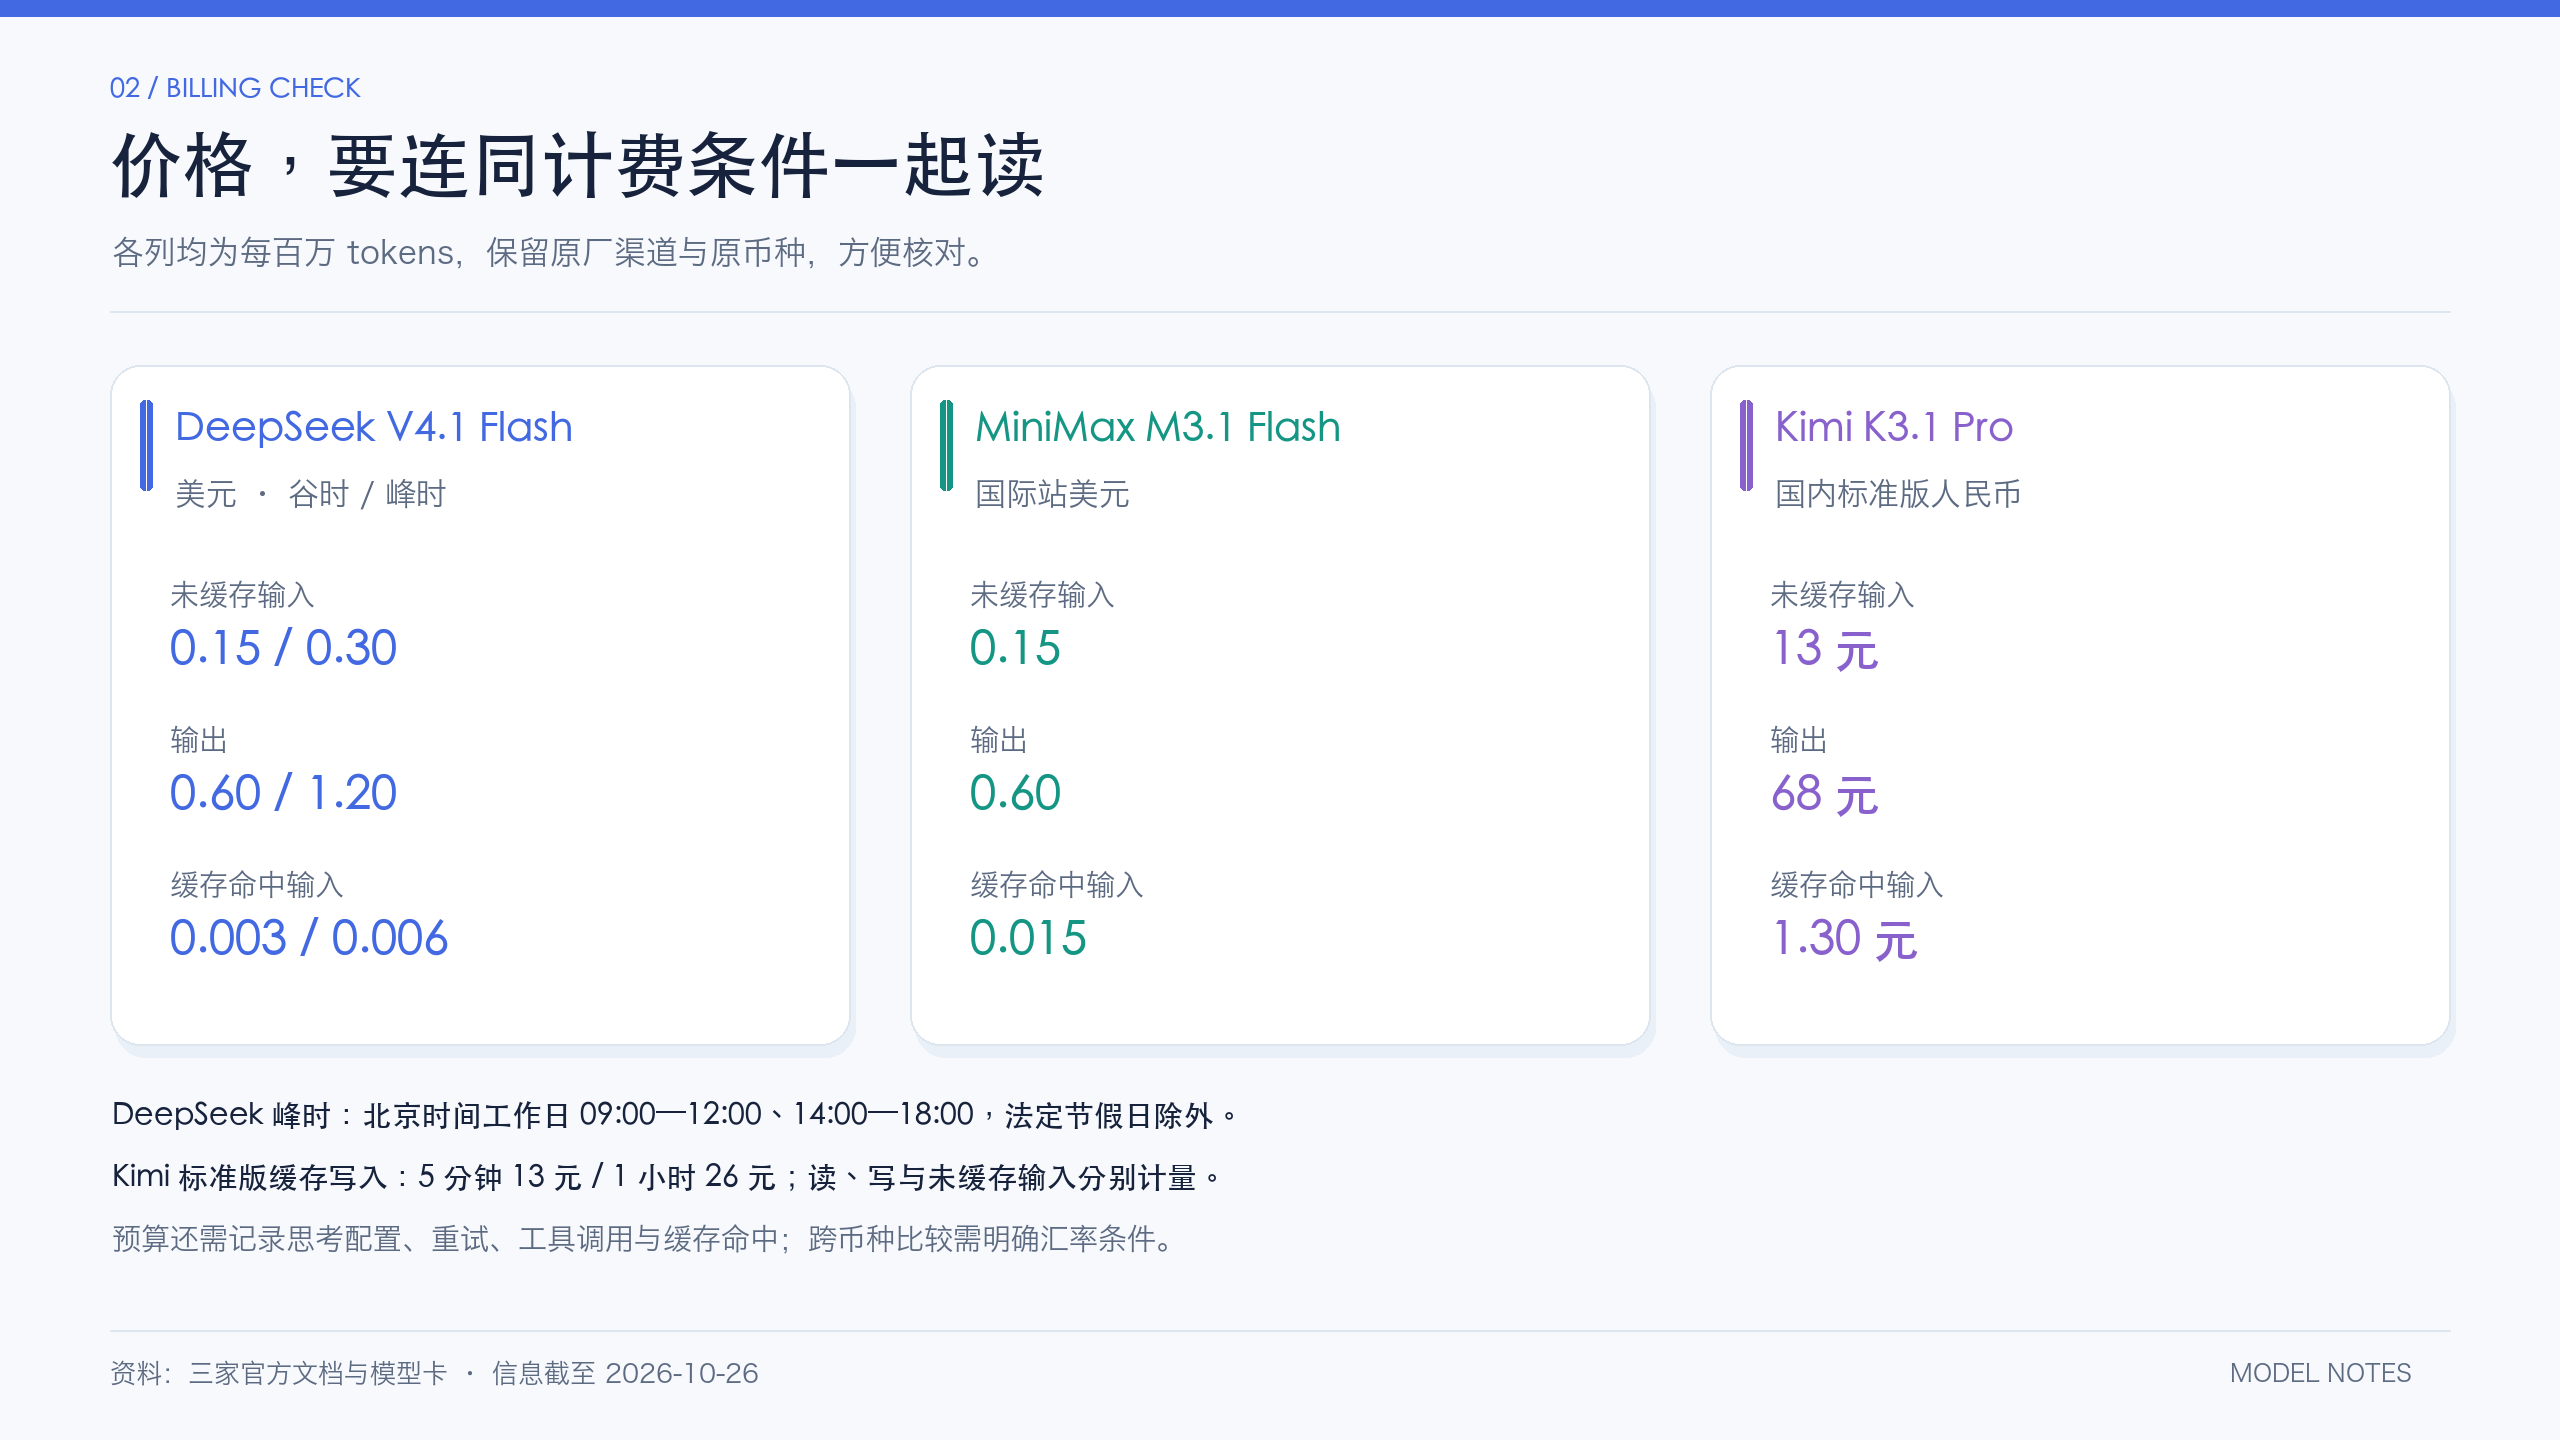
截至2026年10月26日,官方页面给出的模型价格如下,单位均为每百万tokens;Kimi一行使用K3.1 Pro标准版。
DeepSeek峰时换算为北京时间,是周一至周五09:00—12:00、14:00—18:00,中国法定节假日除外;其余时间按谷价计费。MiniMax国际站的常规输入、输出单价与表中的DeepSeek谷价相同,缓存读取价不同。
Kimi K3.1 Pro的缓存写入还分保留时间:5分钟为13元、1小时为26元,每百万tokens计价。缓存读取、写入与未缓存输入是互斥桶,同一批写入token不能再叠加普通输入费用。
以标准版作一个预算算例:若一次任务产生1万未缓存输入tokens和2000计费输出tokens,模型费用为0.13+0.136=0.266元。这里未计入额外搜索、抓取或其他服务费用,也不是本文的实测结果。
思考内容同样影响账单。Kimi官方说明,reasoning_content计入输入、输出消耗;完整历史回传后还会占用上下文。只按最终可见答案的长度估算,容易低估长程Agent任务的费用。
高速版需单独核算:Kimi当前定价页列出的未缓存输入为26元、输出136元、缓存命中1.30元,单位相同。比较之前先确认实际调用的型号,以及希望换取的等待时间收益。
本文保留各渠道原币种;统一预算时再明确汇率、税费、时段和缓存条件。工具定义、工具返回内容及额外搜索调用,也应纳入完整任务记录。
自部署选型,还要看权重与许可进度
三款模型当前的权重开放状态不同。DeepSeek V4.1 Flash 1017官方模型卡明确,仓库与权重使用MIT许可;MiniMax M3.1 Flash当前官方仓库已公开权重,采用MiniMax Community License。
Kimi K3.1 Pro的发布公告和指南则写明,完整权重计划于2026年11月4日前发布。以10月26日为判断时点,应按这一进度做部署规划,并在权重发布后核对该型号的具体许可证。
API接入预算与本地部署预算也要分别计算。后者需要计入硬件、运维、并行部署和授权条件。MiniMax的社区许可包含商业使用条款,准备对外提供服务时应阅读原文。
用一份真实工单,确定哪款值得继续测
可以先选一份已经知道正确处理结果的售后工单,把三款模型放在相同验收条件下。以下提示词可直接复用,将材料替换为自己的业务样本:
任务:根据以下售后工单,生成客服可执行的处理方案。
约束:仅依据材料;缺失信息写“材料未提供”;引用证据编号。
输出:JSON对象,包含问题分类、证据编号、待确认事项、处理步骤。
材料:
[E1] 在这里粘贴工单原文。
[E2] 在这里粘贴适用的售后政策。
先检查条款引用、事实完整性和JSON格式,再记录完成时间及账单费用。需要查询订单时,继续检查工具参数、结果处理以及失败后的恢复过程。
分别保留冷启动结果和重复前缀结果,可以观察缓存影响。每次记录实际模型ID和思考档位;不同厂商的“high”不能直接视为相同的计算投入。
最后统计每个通过验收任务的成本,把失败、重试和人工修正纳入记录。已有DeepSeek应用,可先测试思考开关与峰谷预算;接入MiniMax,应检查工具消息和计费渠道;接入Kimi K3.1 Pro,应核对标准/高速版、思考历史和缓存设置。
据三家当前官方文档,这轮选择的关键是接入约束、任务完成情况与计费条件。先固定版本,再用自己的材料决定是否迁移。本文信息截至2026年10月26日。