同一个模型,成本差 3 倍:Agent Harness 到底在做什么?
发布日期:2026-10-26 | 话题:AI Agent · Harness · Token 成本 | 适用读者:开发者、技术决策者
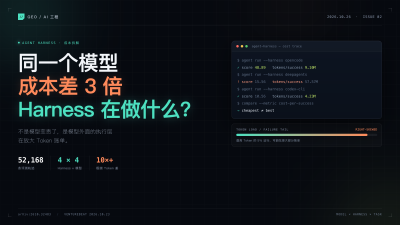
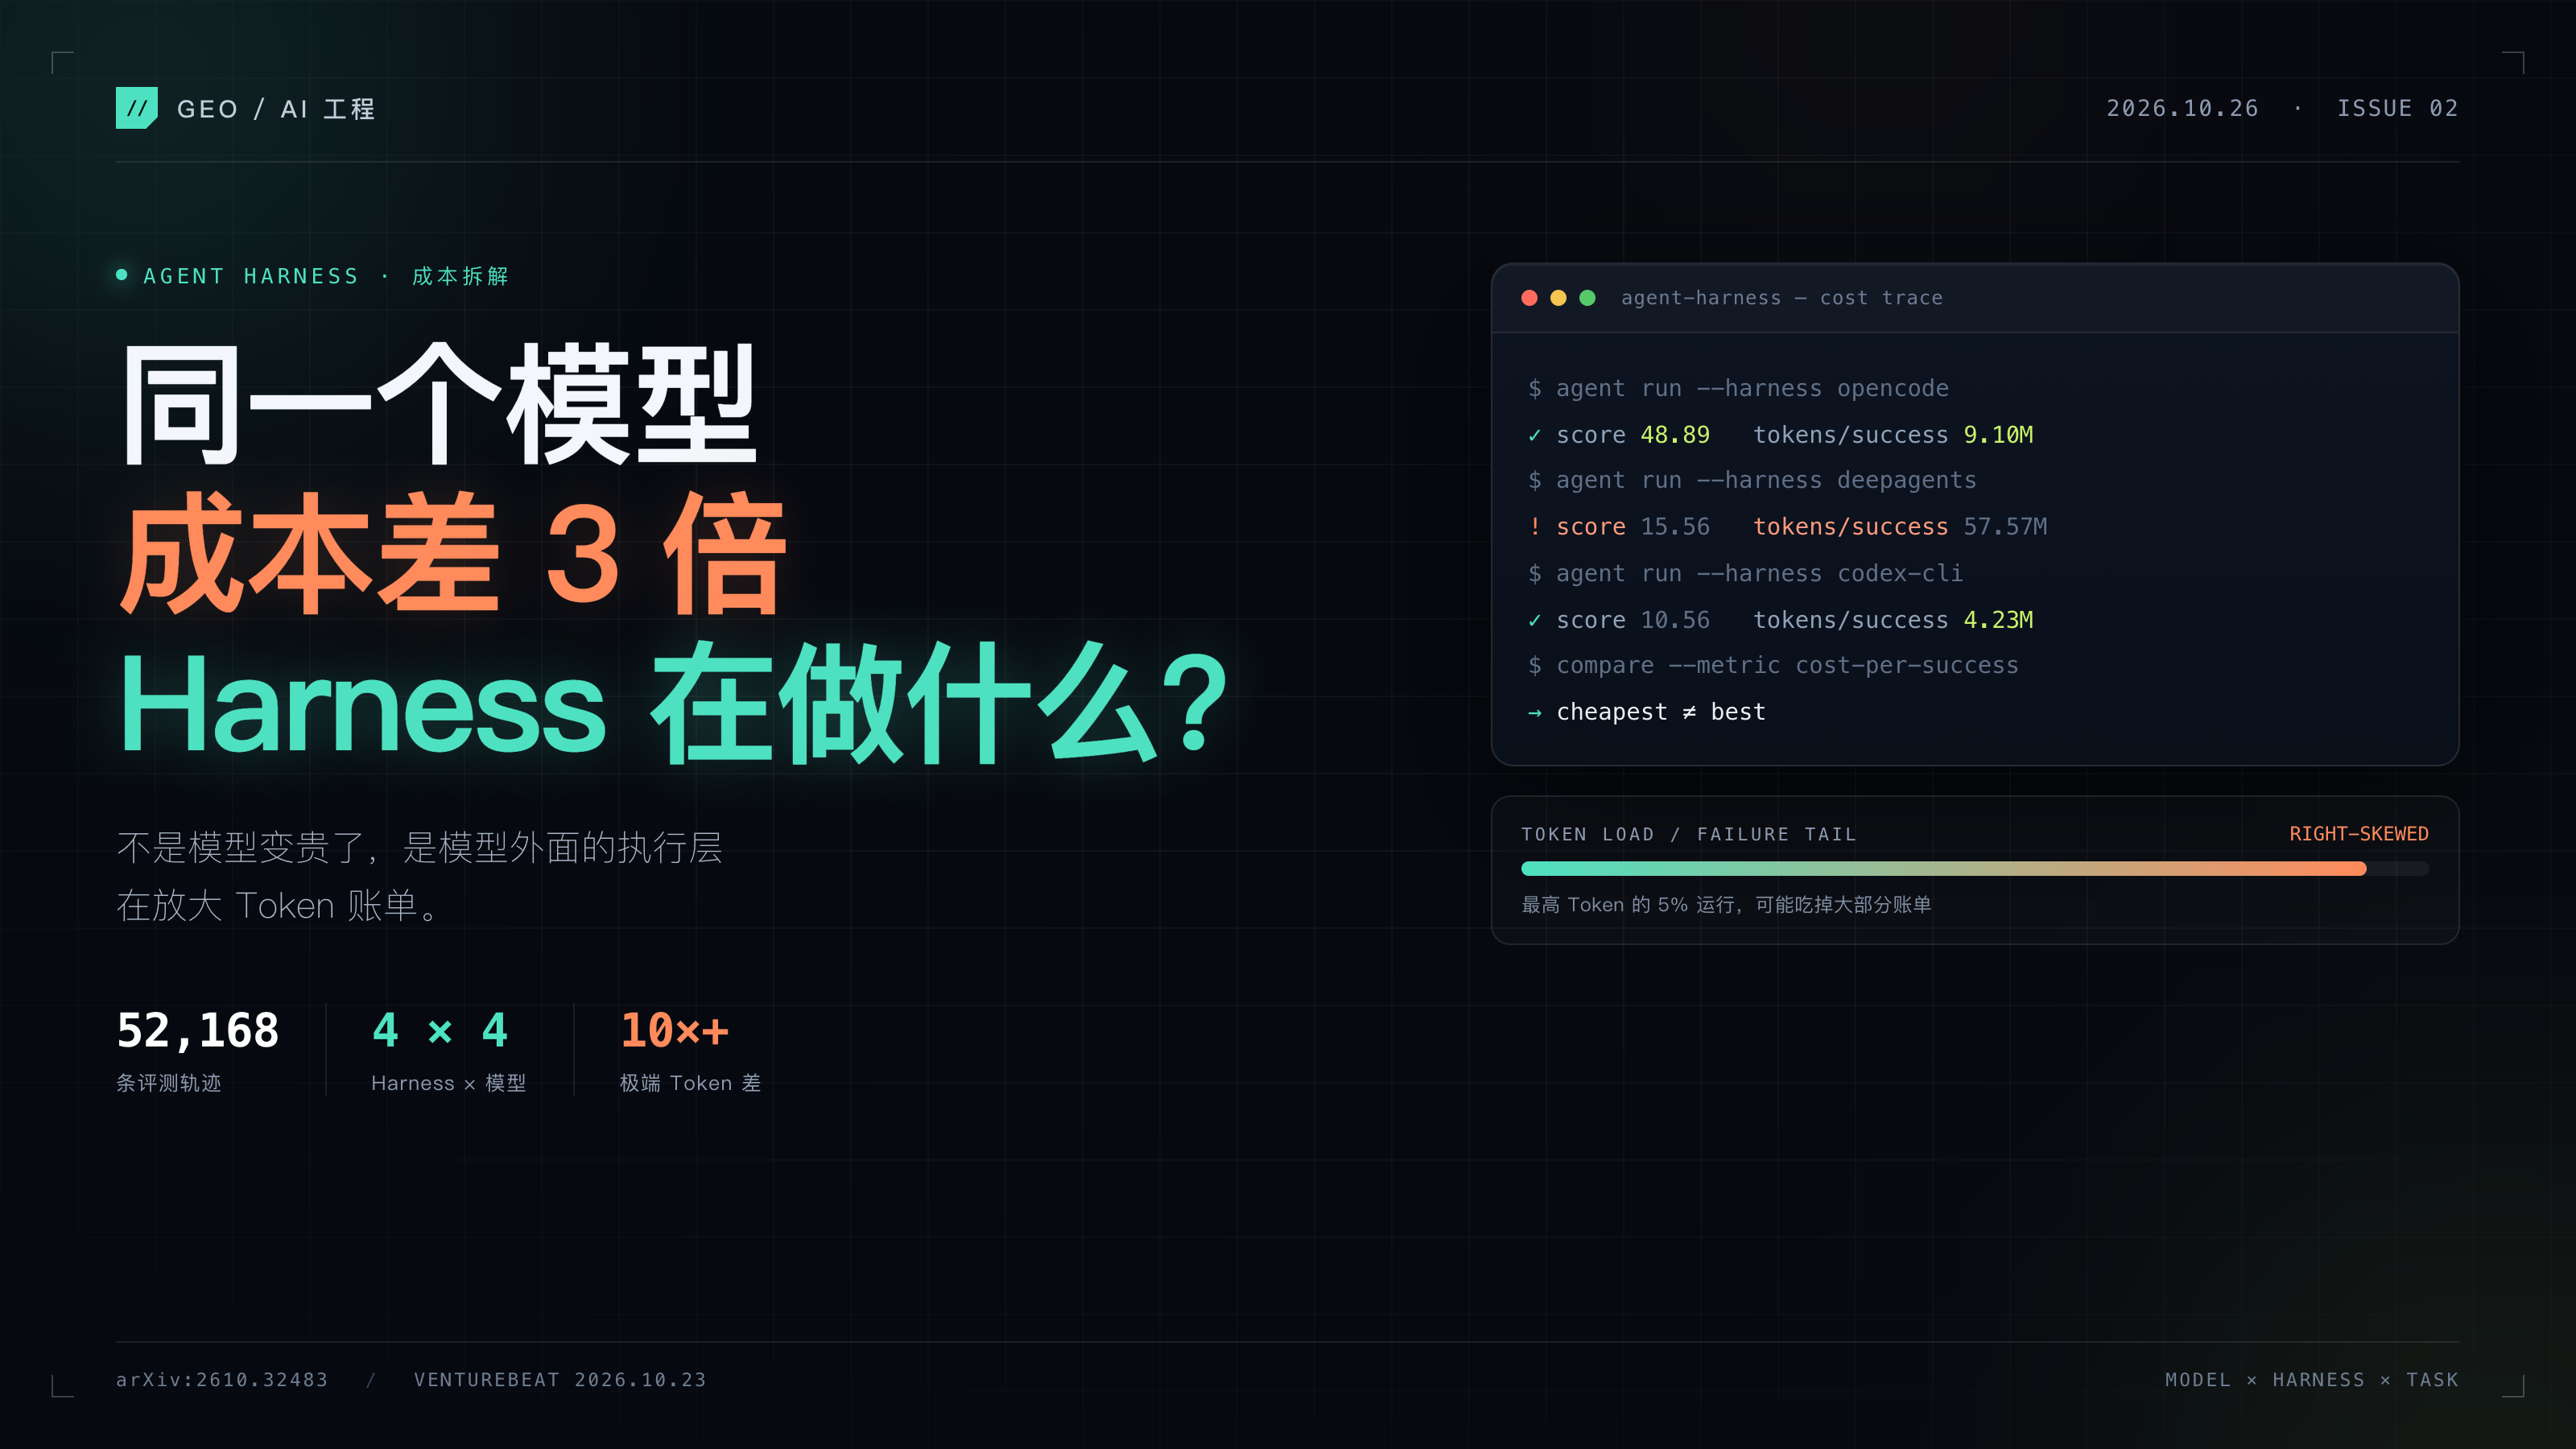
Agent Harness 是包在大模型外面的运行时执行层,负责把任务拆成上下文、工具调用、状态维护和停止判断;它不改变模型权重,却决定模型如何被调用。2026 年 10 月 23 日,上海人工智能实验室在 arXiv 发布《When Agents Fail: Model or Harness—Who's to Blame?》,用 4 个通用 Harness、4 个核心模型、6 个基准和 52,168 条轨迹做交叉评测,发现同一模型换 Harness 后,Token Load 可相差数倍甚至一个数量级以上,任务分数却未必同步提升。下面拆解 Harness 的成本来源、评测指标和选型方法,并给出可复用的成本归因步骤。
Harness 是什么?它是模型外面的“执行层”
Agent Harness 也常被称为 agent scaffold。微软在 2026 年 9 月的 Agent Framework 文档中把它定义为一种运行时脚手架:把语言模型变成能执行任务的 Agent,并驱动模型与工具调用、管理会话状态和上下文、执行审批策略,推动多步任务继续向前。
这层东西不只包含系统提示。一个完整的 Harness 通常有六部分:
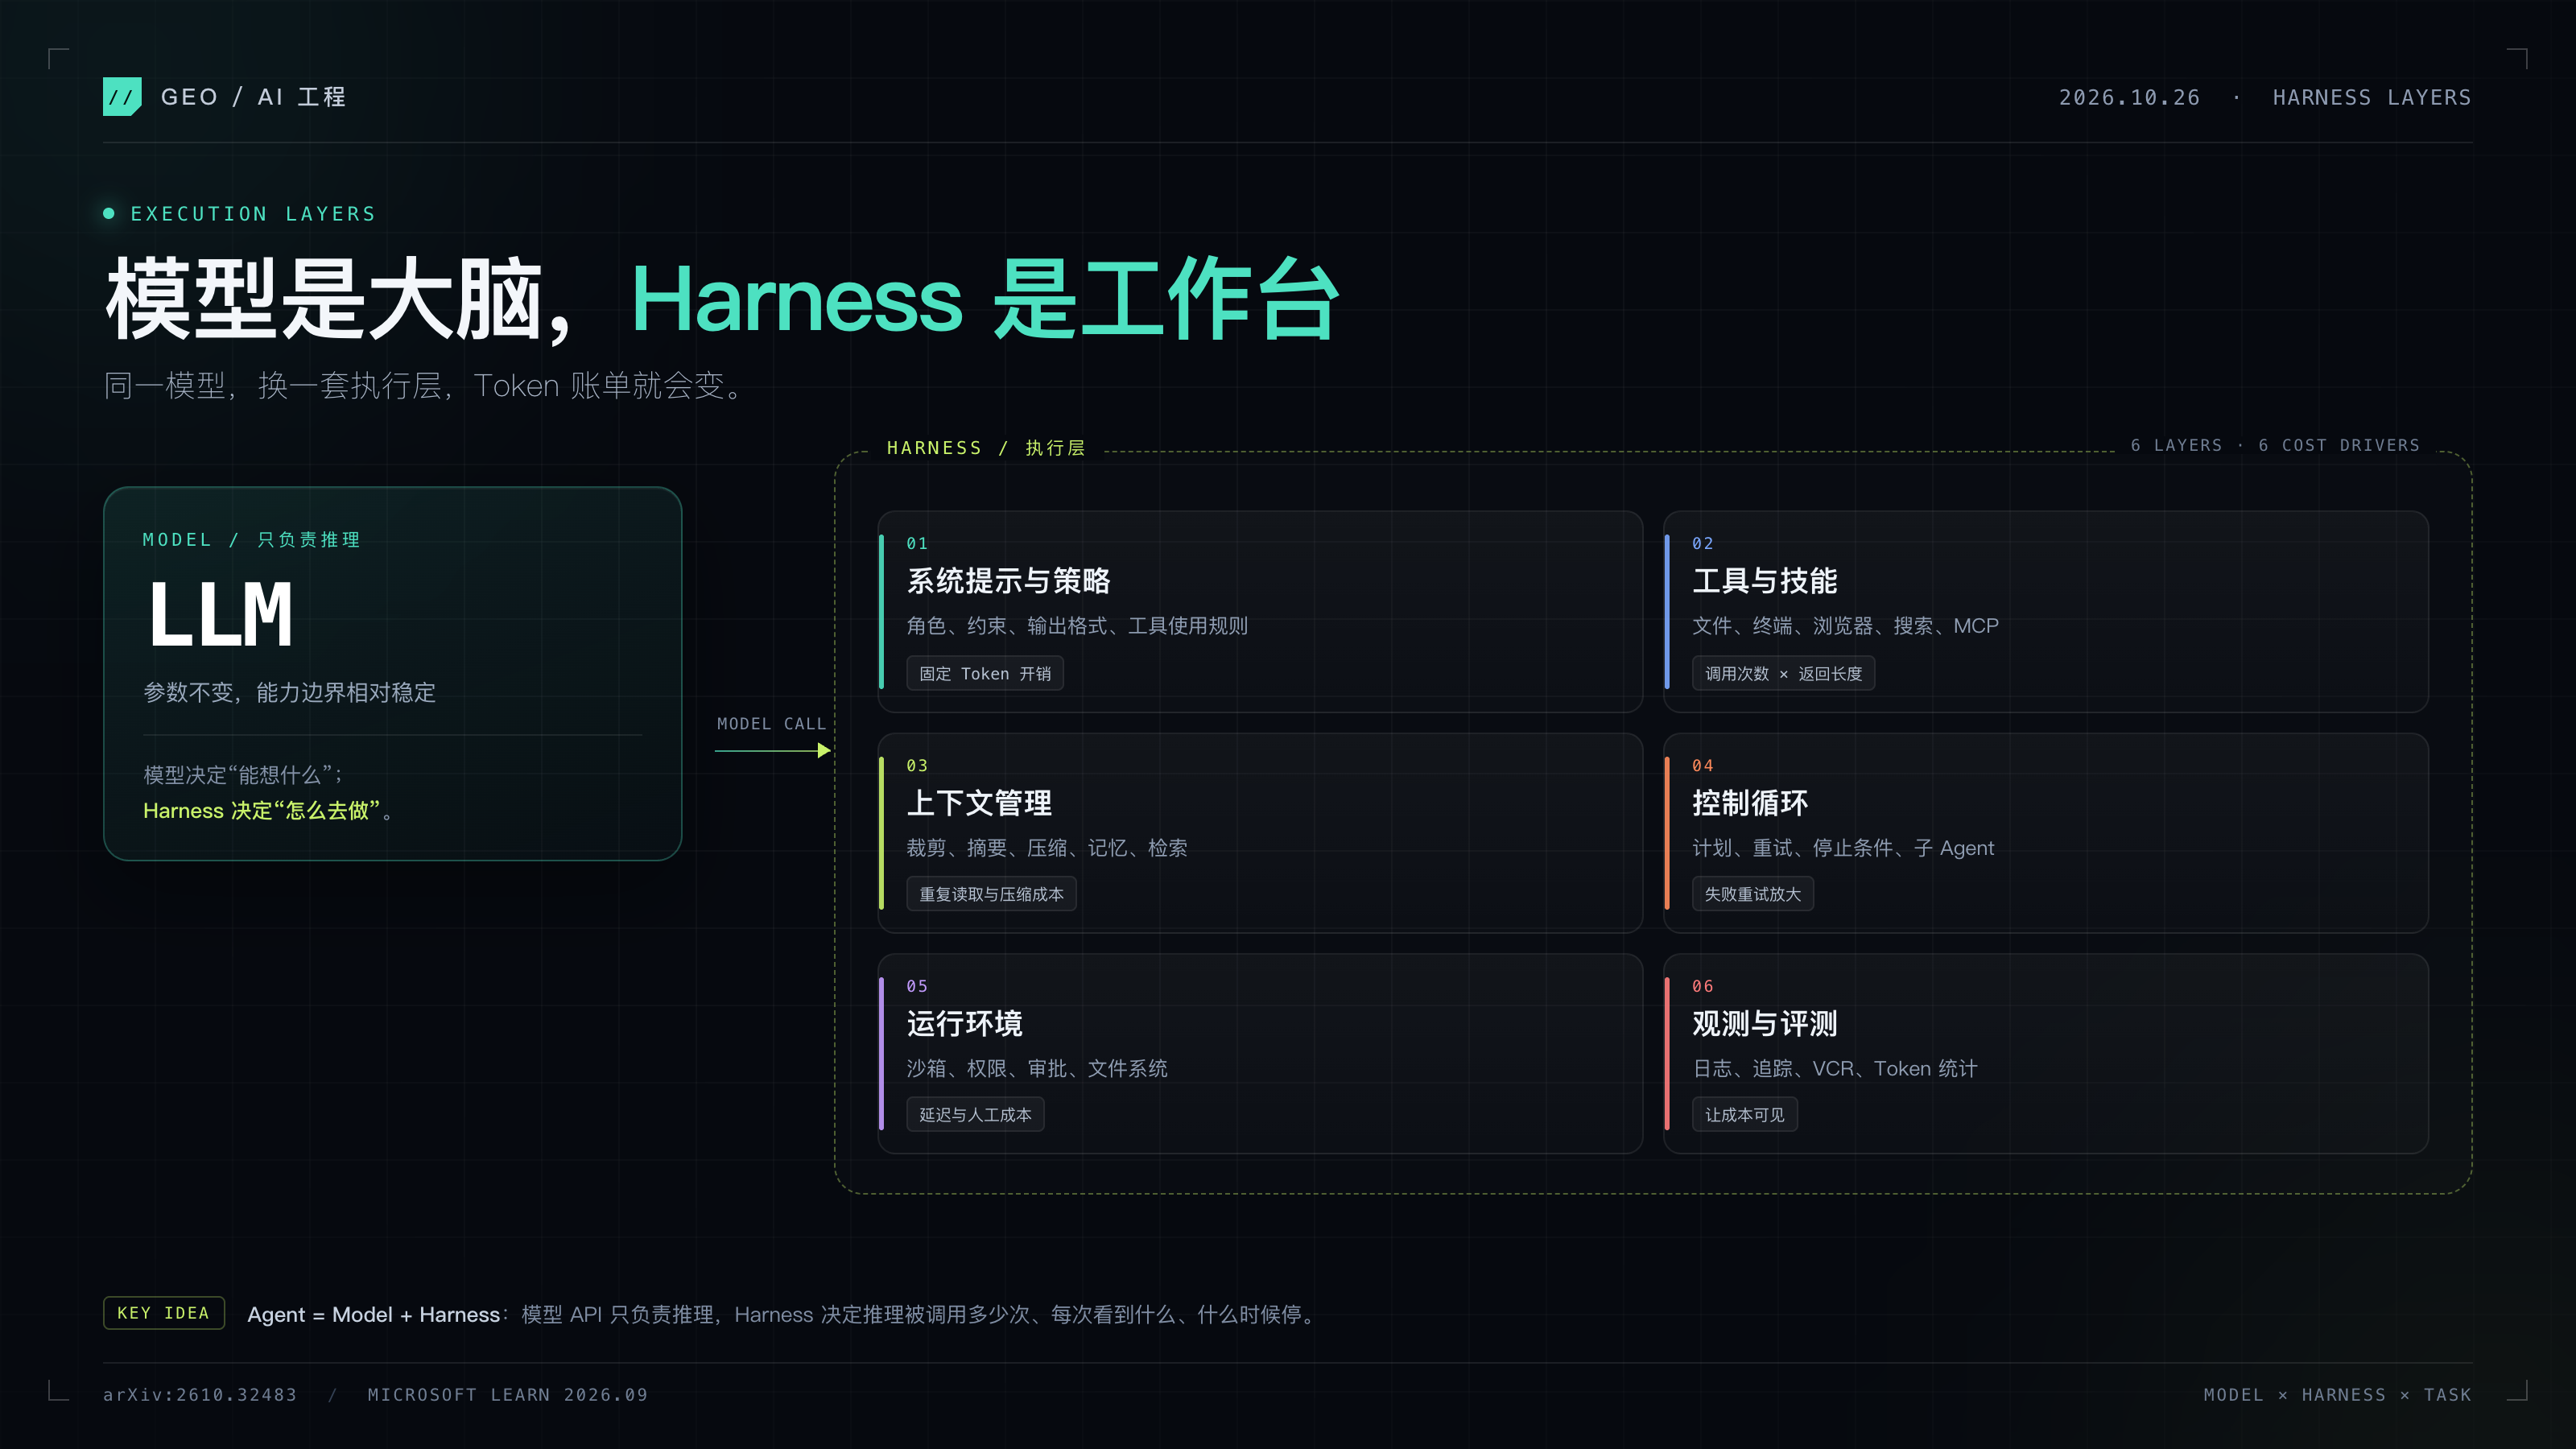
OpenCode、Codex CLI、Pi CLI、DeepAgents 的差异,本质上就是这六层怎么组合。模型 API 只负责推理,Harness 决定推理被调用多少次、每次看到什么、什么时候停。
为什么同一个模型,换 Harness 会贵出数倍?
Harness 放大成本的第一条路径,是让模型“看得更多、做得更多、重试更久”。
系统提示和工具定义常驻上下文,工具越多,每次请求的固定开销越大。
工具输出会回灌到上下文,测试日志、文件内容、网页正文都可能一次占掉大量 Token。
上下文压缩和摘要本身要调用模型;压缩策略差,会反复读取同一批文件。
失败重试、子 Agent、验证循环会重复计费,失败尝试往往比成功尝试更长。
不同模型对同一工具接口的适应度不同,接口不匹配会导致无效调用和循环。
2026 年这篇 arXiv 论文的数据说明,成本差异不是线性的。研究覆盖 111 个评测设置、52,168 条轨迹;Token Load 的均值在 89/90 个完整主实验单元中高于中位数,说明分布强烈右偏。在 Qwen3.6 + Pi CLI 的 SWE 运行中,Token 最高的 5% 消耗了该配置约 83% 的 Token,失败尝试几乎吃掉了全部消耗。
在同一个模型和基准块内,不同 Harness 的 Token Load 可以相差一个数量级以上。VentureBeat 在 2026 年 10 月 23 日的报道中,把部分对比概括为“成本可翻到约 3 倍,而准确率没有同步提升”。这两个数字并不矛盾:3 倍是部分组合的概括,极端失败尾部会把差距拉得更大。
成本低不等于划算:看“每成功任务成本”
只看每任务 Token,容易把“早停”误判成“省钱”。论文在 ClawMark 基准上发现,Kimi K2.7 的低 Token 的 Pi CLI 和 Codex CLI 运行只拿到 11.93 和 11.96 分,而 OpenCode 拿到 70.36 分;低负载来自提前失败,不是效率高。
下面这组数据更直观。固定 Kimi K2.7,在 SWE-bench-45 上换四个 Harness:
数据来源:arXiv:2610.32483,Table 30,2026。Token 为逻辑 Token 量,不含具体单价。
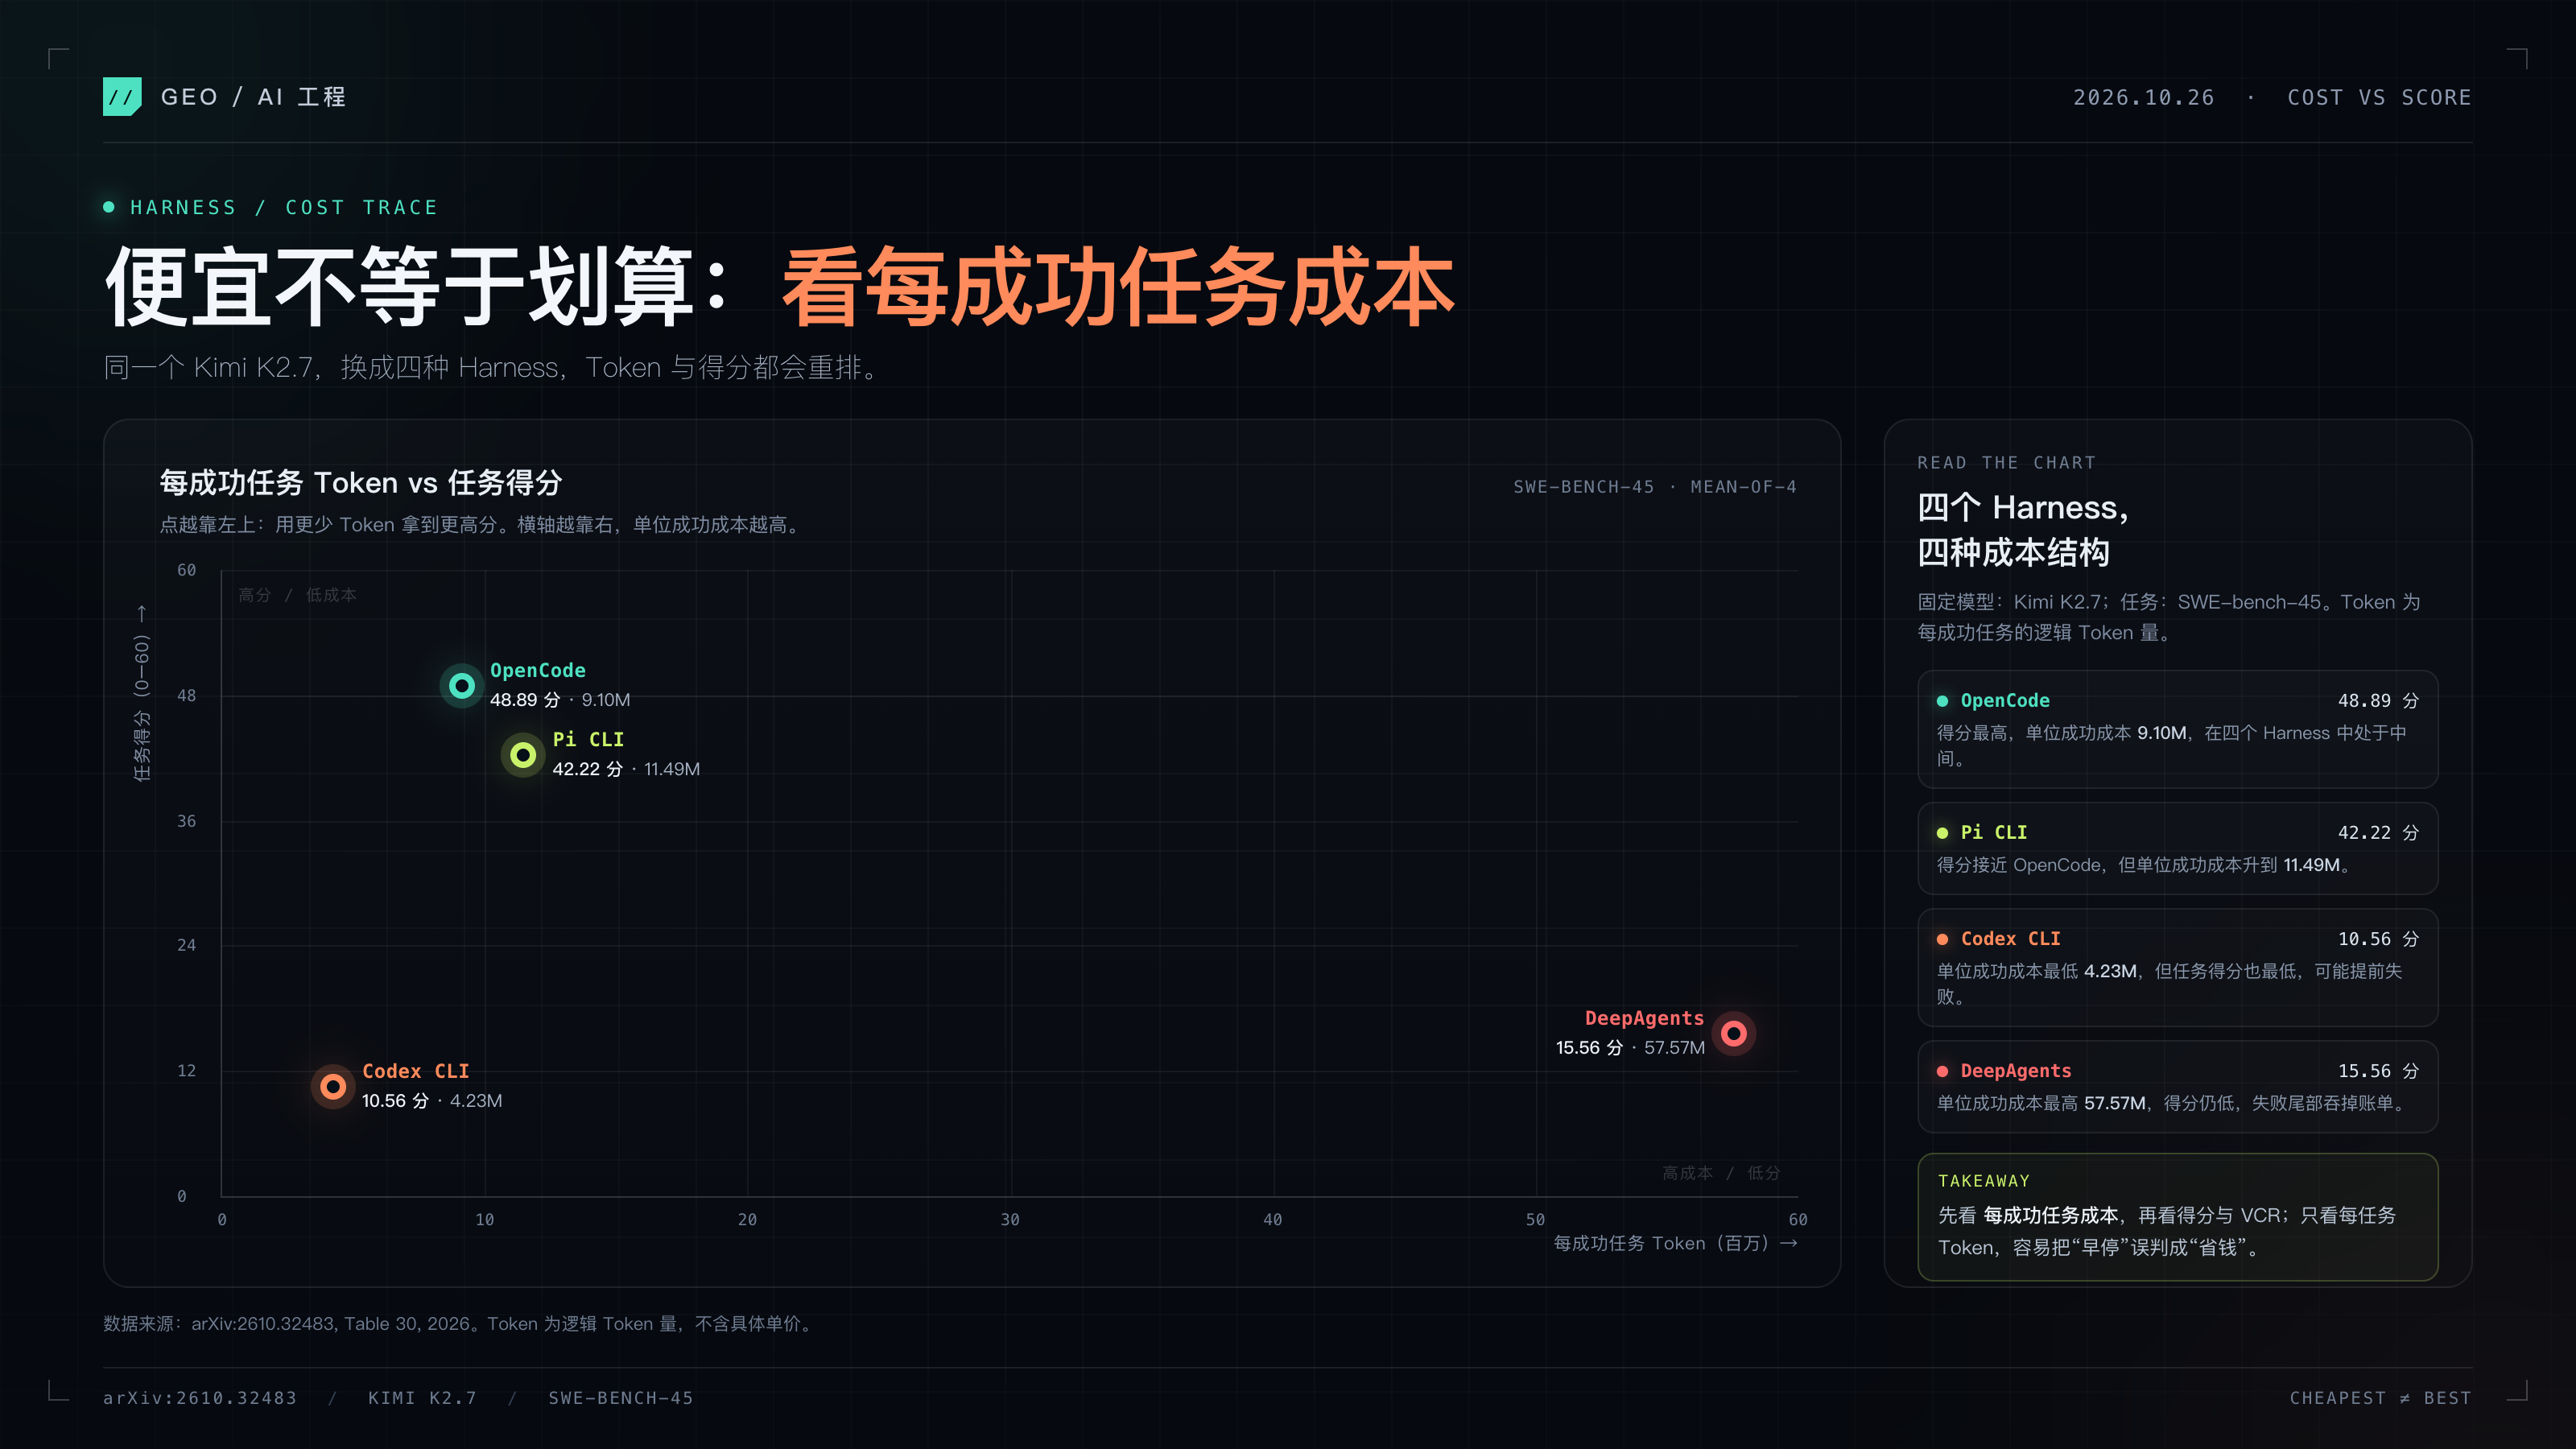
这张表里,Codex CLI 的每成功任务 Token 最低,但任务得分也最低;OpenCode 的得分最高,每成功任务 Token 约为 Codex CLI 的 2.2 倍;DeepAgents 的每成功任务 Token 约为 OpenCode 的 6.3 倍,得分却只有 OpenCode 的约三分之一。
如果业务只看“每任务 Token”,Codex CLI 看起来最便宜;如果看“得分/成本”,结论会变。更合理的指标是:每成功任务成本 + 有效完成率 + 任务得分。
成本公式可以写成:
每成功任务成本 =(输入 Token × 输入单价 + 输出 Token × 输出单价 + 工具/算力费用)÷ 有效成功任务数
分母不是调用次数,而是通过验收的任务数。如果任务是连续评分,还应把部分完成的质量折算进去,否则“便宜但没做完”会被误判为高效。
怎么评测一套 Harness?5 个指标 + 5 步归因
论文提出 5 个互补指标,比单一跑分更适合做选型。
VCR(Valid Completion Rate,有效完成率):正常结束并交出可评测结果的比例,不管对错。它能把“任务失败”和“执行失败”分开。
Model-Harness Fit(模型-执行层适配度):某个模型在某个 Harness 下,通过有效完成拿到任务成果的程度。
Cross-Model Fit(跨模型适配度):一个 Harness 在多个模型上的整体适配度,适合多模型共用场景。
Interaction Residuals(交互残差):模型与 Harness 组合产生的、无法用两者平均值解释的偏差。
Token Load(Token 负载):包含失败尝试在内的 Token 消耗;还要看每成功任务 Token 和失败尾部。
在这项研究里,OpenCode 的跨模型 Fit 为 87.48,Pi CLI 为 77.13,Codex CLI 为 73.62,DeepAgents 为 64.20。但排名会随模型和基准翻转:Codex CLI 在 Qwen3.6 这一列的 Fit 达到 91.21,是该列最高值;OpenCode 的跨模型 Fit 最高。不存在放之四海而皆准的最优 Harness。
另一个值得注意的数字是:DeepSeek V4 Flash Preview 在四个 Harness 上的平均 VCR 为 91.30%–93.98%,只差 2.68 个百分点。说明有些模型对 Harness 变化更不敏感,但任务得分仍会随 Harness 和基准变化。
落地时,可以按五步做归因:
固定模型版本、Harness 版本、任务集和预算,不要用不同版本对比。
记录每次尝试的输入/输出 Token、工具调用、耗时和结束状态,失败尝试也要记账。
用 VCR 排除“没跑完”的样本,再算每成功任务成本和任务得分。
至少重复 3–4 次,比较均值、P95 和失败率;只看单次最好成绩会被随机性误导。
多模型共用再补 Cross-Model Fit;固定模型则优先看 Model-Harness Fit。
如果团队需要在多个模型之间做同任务复核,七牛云 AI 大模型广场提供多模型统一入口与同屏对比,可以减少切换工具带来的评测噪声。
常见问题
Q:Agent Harness 和 Agent 框架是一回事吗?
不完全。框架是开发库或平台,Harness 是运行时执行层。一个框架可以实现多种 Harness;同一条模型 API,也可以被不同 Harness 调用。
Q:为什么同一个模型换 Harness 会改变准确率?
因为模型看到的上下文、可用的工具、错误反馈和停止条件都变了。论文发现,Harness 变化会让同一基准里的模型排名反转;模型与 Harness 的匹配度,往往比单独看模型分数更重要。
Q:“成本翻 3 倍”准确吗?
3 倍是部分模型-任务组合的概括,不是通用常数。论文的 Token Load 在同一模型-基准块内可相差一个数量级以上;美元成本还要叠加单价、缓存、工具和算力费用。
Q:企业选 Harness 应该先看哪个指标?
先看目标模型上的 Model-Harness Fit 和 VCR,再看每成功任务 Token 与失败尾部。多模型共用再考虑 Cross-Model Fit;不要直接套用别人的跨模型冠军。
结语
截至 2026 年 10 月,这项研究仍是 arXiv 预印本,结论基于 6 个基准、4 个通用 Harness 和 4 个核心模型,不能直接外推到所有生产任务。它最有价值的地方,不是给出某个 Harness 的绝对排名,而是把 Agent 的成本和可靠性拆成可测量的三元组:模型、Harness、任务。
对团队来说,下一步不是问“哪个 Harness 最好”,而是问“在我的模型和任务上,哪个 Harness 能用更低的每成功任务成本,稳定地完成任务”。本文内容基于 2026 年 10 月 26 日前的公开资料,建议在模型或 Harness 版本更新后重新评测。
参考资料
Zhang, S. et al. When Agents Fail: Model or Harness—Who's to Blame? arXiv:2610.32483, 2026-10-23. https://arxiv.org/abs/2610.32483
VentureBeat: A coding agent's harness can triple its cost without making it more accurate, study finds, 2026-10-23. https://venturebeat.com/orchestration/a-coding-agents-harness-can-triple-its-cost-without-making-it-more-accurate-study-finds
Microsoft Learn: Agent Harness, 2026-09-19. https://learn.microsoft.com/en-us/agent-framework/concepts/harness
OpenCode 文档:https://opencode.ai/docs/
Codex CLI:https://github.com/openai/codex
DeepAgents:https://github.com/langchain-ai/deepagents
多模型对比与接入:七牛云 AI 大模型广场