Codex 上下文爆满怎么办:除了 /compact,还有这 6 种方法
发布日期:2026-10-26 | 数据截至 2026-10-26,来源为 OpenAI Codex 官方 GitHub 仓库(openai/codex,v0.164.0)
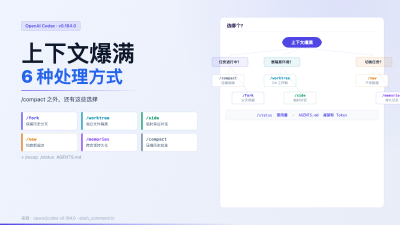
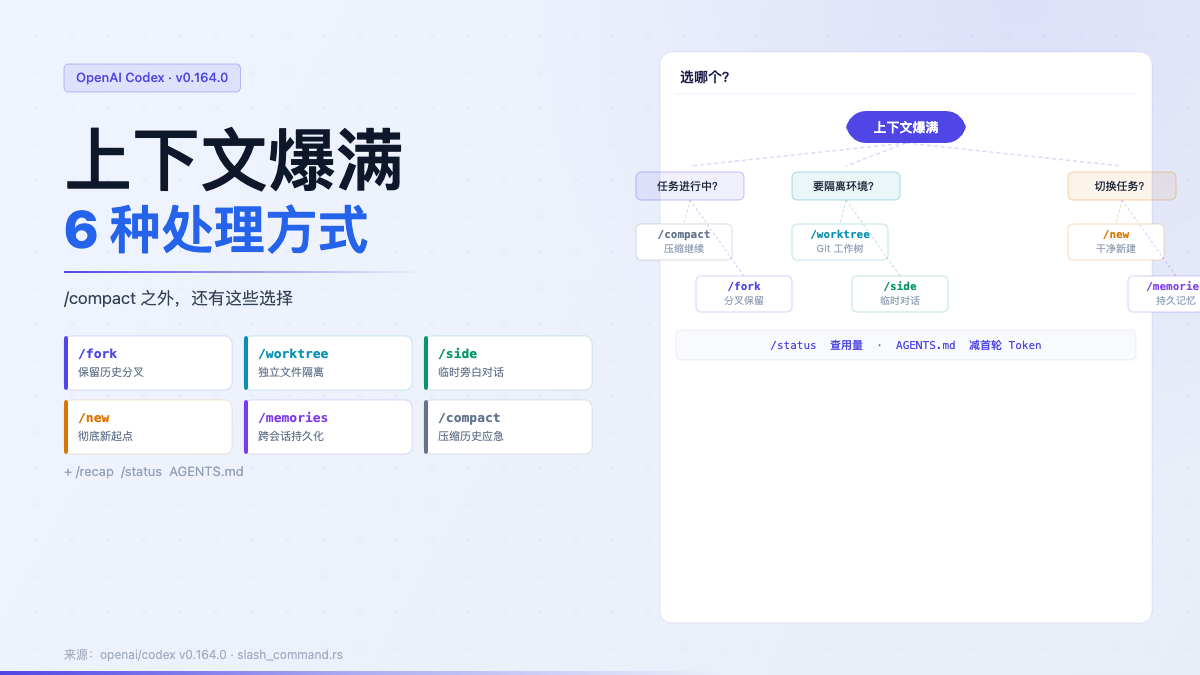
Codex CLI 上下文窗口爆满时,/compact 是最常见的应急手段,但它本质上是一次破坏性压缩——把整段对话历史折叠成一条摘要,之后无法再回溯细节。实际上,Codex v0.164.0(2026-10-23 发布)的斜杠命令列表里还有另外六种方式可以应对上下文压力,包括 /fork 开分支保留原始历史、/worktree 在独立 Git 工作树里新开会话、/side 临时开一个"旁白"对话、/new 干净起点、/memories 让关键信息跨会话持久化,以及 AGENTS.md 在系统提示层面减少首轮 Token 消耗。不同场景对历史保留的需求不同:压缩还是分叉还是新建,一张选择路线图就能决定,本文把六种方法的使用时机、命令格式和注意事项一并说清楚。
先弄清楚上下文爆满的本质
Codex 每次发请求都会把当前会话的完整历史(system prompt + 所有消息 + 工具调用记录)打包发给模型。历史越长,Token 越多,最终触及模型的上下文窗口上限,请求被截断或拒绝。
两个值得注意的现象:
/compact是压缩,不是清空。它把历史替换成一条摘要,之后新消息接在摘要后面继续跑。压缩后你仍在同一个 session 里,但丢失了细节。Codex v0.164.0 起,**背景自动压缩(background compaction)**已接入 turn 生命周期,到临界点时有概率自动触发。如果你不想被打断,可以在关键任务前主动处理。
方法 1:/compact——主动压缩,保留会话 ID
/compact/compact 的官方描述是"summarize conversation to prevent hitting the context limit"(摘要对话以防触碰上下文上限)。执行后:
当前会话 ID 不变,可以继续用
/resume找回历史被压缩成一条摘要,后续消息接在摘要后面
v0.164.0 修复了"压缩失败后留下残缺摘要"的 bug,现在失败会回退到压缩前的状态
适合:任务还在进行中,只是历史太长,不需要回溯细节的场景。
注意:使用
/compact后,模型对早期对话的记忆变成摘要,如果后续任务依赖早期的具体文件路径或代码片段,可能出错。
方法 2:/fork——分叉保留完整历史
/fork/fork 描述:fork the current chat(分叉当前对话)。
执行后:
当前 session 的完整历史被克隆到一条新 session
原 session 保持不变,可以随时用
/resume切回新 session 里可以继续任务,历史记录完整
v0.161.0 在 TUI 的 command center 里加了 Fork 快捷键,v0.164.0 改为"默认保留父 session 的完整历史"(Preserve parent history by default in full agent forks)。
适合:想在不破坏原始对话的前提下,从当前状态出发试验一个新方向。比如已经做了大量调试,想在现有基础上换一种方案,不希望原来的历史消失。
方法 3:/worktree——新 Git 工作树,彻底隔离
/worktree/worktree 描述:start or continue a conversation in a new worktree(在新工作树里开始或继续对话)。
执行后:
Codex 会在仓库里创建一个新的 Git 工作树(git worktree),文件系统完全独立
会话在新工作树里开始,当前工作树不受影响
特别适合同时跑多个分支任务
适合:需要在独立分支上做实验,完全不想和主工作树产生冲突。典型场景:主线在修 Bug,同时想在新工作树里重构一个模块,互不干扰。
方法 4:/side(/btw)——临时旁白对话,不占主线 Token
/side/side 和 /btw 等价,描述:start a side conversation in an ephemeral fork(在临时分叉里开一个旁白对话)。
执行后:
开一个短暂的"旁路会话",完全独立于主线 session
适合临时问一个不相关的问题,或者确认一个细节
旁路对话结束后不影响主线的上下文
适合:主线任务进行到一半,临时需要确认某个问题,但不想把这段问答混入主线历史。因为每一条消息都算 Token,把不相关问答塞进主线是对上下文的浪费。
方法 5:/new——彻底新起点
/new/new 描述:start a new chat during a conversation(在对话中开始一个新对话)。
执行后:
当前 session 被归档(可以用
/resume找回)在同一个工作目录开一个全新 session,上下文清空
适合:当前任务已经完成,要切换到一个完全不相关的新任务。不需要把上一个任务的历史带到下一个任务里。
/new和/compact的区别:/new是扔掉历史另起炉灶,/compact是压缩历史继续同一个任务。
方法 6:/memories + AGENTS.md——预防而非应急
以上五种都是应急手段,真正减少上下文压力需要从源头入手。
/memories:持久化关键信息
/memories/memories 描述:configure memory use and generation(配置记忆的使用和生成方式)。
Codex 的 Memories 功能会把你在对话中提到的关键约束(代码规范、偏好、项目背景)单独存储,下次新开会话时自动注入,不需要每次重复说明,也不占当前会话的 Token 预算。
v0.164.0 把 memory extension 的资源保留期延长到 14 天(Extend memory extension resource retention to 14 days),意味着跨会话记忆更持久。
AGENTS.md:系统提示层面减少冗余
在项目根目录创建 AGENTS.md:
/initAGENTS.md 是 Codex 的系统级指令文件,在会话开始时一次性注入,相当于把"你总是要反复交代的背景"变成结构化文档,避免在每个会话里重复说明同样的事情。保持 AGENTS.md 简洁——越短,消耗的首轮 Token 越少。
实用技巧:把重复出现在对话里的高频约束(测试框架、目录结构、禁止操作的路径)写进 AGENTS.md,从源头压缩每个会话的起点。
六种方法选哪个:一张决策路线图
/recap 和 /status:辅助判断当前状态
两个辅助命令,帮助判断是否需要处理上下文:
/recap:描述是"summarize the current conversation now",立即输出当前对话摘要(不改变历史),可以用来确认 Codex 对任务的当前理解是否准确/status:描述是"show current session configuration and token usage",显示当前 session 配置和 Token 用量,可以看到还剩多少空间
建议在觉得模型"开始忘事"之前先跑一下 /status 看 Token 用量,决定是压缩还是分叉。
总结
Codex 上下文爆满的处理路径:应急用 /compact(压缩历史)或 /fork(保留历史分叉),需要文件隔离用 /worktree,临时问题用 /side,彻底换任务用 /new,长期减压用 /memories 和 AGENTS.md。命令来源为 Codex CLI 官方代码库(openai/codex,v0.164.0,2026-10-23),各命令描述直接引用 slash_command.rs,截至 2026-10-26 以官方发布为准。
延伸阅读
OpenAI Codex GitHub:github.com/openai/codex
Codex 官方文档:developers.openai.com/codex
Codex 斜杠命令文档:developers.openai.com/codex/cli/slash-commands
AGENTS.md 指南:developers.openai.com/codex/guides/agents-md
七牛云 Token Plan(多模型 API 统一接入):https://www.qiniu.com/ai/plan