AI与智能服务
未读
LM Arena吞吐实测:推理模型选型指南
面对海量并发请求,企业在自有服务器上运行大模型往往会遭遇严重的显存瓶颈与延迟问题。很多技术团队在跑通了简单的测试节点后,一旦接入真实的生产环境,系统吞吐量就会断崖式下跌。这时候,一份详尽的LM Arena吞吐实测:本地代码推理模型性能对比与选型指南就成了刚需。到底用哪个框架才能榨干GPU的每一滴算力

AI与智能服务
未读
昆仑芯vs天数智芯实测:字节Doubao私有化部署底座选型指南
企业在接入大模型时,数据安全往往是不可跨越的红线。字节跳动的Doubao模型凭借出色的逻辑推理与文本生成能力,成为众多企业内部知识库改造与智能客服升级的优选。然而,当面临实际落地时,动辄百万的传统GPU集群采购成本让不少IT团队望而却步。为了寻找真正可落地的替代方案,技术团队通常会将目光转向国产算力
AI与智能服务
未读
DeepSeek- V4高性能推理与API调用方案:从百万上下文到企业级Agent架构
当开发者试图让大模型一次性吞下整座开源代码库或是几十万字的行业研报时,传统的推理架构往往会因为显存溢出或极高的首字延迟而崩溃。面对这种极端的长文本处理需求,DeepSeek- V4 凭借其底层注意力机制的优化,成为了突破瓶颈的利器。要真正释放这款模型的潜力,仅仅依靠本地部署是远远不够的,构建一套稳定
AI与智能服务
未读
七牛云GPT-5.5大模型高效推理与集群调度核心方案解析
企业在引入千亿参数级前沿模型时,往往被高昂的算力开销和长文本处理的极高延迟所困扰。GPT-5.5 的问世虽然在逻辑推理、多模态理解和长文本分析上实现了质的飞跃,但其庞大的参数量也对底层基础设施提出了严苛的物理要求。为了打破算力与存储瓶颈,企业急需一套能够兼顾高性能与经济性的底层架构。 七牛云针对这一
AI与智能服务
未读
MiMo- V2.5正式开源:全模态推理部署指南
企业级全模态应用的落地往往伴随着极高的算力门槛与复杂的工程调优。开发者在处理图文混排、长音频解析以及复杂逻辑推理时,常常被显存溢出和响应延迟折磨。小米MiMo-V2.5全模态大模型的发布打破了这一技术瓶颈。就在今日,MiMo- V2.5正式开源,这不仅是一次底层参数的迭代,更是对多模态交互范式的全面
AI与智能服务
未读
微软 GitHub Copilot 宣布转向按量计费:开发者如何打好算力保卫战?
习惯了每月固定订阅费用的开发者们,最近可能要重新审视自己的账单了。微软 GitHub Copilot 宣布转向按量计费,这一决策无疑在开发者社区投下了一枚重磅炸弹。过去那种“无限量代码补全”的自助餐模式正在悄然终结,取而代之的是精打细算的 Token 消耗战。这种转变不仅关乎个人开发者的钱包,更折射
AI与智能服务
未读
DeepSeek V4 接入 Hermes Agent 完整指南:三种方式 + Thinking 模式 + 国内直连
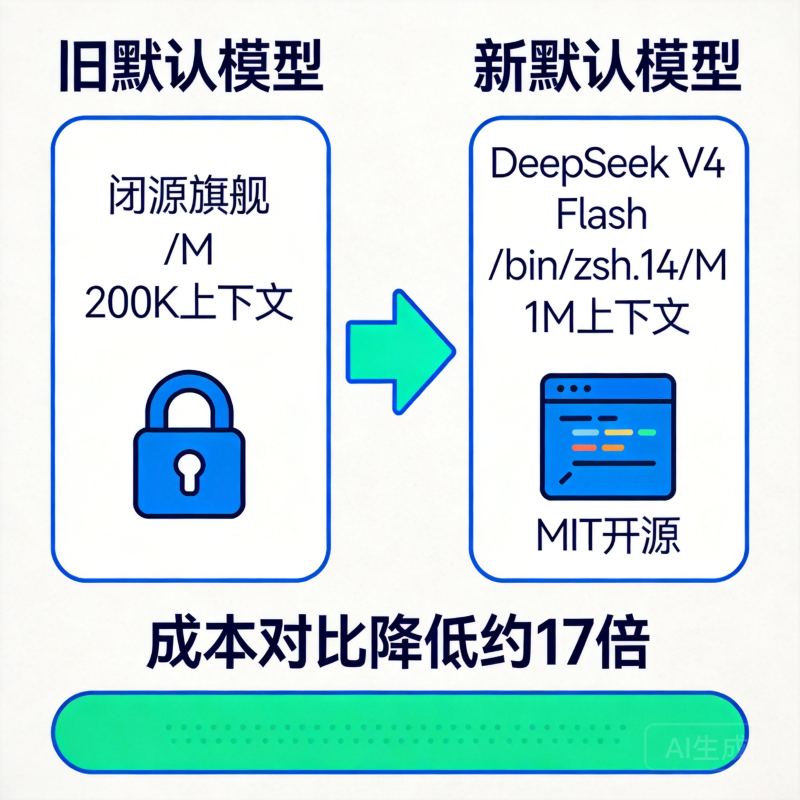
Hermes Agent(NousResearch,118k GitHub Stars,MIT 开源)是目前社区最活跃的自主 AI Agent 框架之一,支持 24+ 模型供应商、15+ 通信渠道、自主技能创建和跨会话记忆。 将 DeepSeek V4 Flash($0.14/M,1M 上下文,MI
AI与智能服务
未读
DeepSeek V4 深度解析:1.6T 开源 MoE,1M 上下文,架构全面革新
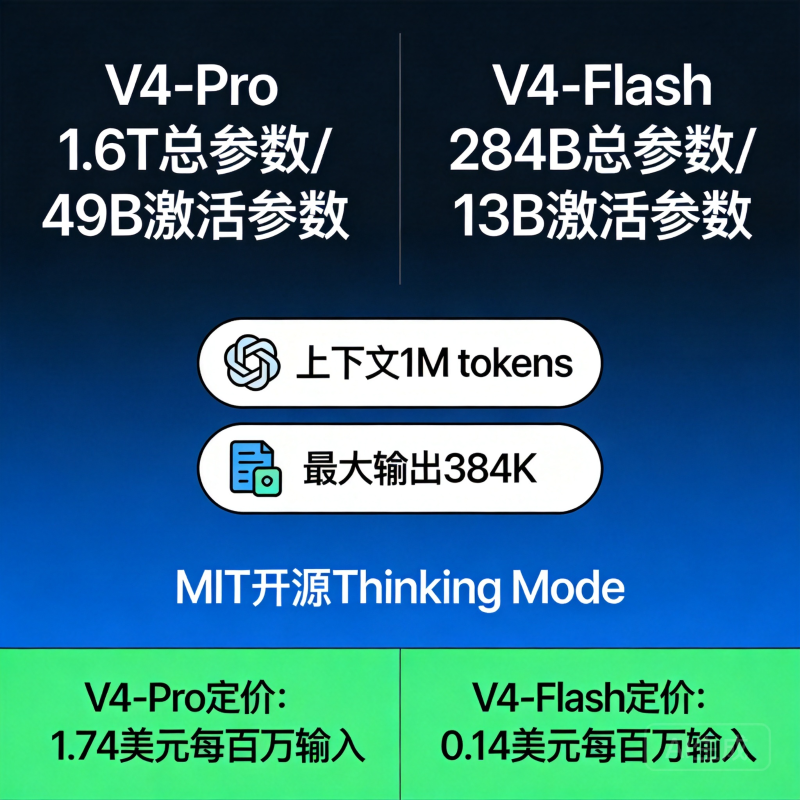
DeepSeek(深度求索)于 2026 年 4 月发布 V4 系列:V4-Pro(1.6T 总参数 / 49B 激活参数)是目前全球最大的开源 MoE 模型,超过 Kimi K2.6(1.1T)和 GLM-5.1(754B);V4-Flash(284B 总参数 / 13B 激活参数)以 $0.14
AI与智能服务
未读
从 GPT-5.4 到 GPT-5.5:编程能力质的飞跃、100 万 token 上下文与自我优化——版本迭代完全解读
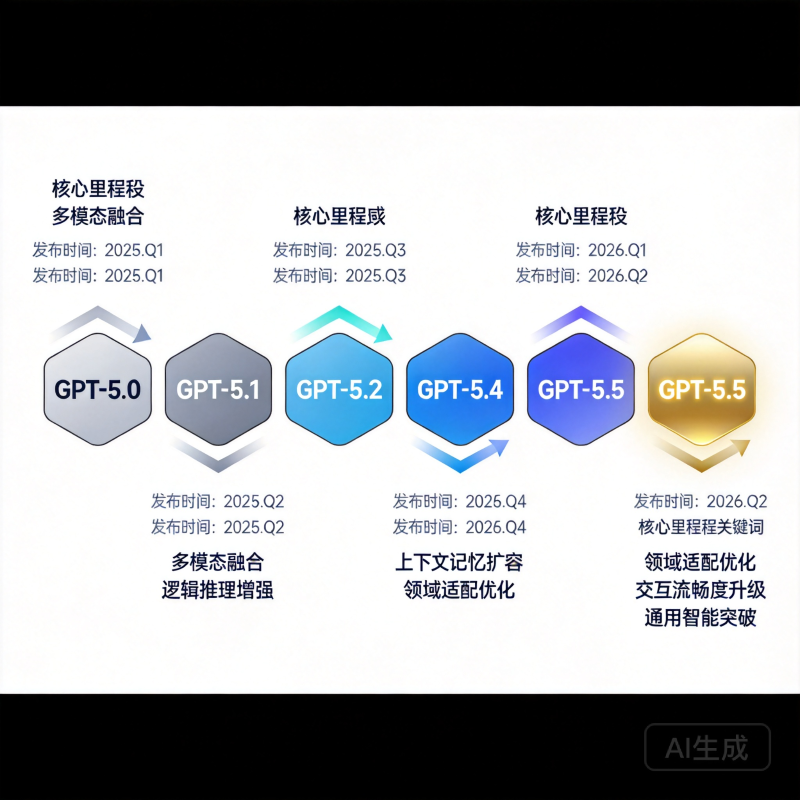
GPT-5.5 是 OpenAI 于 2026 年 4 月 23 日发布的新一代旗舰模型,距 GPT-5.4 发布仅 7 周,是自 GPT-4.5 以来首个从零完整重训的基础模型。 这次版本升级有三个在工程实践中真正重要的改变:编程 Agent 能力的质变(Terminal-Bench +7.6pp