AI与智能服务
未读
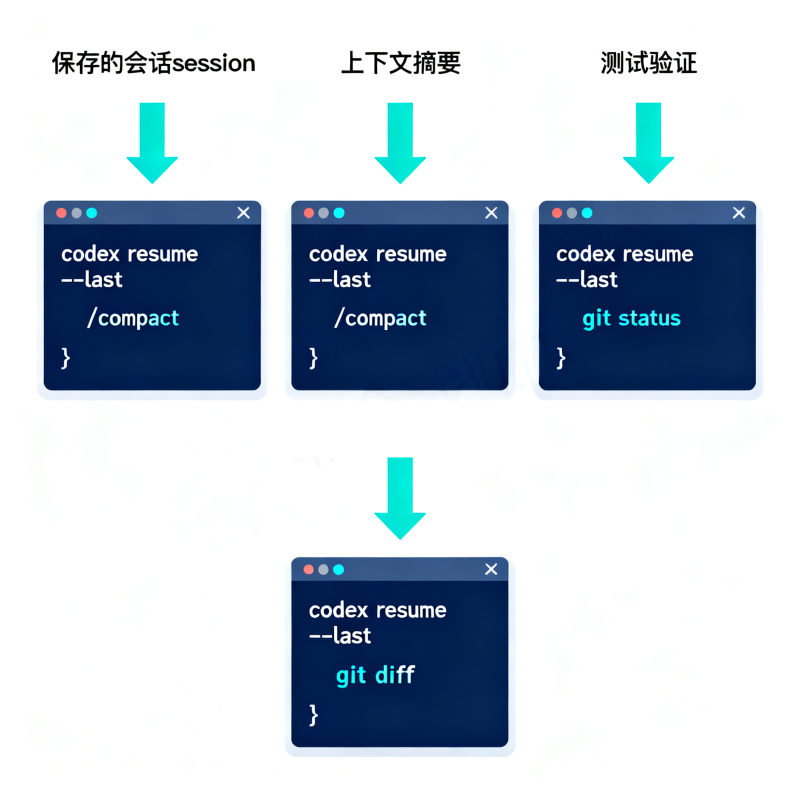
Codex 长任务中断怎么办:恢复会话、排查重连与减少丢进度
Codex 长任务中断,是任务执行过程被网络、客户端、审批、上下文或本地进程打断后没有继续输出;它不等于代码一定丢失。恢复的核心顺序是保留原会话、确认最后一个可验证状态、区分“任务暂停”和“进程退出”,再决定使用 resume、compact、/ps 或云端后台任务;截至 2026-08-27,Op
AI与智能服务
未读
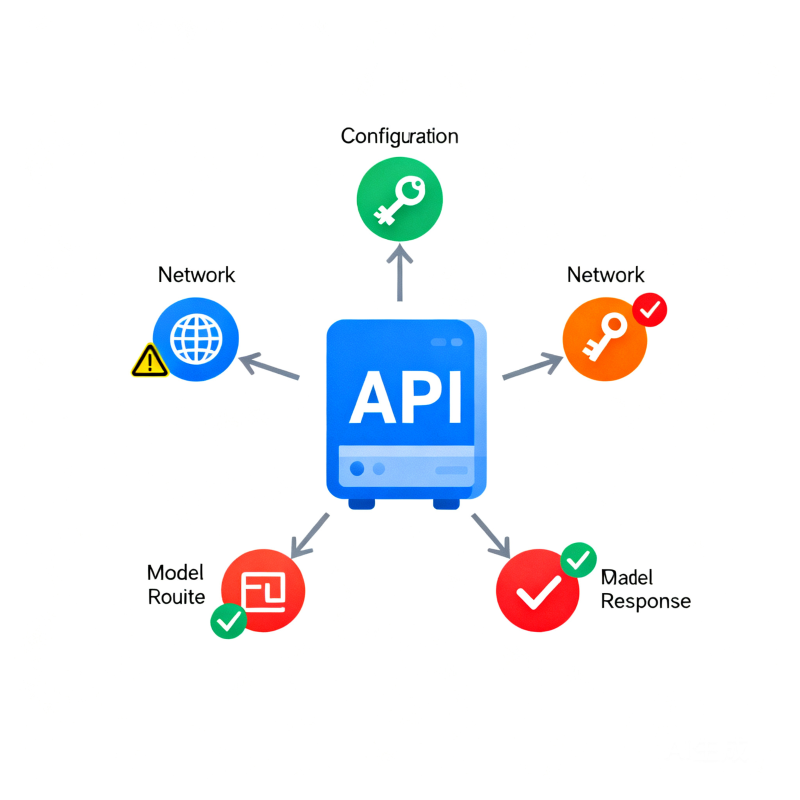
WorkBuddy 自定义模型接入失败:从接口、鉴权到协议兼容的完整排查指南
WorkBuddy 自定义模型接入失败,通常不是“模型不能用”,而是请求没有正确到达兼容接口,或接口返回格式无法被 WorkBuddy 识别。最有效的排查顺序是:先用 curl 验证网络和 API Key,再核对完整端点与模型 ID,最后检查工具调用、图片输入、思考模式和上下文参数。本文将常见现象映

AI与智能服务
未读
Qwen3.8-Flash-Next开源首发:SGLang与vLLM实战部署全攻略
发布日期:2026-08-27 Qwen3.8-Flash-Next 是通义千问团队于 2026 年 8 月 26 日开放权重的多模态 MoE 模型,也是 Qwen4 预览版。它由 125B 模型和 51B N-gram Embedding 组成,单 token 激活约 6B,原生上下文 262,1

AI与智能服务
未读
GLM-5.3-Flash部署完整教程:从 API、单机异构到多卡生产服务
智谱在 2026 年发布的 GLM-5.3-Flash 是一款约 320B 总参数、18B 激活参数、支持 1M token 上下文和原生图像/视频输入的混合架构模型。本教程按“先验证、再部署、后压测”的顺序,整理官方 API、Transformers、SGLang、vLLM 与 KTransfor

AI与智能服务
未读
神秘“牛来”模型真身揭晓:GLM-5.3-Flash 到底有多强
GLM-5.3-Flash 是智谱于 2026 年 8 月发布并开放权重的 GLM-5 系列首个原生多模态模型,此前以 ox-alpha 身份在 OpenCode 和 OpenRouter 接受匿名测试。它采用 320B 总参数、18B 激活参数的 MoE 架构,将线性注意力与稀疏注意力结合,在支持

AI与智能服务
未读
Qwen3.8-Flash 发布:先看懂 Flash-Next,再决定如何部署
Qwen3.8-Flash 于 2026 年 8 月 26 日进入公开发布阶段,但官方资料区分了两个名称:公开权重与架构预览叫 Qwen3.8-Flash-Next,面向生产 API 的 Qwen3.8-Flash 基于该模型并提供默认 1M 上下文与内置工具。本文依据 Qwen Team 的 Gi

AI与智能服务
未读
DeepSeek Harness 如何连接微信:四条路线与扫码接入实操
发布日期:2026-08-26 | 类别:AI 工程实践 | 关键词:DeepSeek Harness、dsh、微信、ClawBot、iLink 核心定义:DeepSeek Harness(dsh)连接微信,是通过社区渠道插件调用微信官方 ClawBot/iLink Bot 协议,把个人微信私聊消息

AI与智能服务
未读
从 80% 到 99.5%:DeepSeek Harness 缓存优化指南
DeepSeek Harness 是 DeepSeek AI 于 2026 年 8 月开源的 Agent Harness,缓存命中指后续模型请求的提示词前缀被提供方缓存读取,从而减少重复的输入处理;官方将命中率定义为 cacheRead / (input + cacheRead + cacheWri

AI与智能服务
未读
DeepSeek V4 接哪个 Agent 效果好?Codex、Harness、Claude Code、WorkBuddy 横向实测对比
核心定义:DeepSeek V4 可通过不同接入方式驱动四类主流 Coding Agent,其中 DeepSeek Harness 为官方自研、协同度最高;Claude Code 经 Anthropic 兼容端点接入后工程能力最完整;Codex 擅长执行类任务但接入路径最绕;WorkBuddy 零门